O GizmoData Cloud agora executa o trabalho ao redor dos seus clusters Hardcharger: jobs agendados que copiam dados para dentro do cluster e executam SQL, Python, PySpark e dbt, notebooks JupyterLab ao lado dos seus dados e conexões salvas com os bancos de dados que você já tem. Tudo isso já está disponível em app.gizmodata.com, e cada execução mostra quanto custaram suas etapas de código.
Jobs com etapas de replicação e SQL, conexões e o restante do que vem a seguir funcionam na AWS, no Google Cloud e no Azure. Etapas Python, PySpark e dbt e notebooks são executados onde um plano de dados os oferece: hoje, isso é na AWS US East 2 (Ohio). Esses são recursos do Hardcharger; os clusters GizmoSQL continuam funcionando como antes.
Agende seus pipelines
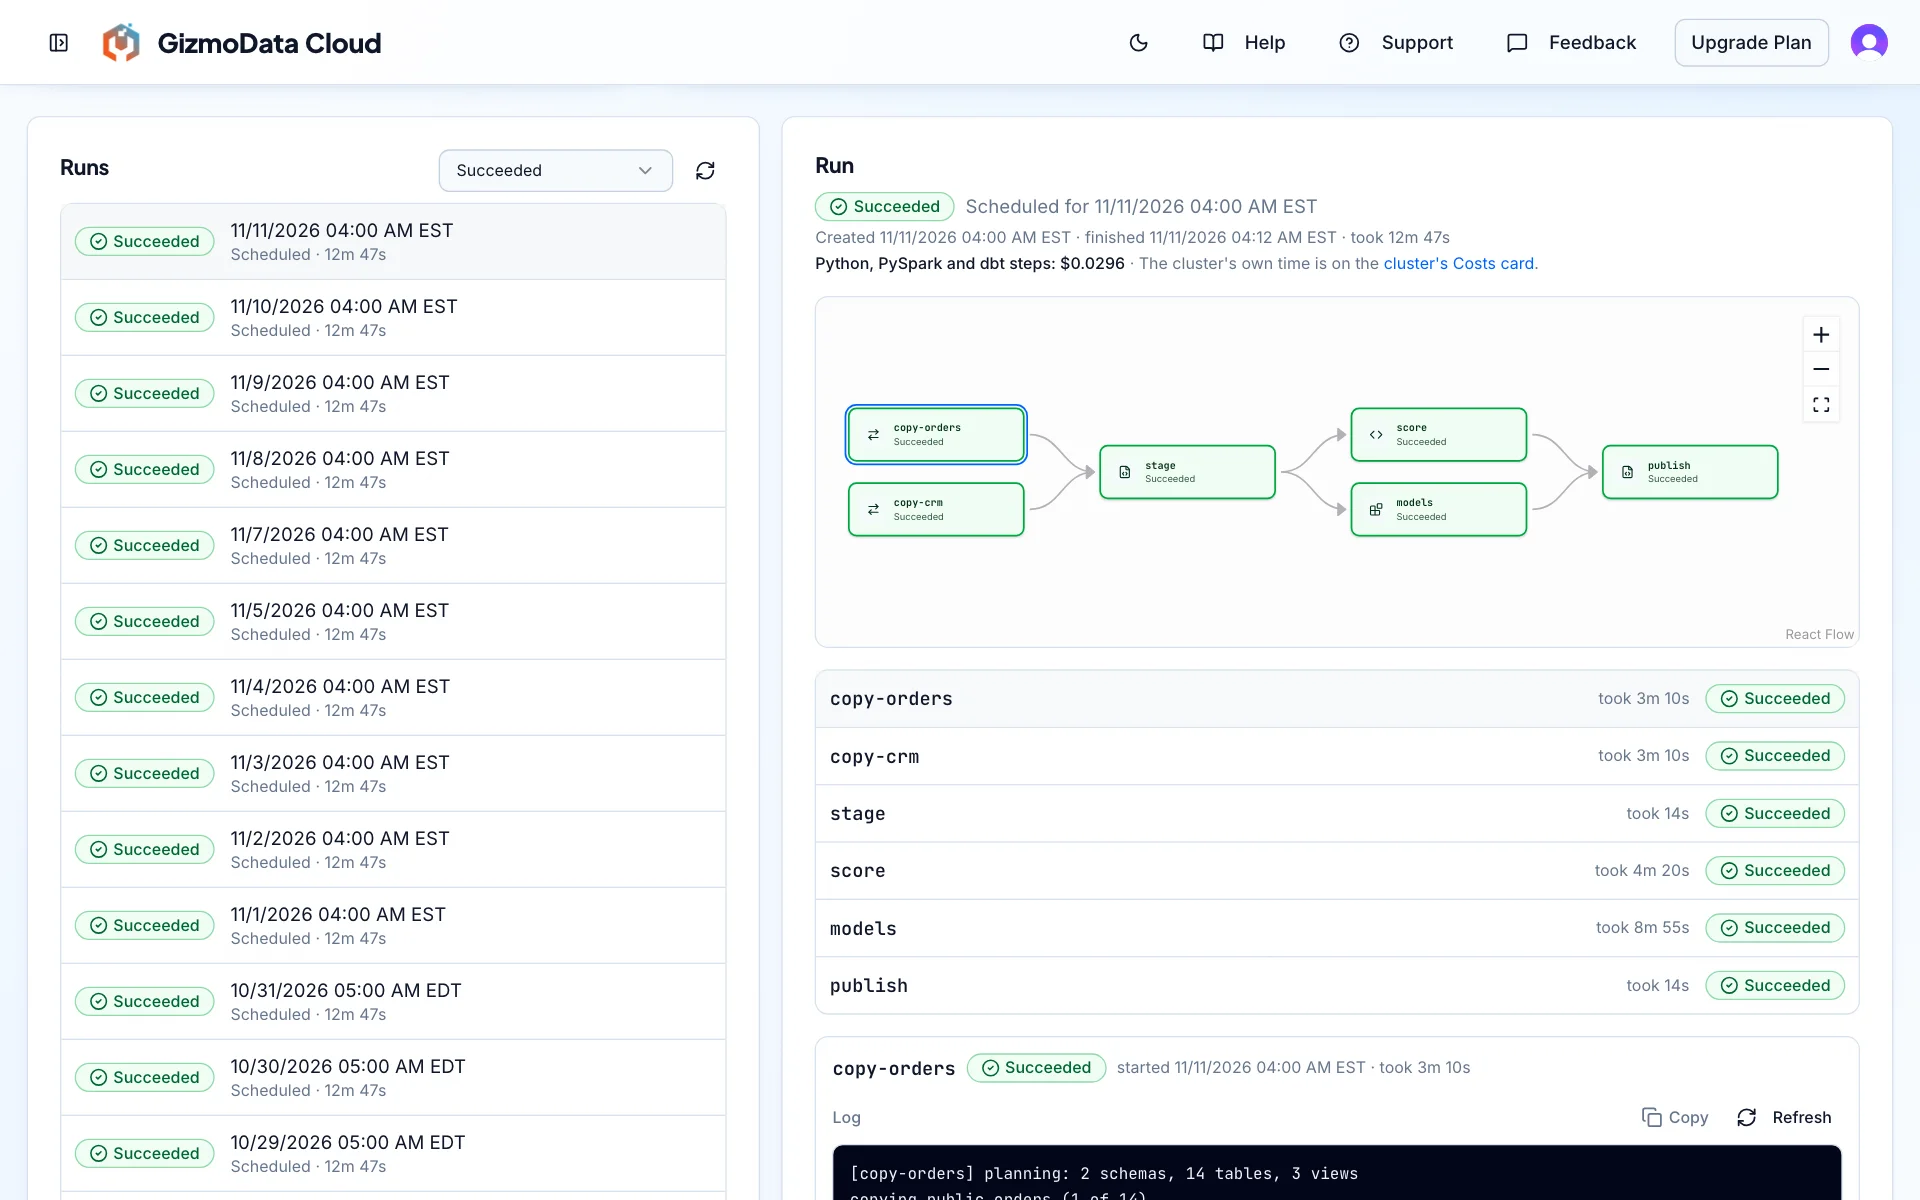
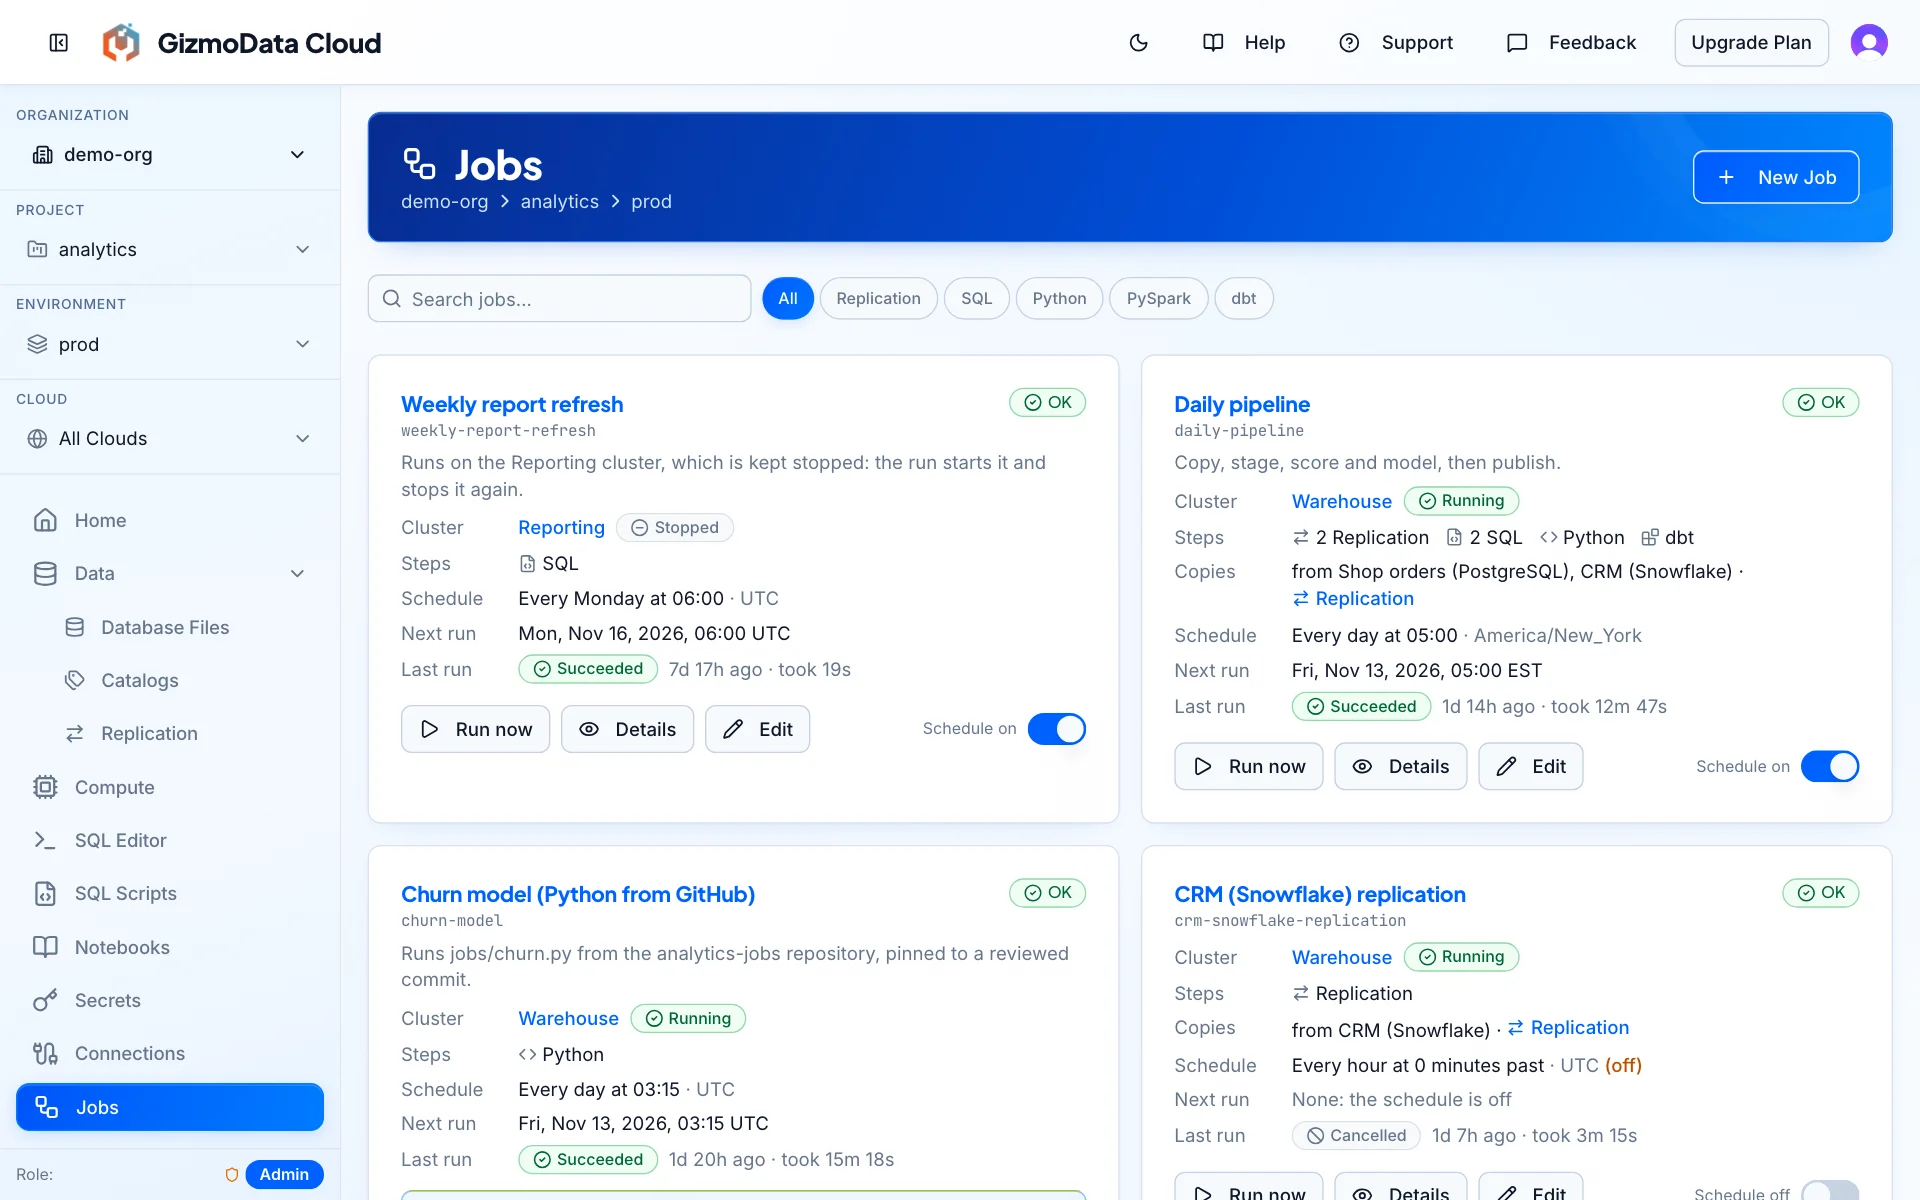
Um job é um conjunto de etapas que você desenha como um grafo em um cluster Hardcharger. Cada etapa começa depois que as etapas anteriores a ela terminam com sucesso, e as etapas que não esperam por nenhuma outra são executadas lado a lado. Há cinco tipos de etapa: Replication, SQL, Python, PySpark e dbt. Execute um job em um agendamento, no fuso horário que você escolher, ou quando quiser com Run now.
Etapas Python e PySpark executam seu próprio código, digitado na etapa ou obtido de um repositório GitHub, com uma conexão ao cluster já autenticada, então nenhuma senha vai no código. Uma etapa dbt executa um projeto dbt Core de um repositório GitHub, e a plataforma escreve o perfil de conexão para você. Cada execução guarda seu histórico e seus logs ao vivo, e sua organização pode receber uma mensagem no Slack quando um job começa a falhar e quando volta a funcionar. Uma execução inicia um cluster que parou por ociosidade; com Start the cluster if it is stopped ativado, ela também inicia um cluster que uma pessoa parou e o para novamente quando a execução termina. Seu código roda em máquinas próprias, separado das outras organizações.
Mantenha os dados sincronizados
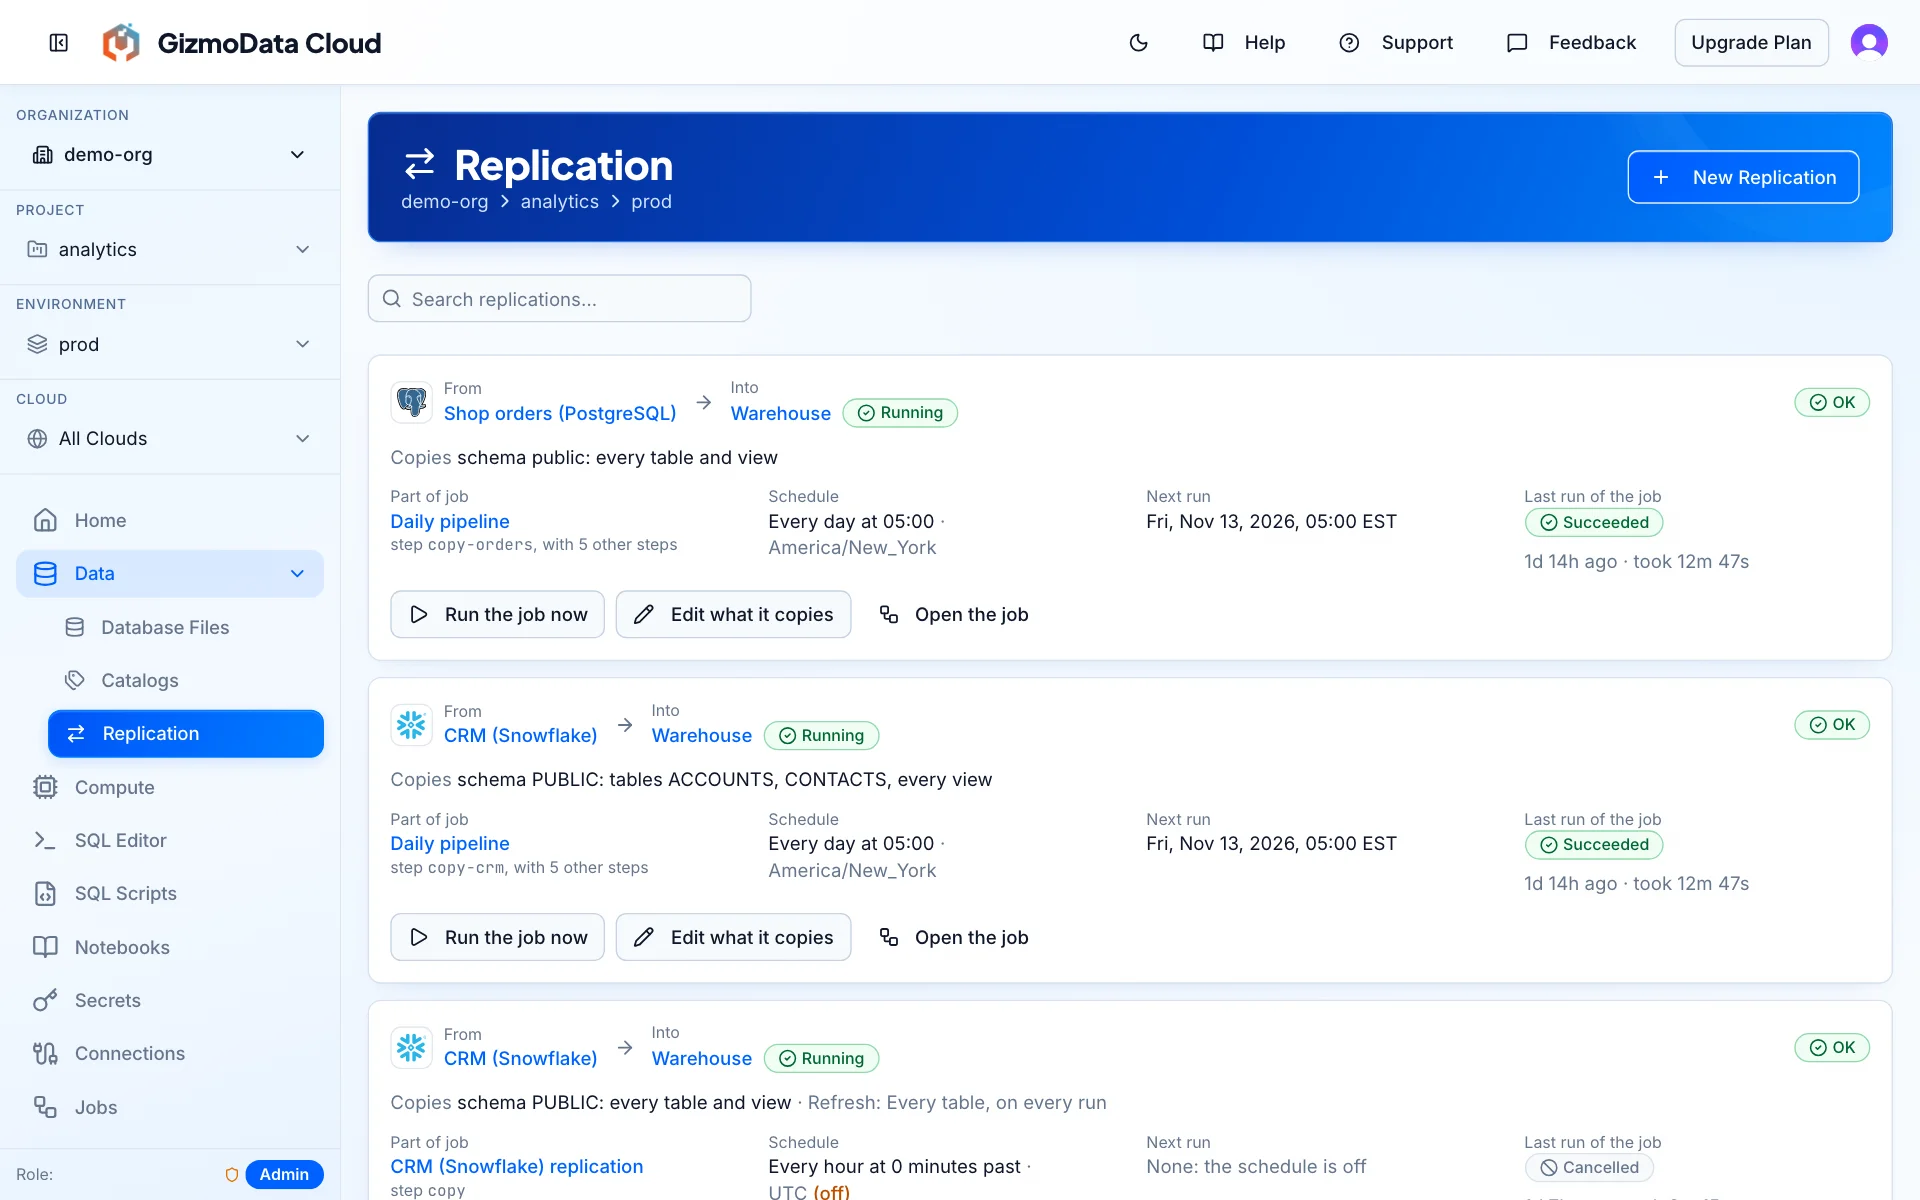
A replicação copia tabelas e views de PostgreSQL, Oracle Database, Snowflake ou outro servidor Hardcharger para um cluster Hardcharger e mantém a cópia atualizada em um agendamento. Escolha schemas, tabelas e views por padrão, e Plan mostra o que uma execução copiaria antes que qualquer coisa seja copiada. Deixe colunas de fora ou mascare-as com um hash SHA-256 ou um valor vazio: as máscaras são aplicadas no banco de dados de origem, então os valores reais nunca saem dele. As views são recriadas no cluster, com seu SQL traduzido para ele.
Cada replicação é uma etapa de um job, então etapas SQL ou dbt podem ser executadas logo depois da cópia. A nova página Data > Replication lista cada replicação com sua origem, seu cluster, seu agendamento e como foi sua última execução.
Trabalhe em notebooks ao lado dos seus dados
Inicie uma sessão JupyterLab ao lado de um cluster Hardcharger e ela abre em uma nova aba, já autenticada no cluster como você, com o seu próprio acesso a ele. Ela tem um kernel Python e um kernel PySpark (as operações de DataFrame do PySpark são executadas no próprio cluster, sem nenhum cluster Spark para iniciar), células %%sql e Git. Seus notebooks, dados e os pacotes Python que você instalar ficam em um workspace no cluster para a próxima sessão, e o JupyterLab traz as cores e o logotipo do GizmoData Cloud, para que uma aba de notebook seja fácil de distinguir.
Um workspace novo começa com uma pasta Examples: um quickstart em Python e um quickstart em PySpark. Esta é a primeira consulta do quickstart em Python, em que conn é uma conexão com o seu cluster que já está pronta:
1# Run a query on the cluster and show its rows as a table.
2# Expect five rows: the numbers 1 to 5 and their squares.
3# This is the first statement, so the connection opens here: it can take a few seconds.
4with conn.cursor() as cursor:  # "with" closes the cursor at the end of the block
5    cursor.execute(operation="SELECT range AS n, range * range AS square FROM range(1, 6)")
6    squares = cursor.fetch_arrow_table()  # the rows as an Arrow table: columns with their types
7
8squares.to_pandas()  # the same rows as a pandas DataFrame, shown below the cell
E o mesmo tipo de consulta em uma célula %%sql, que é executada na mesma conexão e mostra o resultado como uma tabela:
%%sql
-- Everything in this cell is SQL, sent to the cluster as written.
-- Several statements may be separated by ";": they run in turn, and the last one's
-- result is shown as a table (a pandas DataFrame).
-- Expect one row: the number of rows and the sum of the squares from 1 to 5 (55).
SELECT count(*) AS numbers, sum(range * range) AS sum_of_squares
FROM range(1, 6)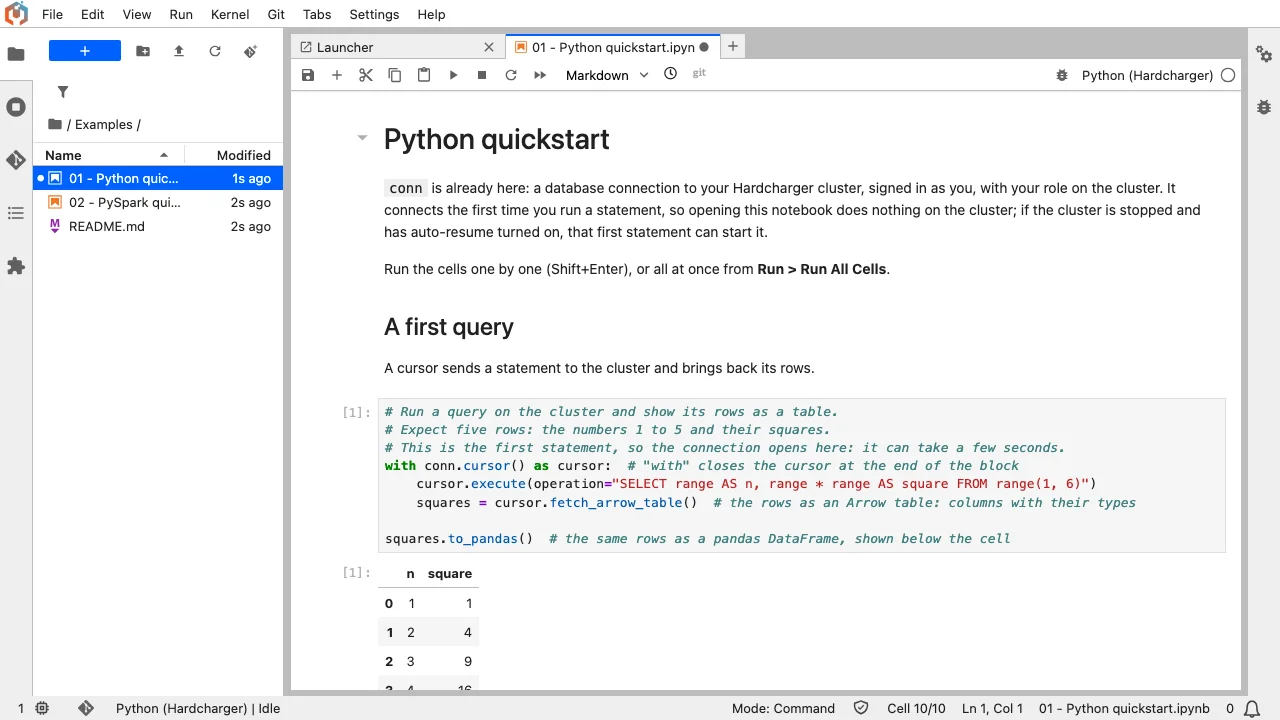
Conecte o que você já tem
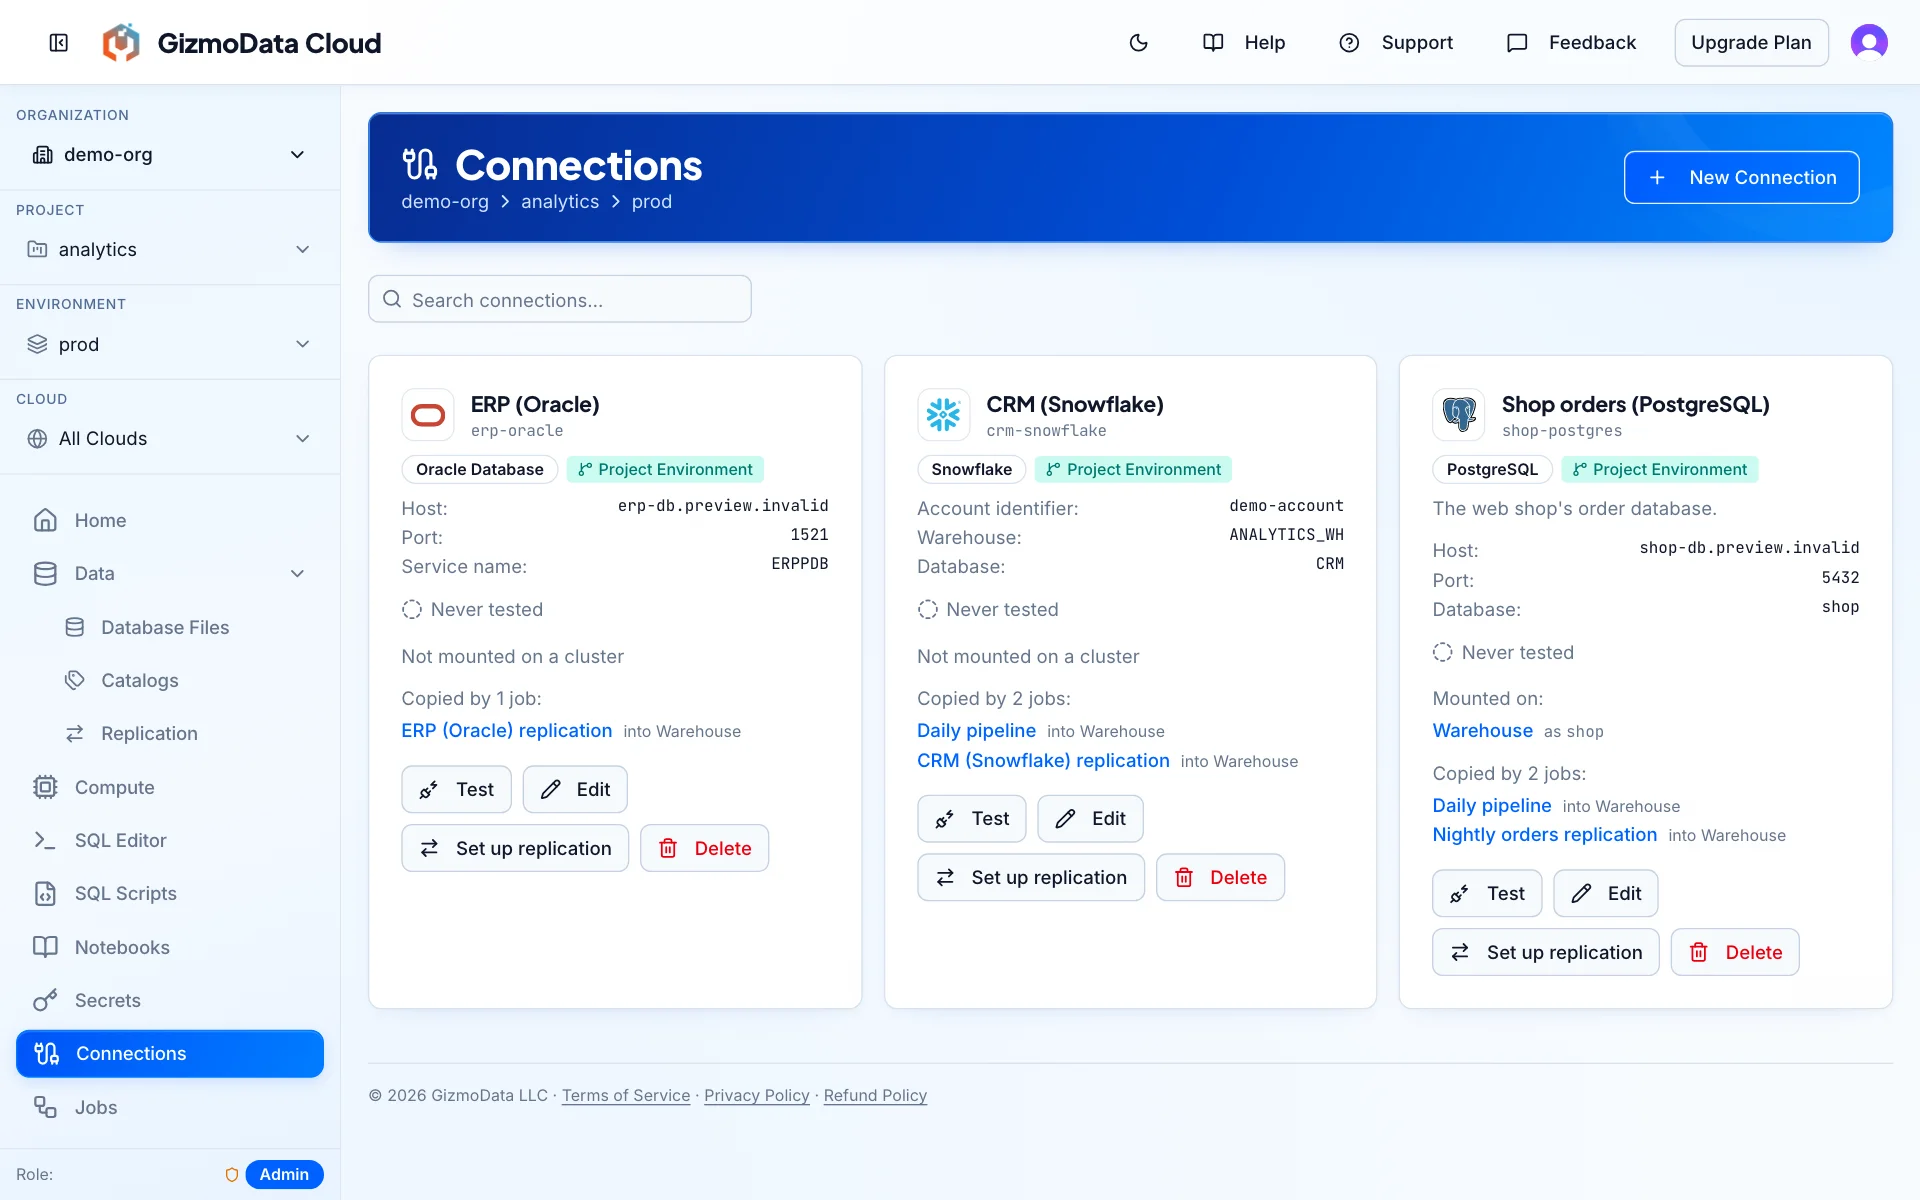
A nova página Connections salva uma única vez uma conexão com PostgreSQL, Snowflake, Oracle Database, IBM Db2, Quack, Hardcharger ou GizmoSQL. Teste-a a partir do seu plano de dados e depois monte-a em clusters Hardcharger e consulte suas tabelas com SQL, ao lado dos seus próprios dados. A mesma conexão pode ser a origem de uma replicação: Set up replication inicia uma a partir do card dela.
Os dados no Amazon S3 também dispensam chaves. Um secret de role da AWS permite que um cluster Hardcharger leia seus buckets S3 por meio de uma role IAM na sua própria conta AWS. Nenhuma chave de acesso é armazenada, e credenciais de curta duração são renovadas automaticamente.
Veja quanto custa
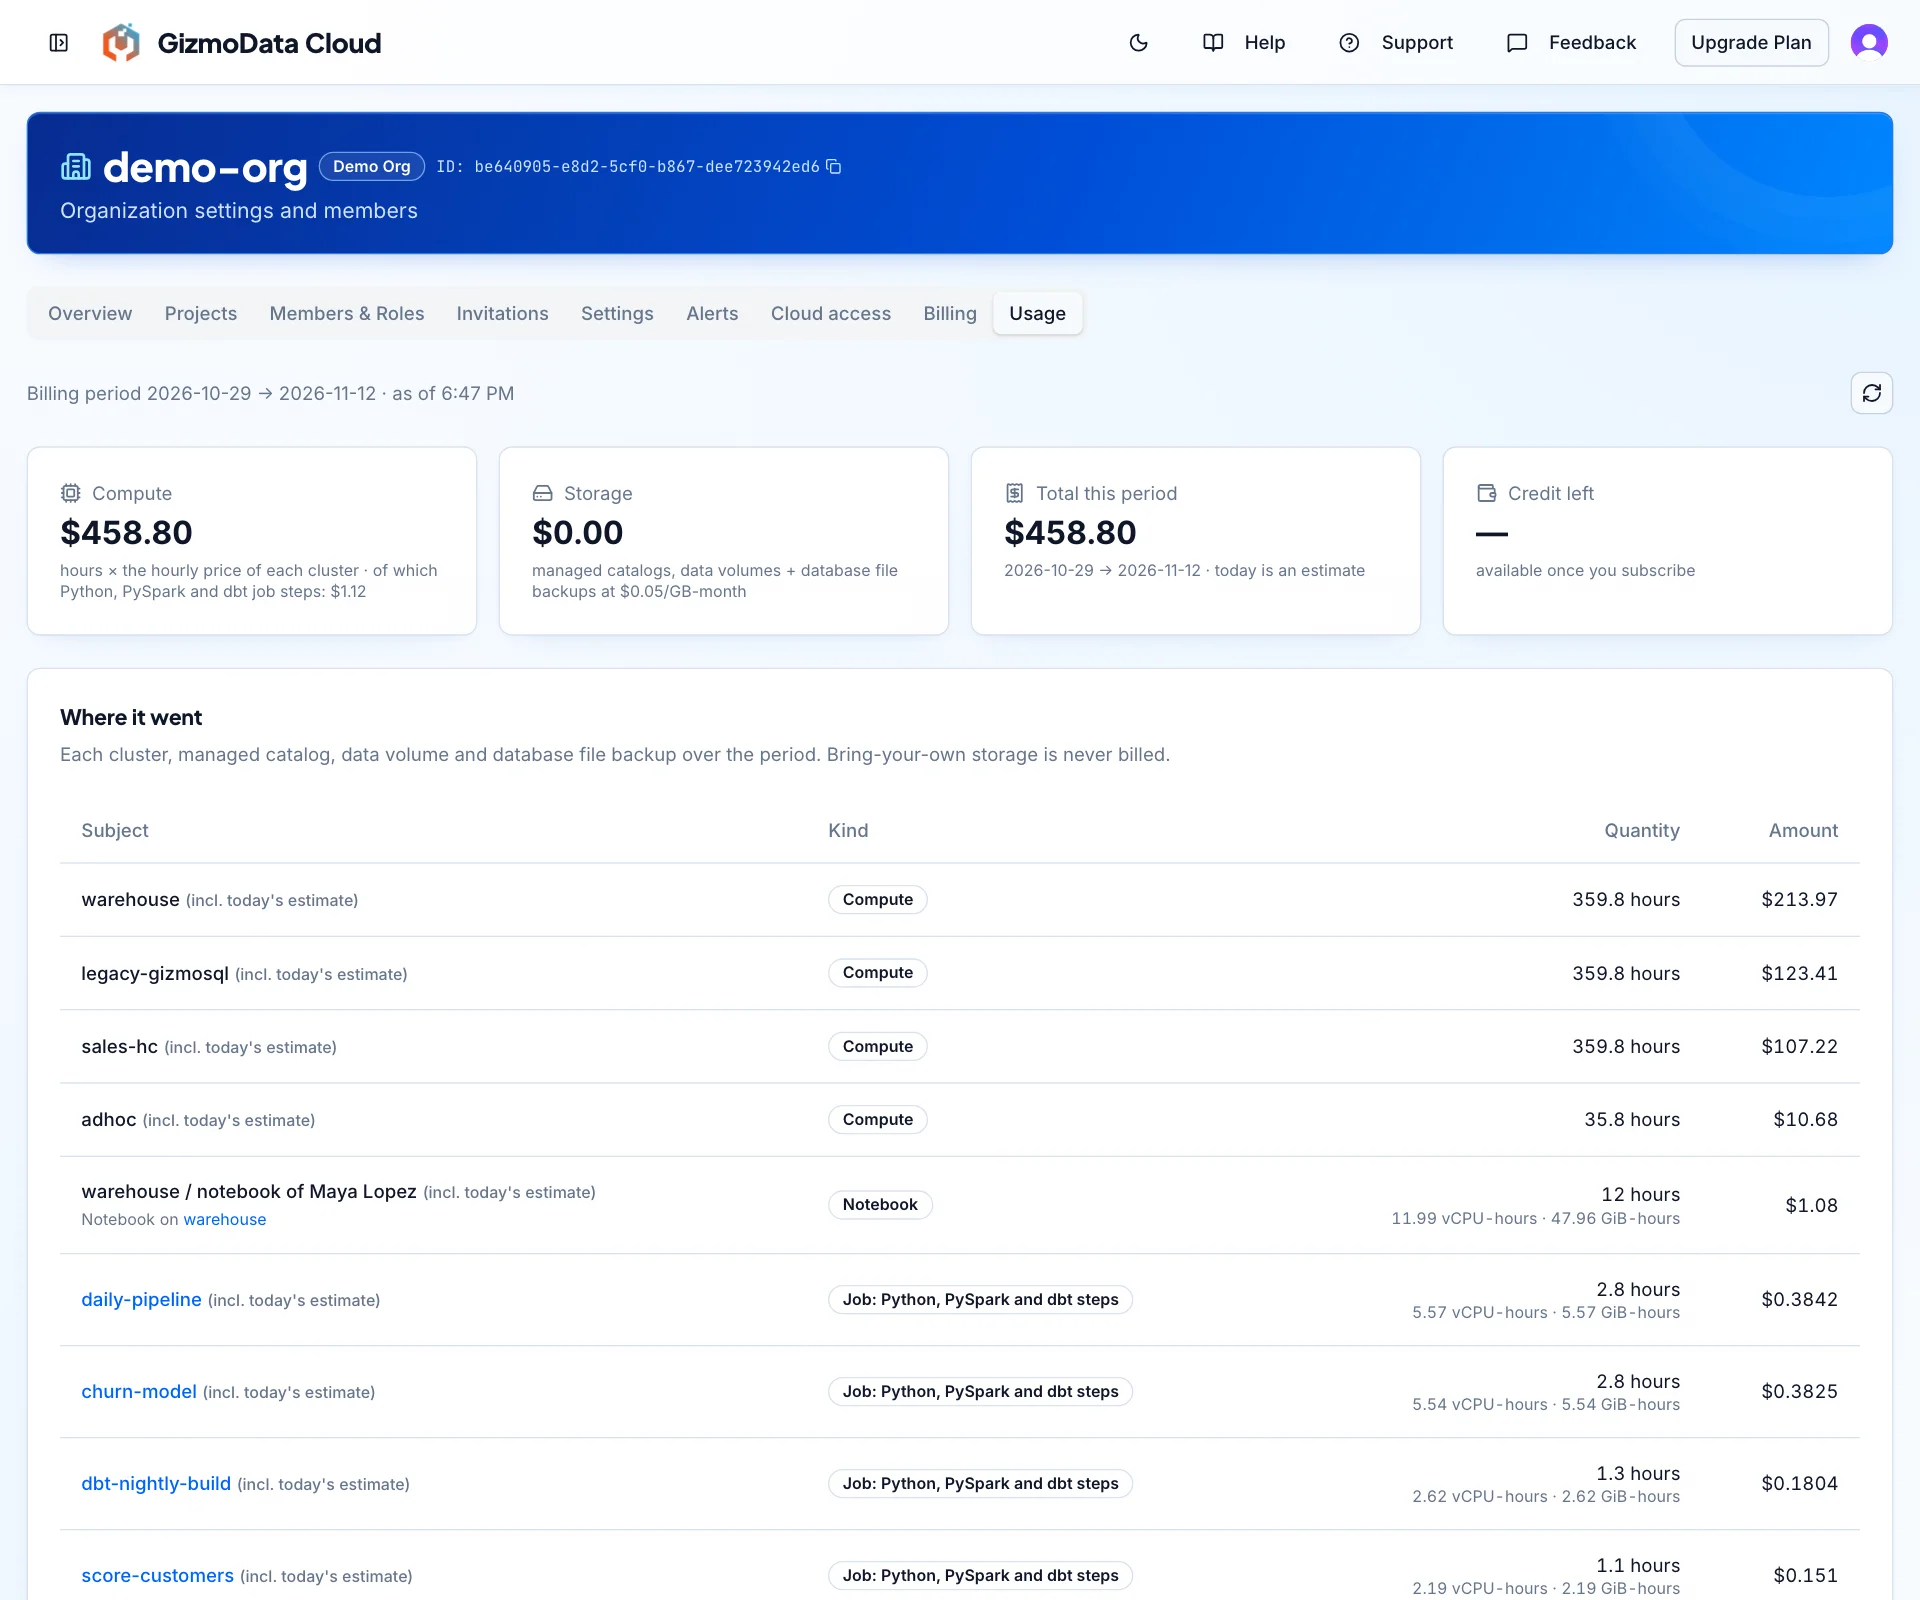
Etapas Python, PySpark e dbt e sessões de notebook são cobradas pelo tempo em que são executadas, por segundo, a US$ 0,062 por vCPU-hora mais US$ 0,007 por GiB-hora do tamanho que você escolher. Etapas de replicação e SQL não têm cobrança própria: o tempo de execução do cluster é cobrado como antes.
O formulário da etapa e a janela do notebook mostram o preço do tamanho que você escolher antes de começar. A página de uma execução mostra o que cada etapa Python, PySpark e dbt usou e quanto custou, a página de um job mostra seus últimos 30 dias, dia a dia, e Organization > Usage tem uma linha para cada job com etapas Python, PySpark ou dbt e para cada sessão de notebook, ao lado dos seus clusters.
Também é novidade: Catalogs, Compute, Connections, Jobs, Replication e as outras listas do portal têm uma caixa de busca que filtra enquanto você digita, e, depois de uma atualização, o portal mostra o que mudou desde a sua última visita. Help > What’s new lista todas as versões.
Experimente
Cadastre-se, crie um cluster Hardcharger e abra Jobs, Notebooks ou Connections no portal. A página do GizmoData Cloud apresenta cada recurso e lista os preços. Queremos saber o que você vai executar nele: participe do Slack da comunidade GizmoData ou fale com a gente.
Jobs agendados, notebooks e conexões já estão disponíveis no GizmoData Cloud.