GizmoData Cloud
A plataforma SQL analítica totalmente gerenciada, por uma fração do custo de um data warehouse na nuvem.
Inicie um cluster em minutos na computação Arm mais recente da AWS, do Google Cloud ou do Azure, conecte as ferramentas que você já usa e pague por hora pelo que executar. Construído sobre o DuckDB e de código aberto na essência.
Comece grátis com US$ 25 de crédito de lançamento, aplicado automaticamente. Sem cartão de crédito — detalhes abaixo.
- Planos a partir de $29/mês, e o valor mensal retorna integralmente como crédito de computação
- TPC-H de 1 TB em 80 segundos, cerca de US$ 0,34 no GizmoData Cloud
- Executado na AWS, Google Cloud ou Azure, ou na sua própria conta de nuvem
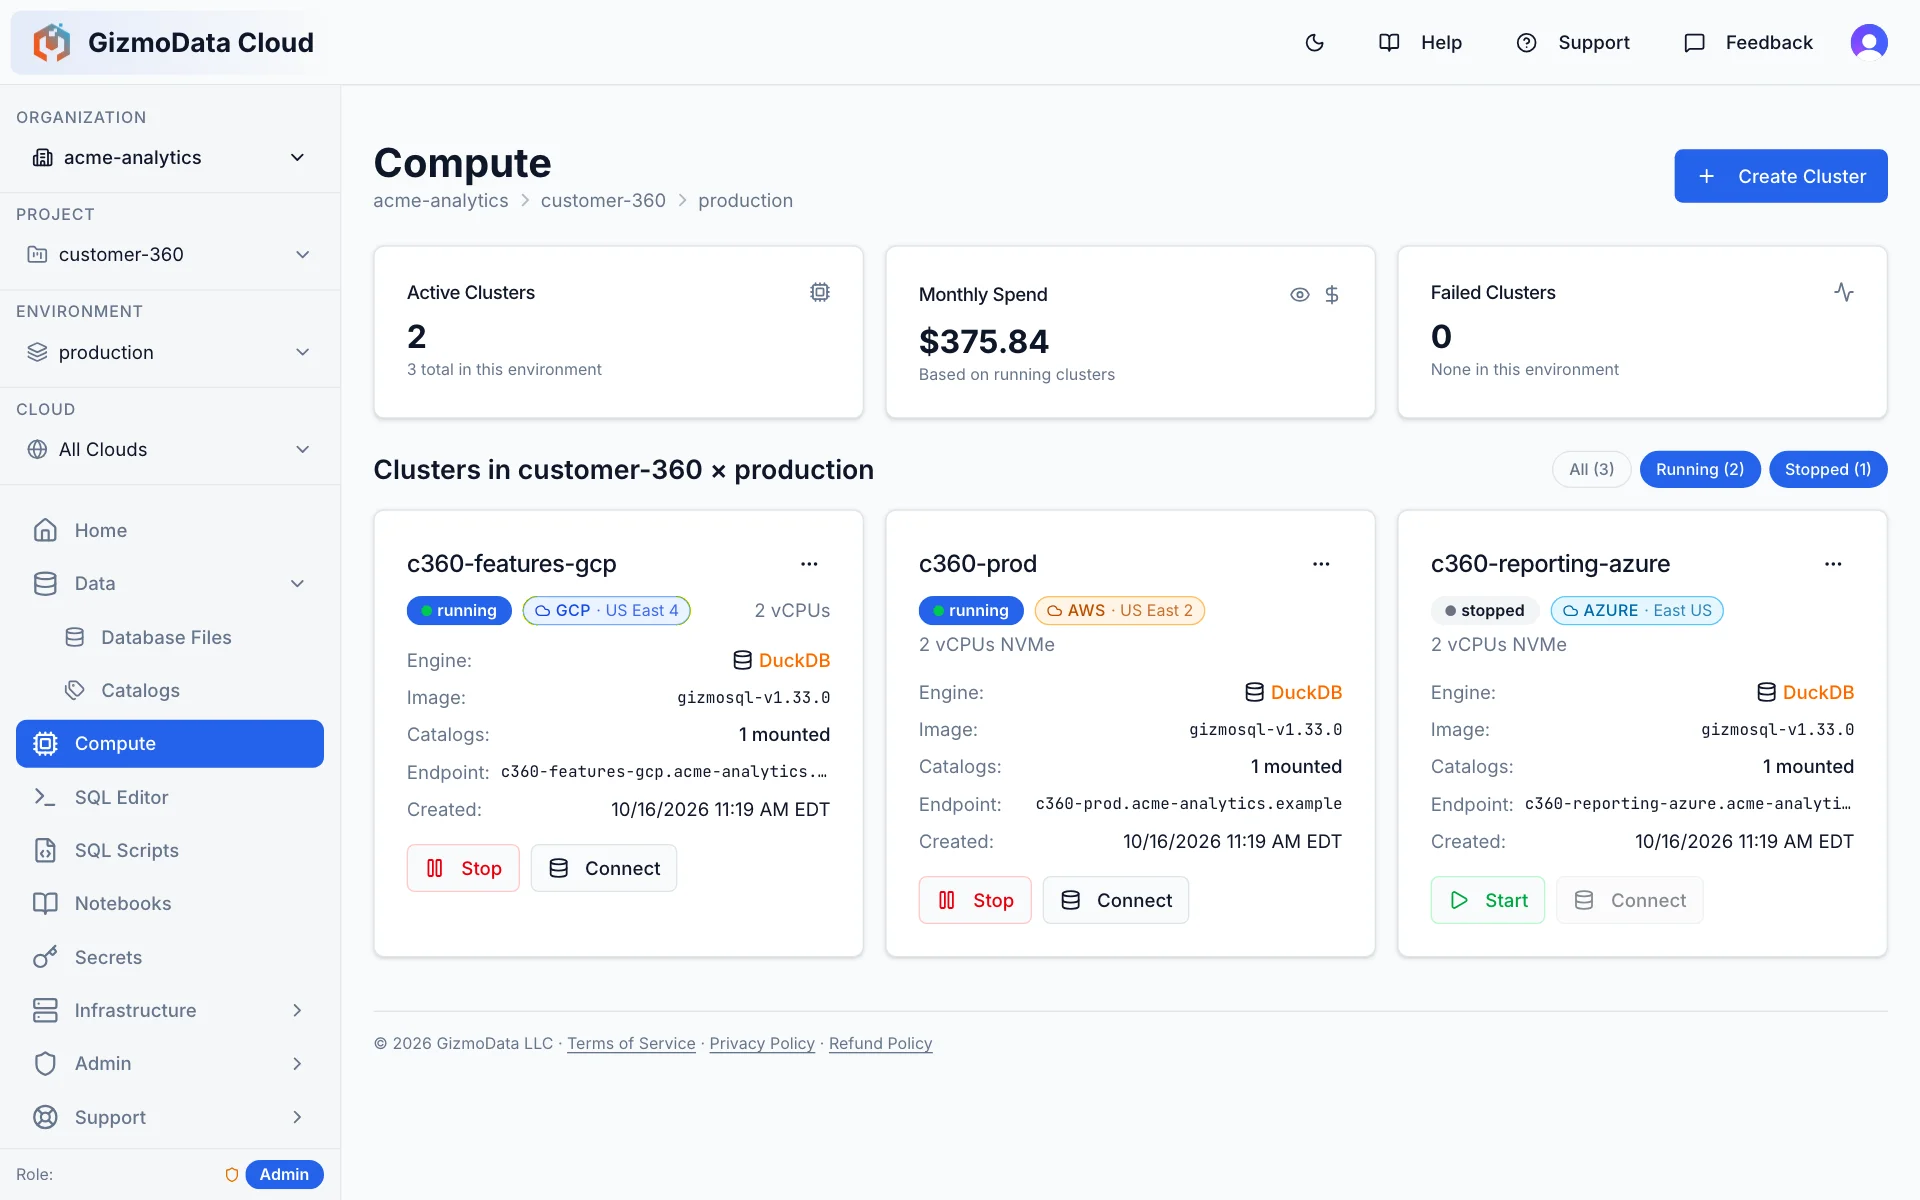
Um ambiente de produção, três clusters GizmoSQL, três nuvens — Google Cloud, AWS e Azure — gerenciados lado a lado.
A computação mais recente para sua carga de dados
O DuckDB executa cada consulta em um único nó; por isso, cada nova geração de processador acelera diretamente suas consultas. O GizmoData Cloud usa os chips Arm mais recentes de cada nuvem — incluindo AWS Graviton 5 — em configurações otimizadas para memória com SSD NVMe local, e adiciona novas gerações conforme são lançadas.
Graviton 5
AWS · r9gd
O processador Arm mais recente da AWS, disponível para uso geral desde agosto de 2026. Executou o benchmark TPC-H completo de 1 TB em 80 segundos em uma única r9gd.24xlarge — 10% mais rápido que o Graviton 4.
Graviton 4
AWS · r8gd
A geração anterior de referência do Graviton: otimizada para memória, com SSD NVMe local. Escolha entre ela e o Graviton 5 por cluster.
Axion
Google Cloud · C4A
Processador Arm próprio do Google. Configurações C4A a partir de 4 vCPUs incluem SSD local para o spill e o espaço temporário do DuckDB; configurações de 1 a 2 vCPUs atendem a cargas leves.
Cobalt 100
Microsoft Azure · Epdsv6
Processador Arm próprio da Microsoft, em configurações Epdsv6 otimizadas para memória com NVMe local.
Escolha a geração e o tamanho por cluster; o preço por hora aparece antes da criação, e uma geração mais nova custa simplesmente o preço das suas máquinas.
Veja o benchmark TPC-H de 1 TB: Graviton 5, Graviton 4 e Cobalt 100O plano de dados vai até seus dados. O plano de controle fica em um só lugar.
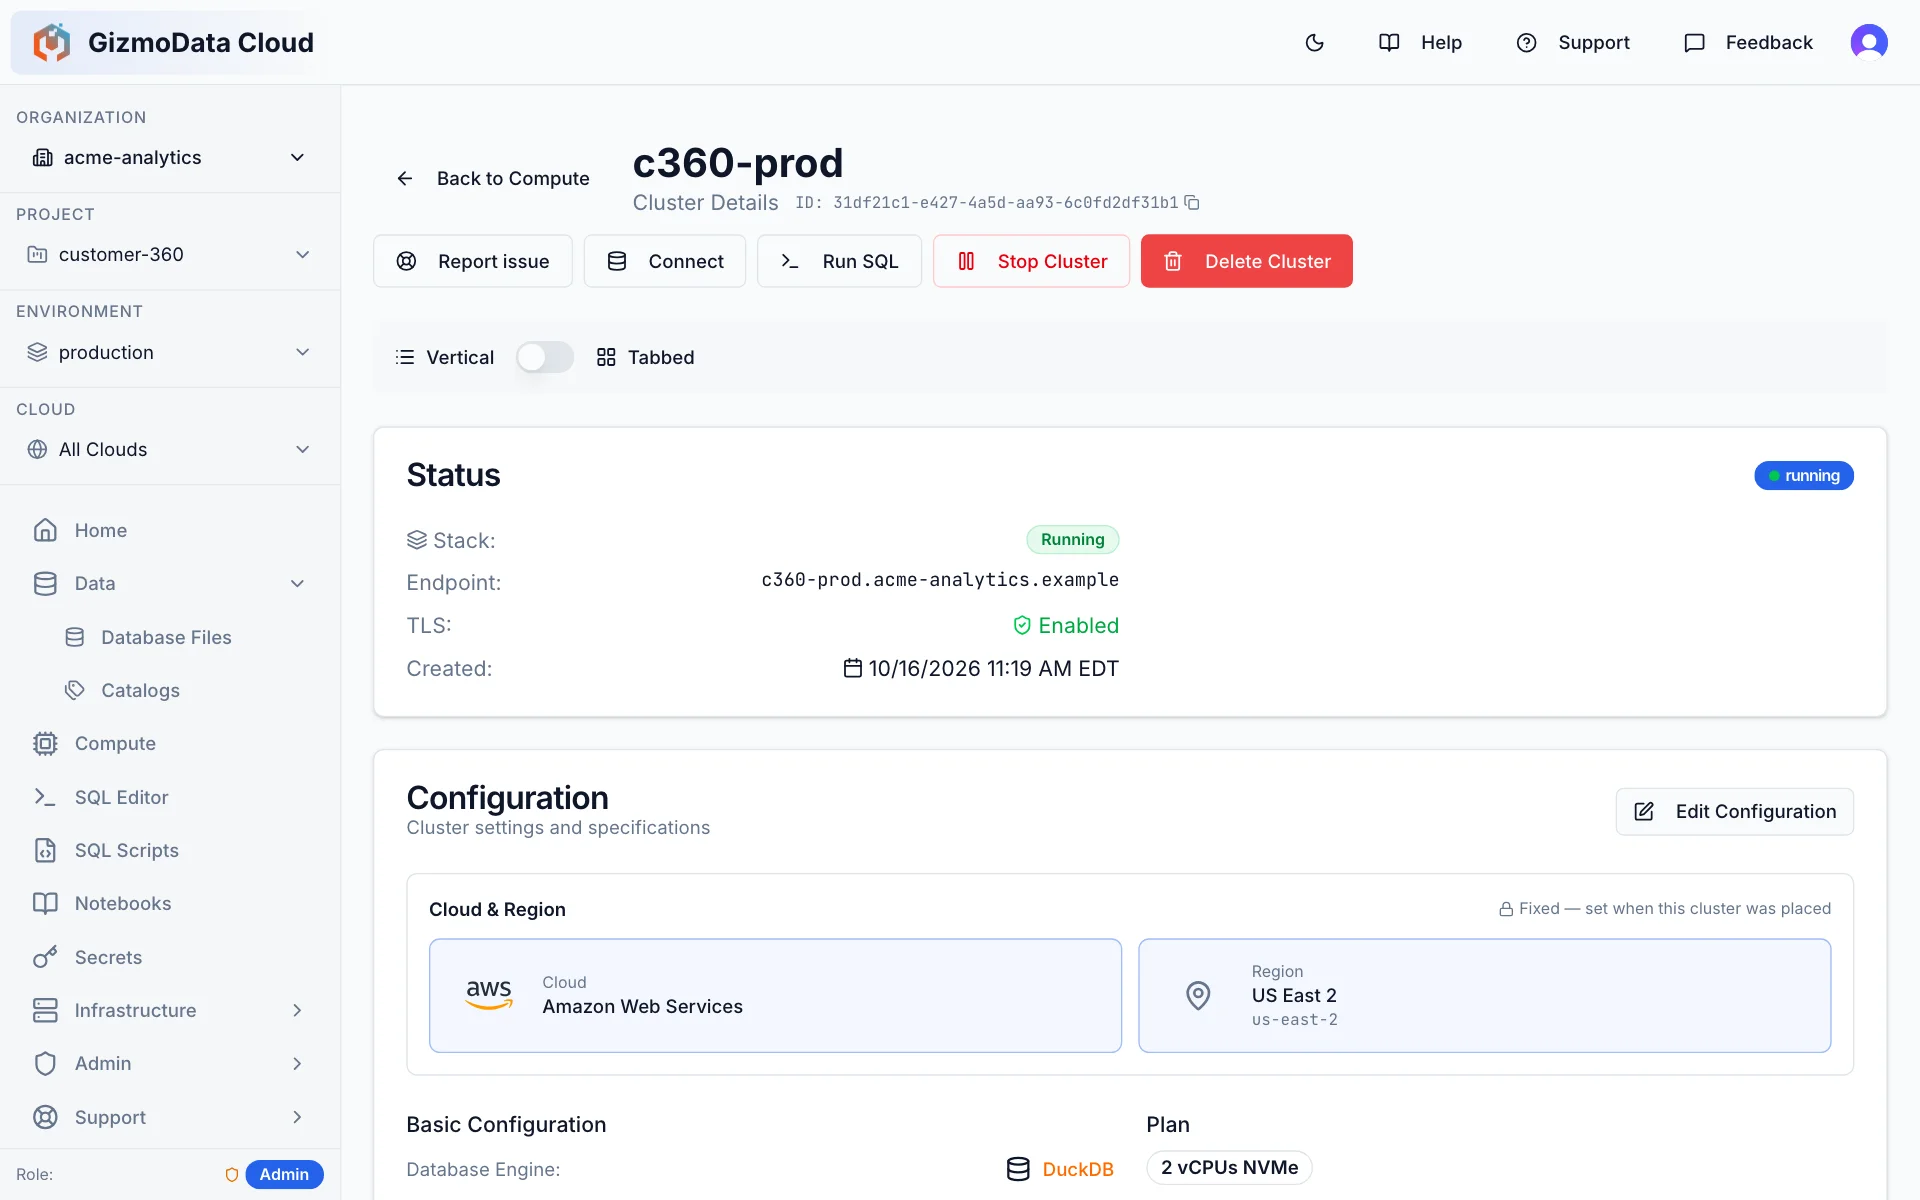
Na maioria das plataformas “multicloud”, há uma implantação por nuvem, cada uma com seu console. O GizmoData Cloud usa um único plano de controle para gerenciar simultaneamente planos de dados Kubernetes na AWS, no Google Cloud e no Azure — assim, um projeto pode ter seus clusters europeus na Irlanda, seu armazenamento de atributos de ML perto do GCS no Oregon e seus relatórios financeiros no Azure; você administra tudo em uma organização, com um único conjunto de papéis.
Amazon Web Services
AWS
Planos de dados EKS em instâncias Graviton 5 (r9gd) e Graviton 4 (r8gd) com NVMe, DuckLake no S3 e TLS terminado no NLB.
Google Cloud
GCP
Planos de dados GKE em instâncias Axion (C4A) com SSD local, DuckLake no GCS e perfis de ajuste por nuvem.
Microsoft Azure
Azure
Planos de dados AKS em instâncias Cobalt (Epdsv6) com NVMe, DuckLake no Azure Blob / ADLS e cobrança pelo Azure Marketplace no roadmap.
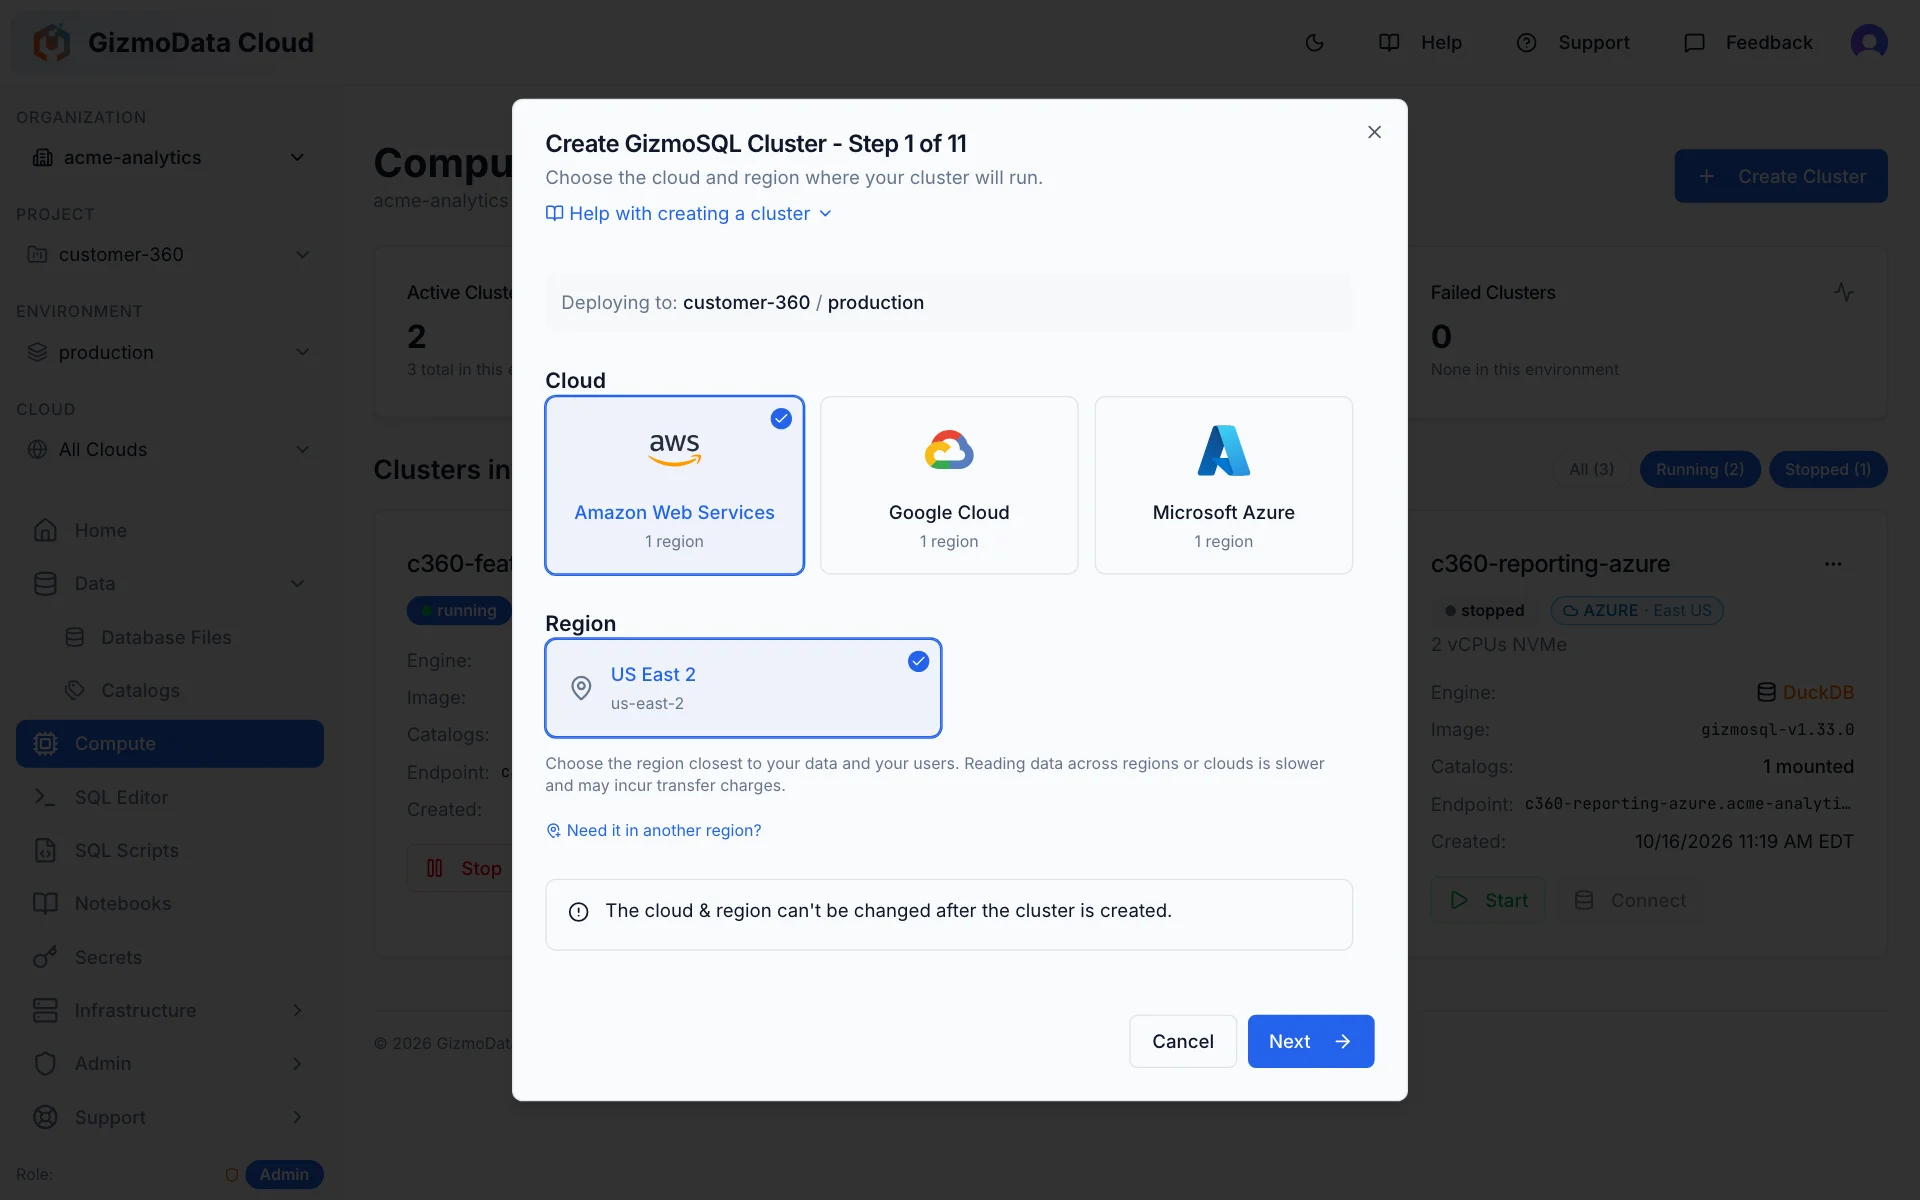
Posicionamento considerando a região
Catálogos, segredos e regras de firewall podem ser definidos por nuvem e região. Ao criar um cluster, os padrões são resolvidos para a região compatível mais próxima na hierarquia de escopos — primeiro a região exata, depois toda a nuvem e, por fim, o padrão neutro.
Governança de saída de dados integrada
Ative a governança de montagem entre regiões e a plataforma recusará associar um catálogo cujos dados estejam em região diferente da computação — a mensagem de erro informa a região de cada lado. Sem surpresas na conta de tráfego entre regiões.
Configurações adequadas à nuvem
Os tamanhos de instância são específicos de cada nuvem (Graviton 5 r9gd e Graviton 4 r8gd na AWS, Axion C4A no GCP, Cobalt 100 Epdsv6 no Azure) e validados conforme sua escolha; assim, você não pode pedir por engano uma configuração Azure na AWS.
Onde o GizmoData Cloud opera hoje
Organizações por autoatendimento podem iniciar clusters nestas regiões agora.
- AWSLeste dos EUA (Ohio)
us-east-2 - Google CloudLeste dos EUA (norte da Virgínia)
us-east4 - Microsoft AzureLeste dos EUA 2 (Virgínia)
eastus2
Provisione clusters GizmoSQL em qualquer nuvem, em uma única tela
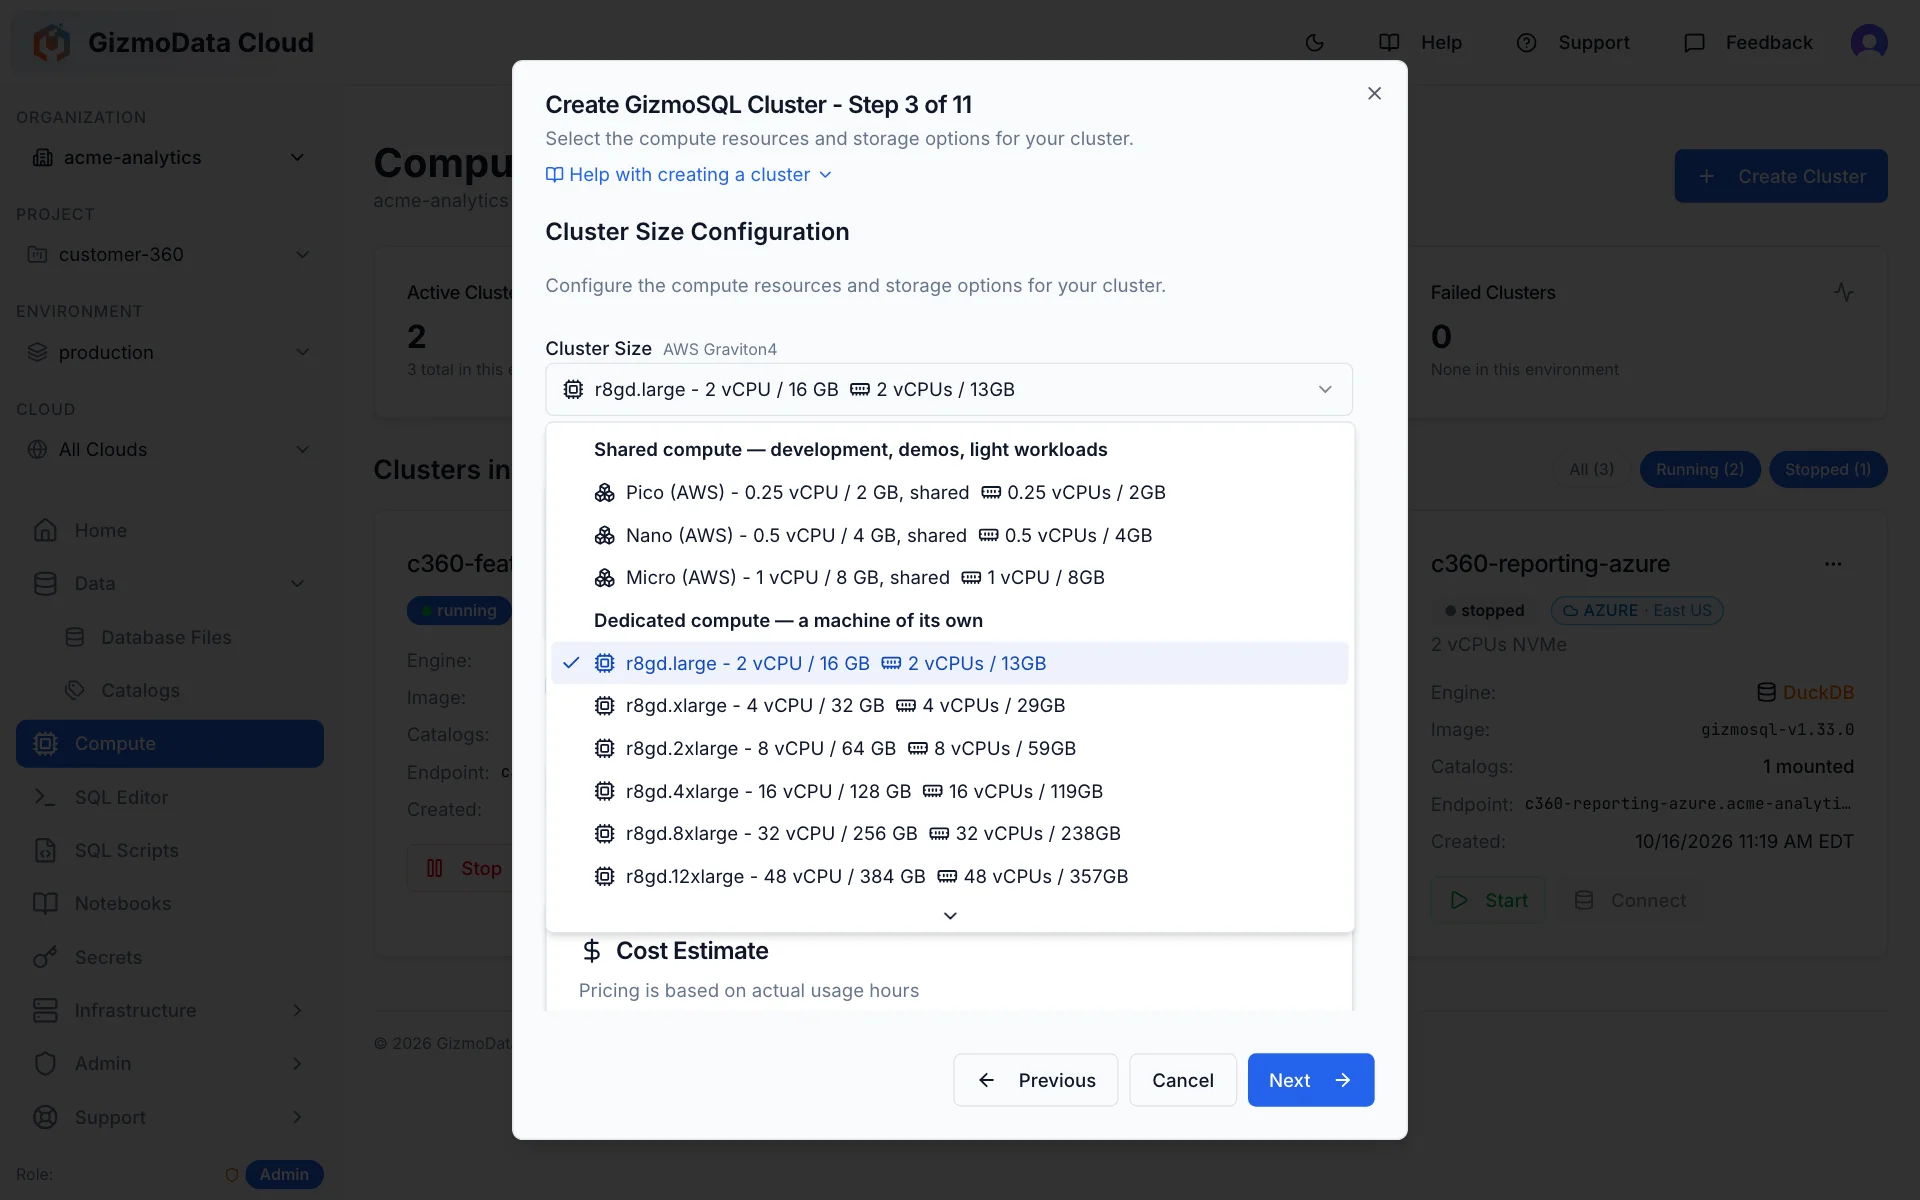
Cada cluster é uma implantação GizmoSQL totalmente gerenciada — DuckDB por trás do Apache Arrow Flight SQL — em Kubernetes, na nuvem e região escolhidas. Escolha uma configuração de instância, monte seus catálogos e segredos e comece a atender consultas em minutos.
- Configurações de instâncias por nuvem: AWS Graviton 5 (r9gd) e Graviton 4 (r8gd), Google Axion (C4A), Azure Cobalt 100 (Epdsv6) — selecionadas em um menu com preços atualizados
- Computação compartilhada para desenvolvimento, demonstrações e cargas leves — Pico (0,25 vCPU / 2 GB), Nano (0,5 vCPU / 4 GB) e Micro (1 vCPU / 8 GB), a partir de US$ 0,028/hora — ao lado de máquinas dedicadas para produção
- Escalabilidade automática (réplicas mínimas/máximas, metas de CPU e memória) e agendamentos de escalabilidade baseados em calendário
- Edições de licença Core ou Enterprise; catálogos de instrumentação e logs de consultas; OAuth/SSO; modos somente leitura e bloqueio
- Inicie, pare, edite e encerre automaticamente clusters ociosos — com o custo exibido antes da confirmação
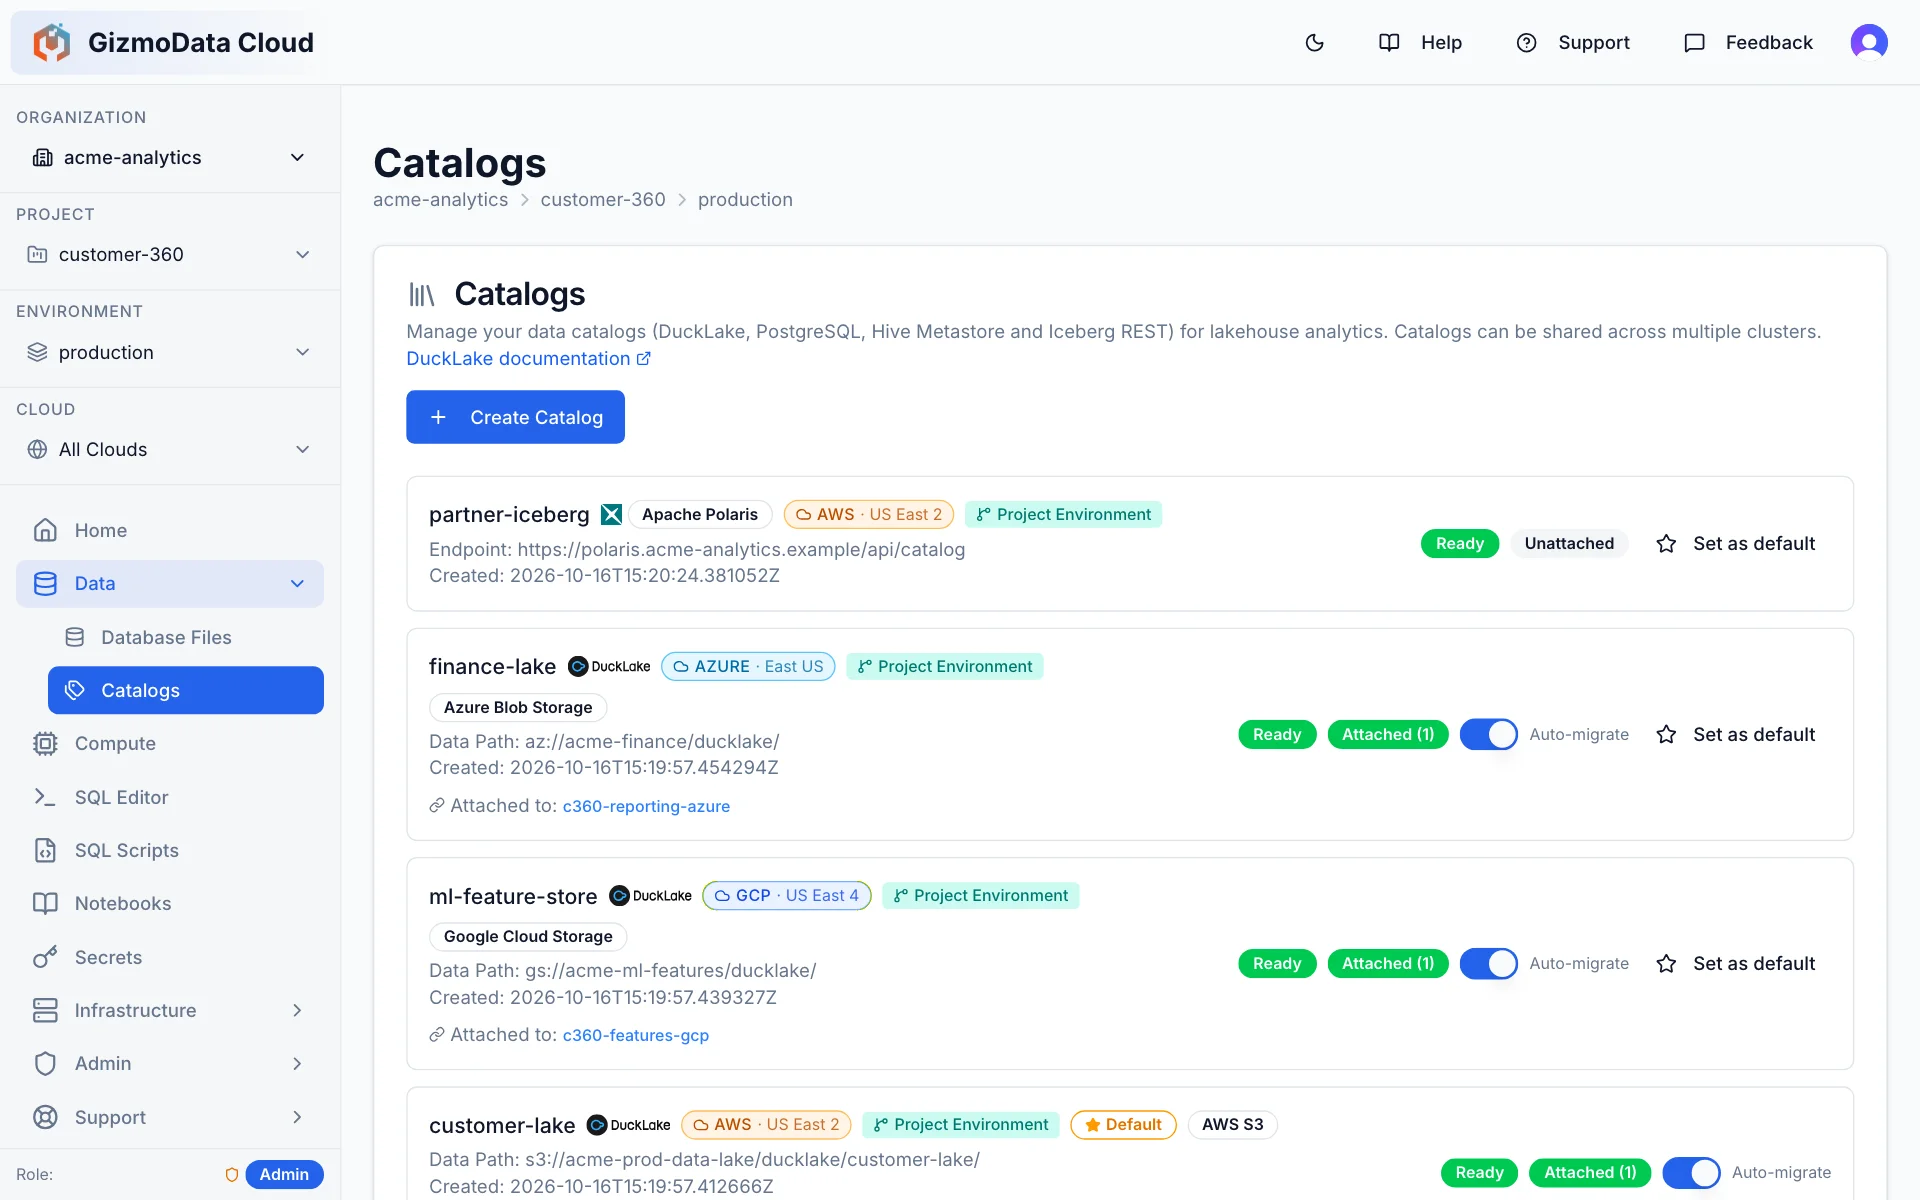
Catálogos lakehouse que acompanham seus dados — e não o contrário
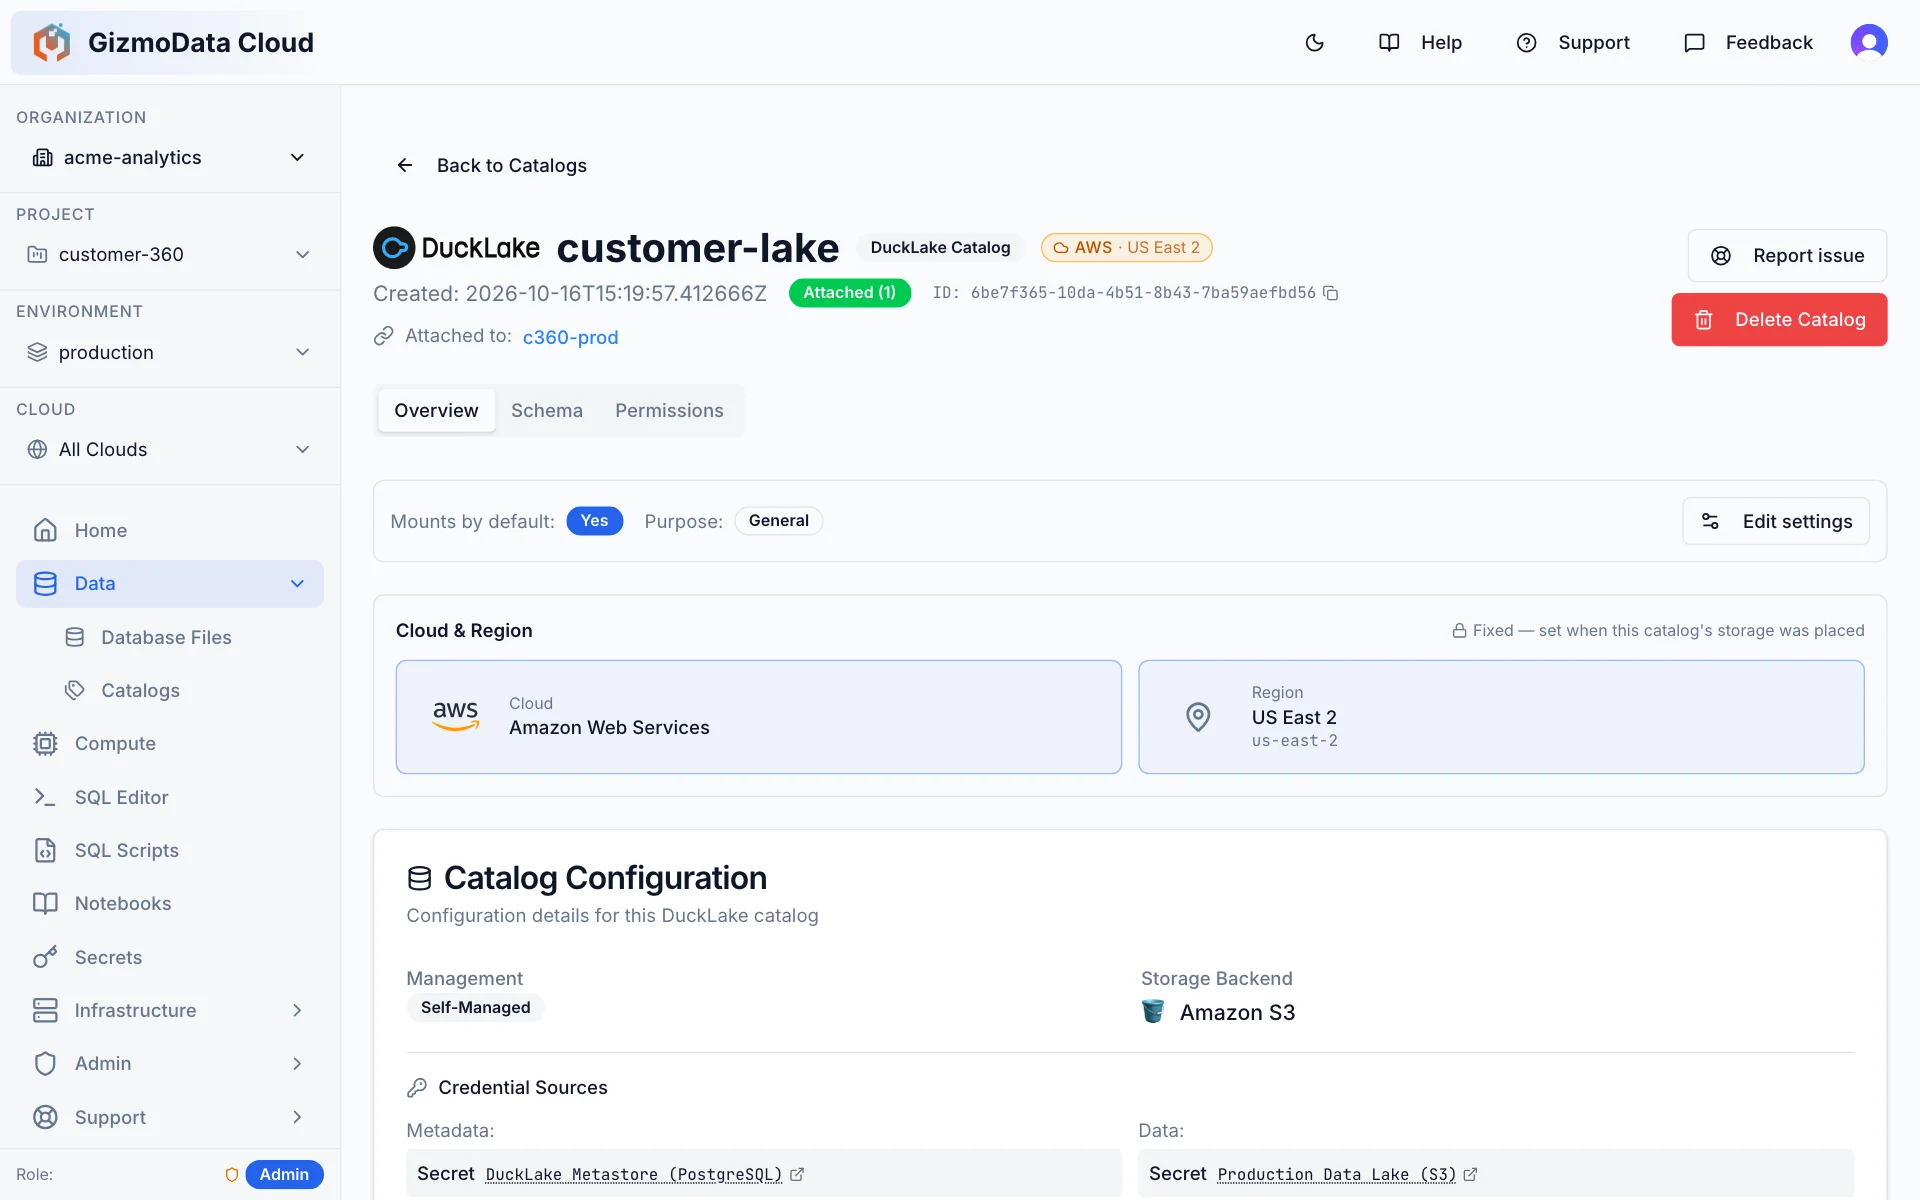
Um catálogo é um metastore DuckLake (ou PostgreSQL) acompanhado do armazenamento de objetos que contém seus dados Parquet — ou um Hive Metastore ou catálogo REST do Apache Iceberg que você já opera. Cadastre-o e monte-o em quantos clusters quiser; o GizmoData Cloud acompanha os clusters associados, migra-o automaticamente e pode defini-lo como padrão para um escopo inteiro.
- Catálogos DuckLake no S3, GCS, Azure Blob/ADLS ou Cloudflare R2 — com um metastore PostgreSQL fornecido por você ou gerenciado por nós
- Use seu próprio catálogo REST do Apache Iceberg — Apache Polaris (incluindo Snowflake Open Catalog), Snowflake Horizon (prévia) ou outro catálogo REST, como Lakekeeper — e consulte as tabelas no próprio local. O catálogo pode fornecer as credenciais de armazenamento, sem guardar chaves do bucket, e sua montagem em um cluster em execução não exige reinicialização
- Use seu próprio Hive Metastore (Hive 2.x / 3.x): conecte-o pelo endereço Thrift e consulte as tabelas que ele acompanha no S3, GCS ou Azure — ou crie novas tabelas no local de armazenamento do warehouse
- Ciente da região: cada catálogo conhece a nuvem e a região dos seus dados, permitindo posicionar a computação ao lado deles
- Governança de montagem entre regiões: organizações podem bloquear a montagem de catálogos de outra região, evitando cobranças inesperadas de saída de dados
- Navegação e atualização de esquemas sem iniciar computação; regras de acesso por catálogo; catálogos criptografados; retenção de histórico para catálogos de instrumentação
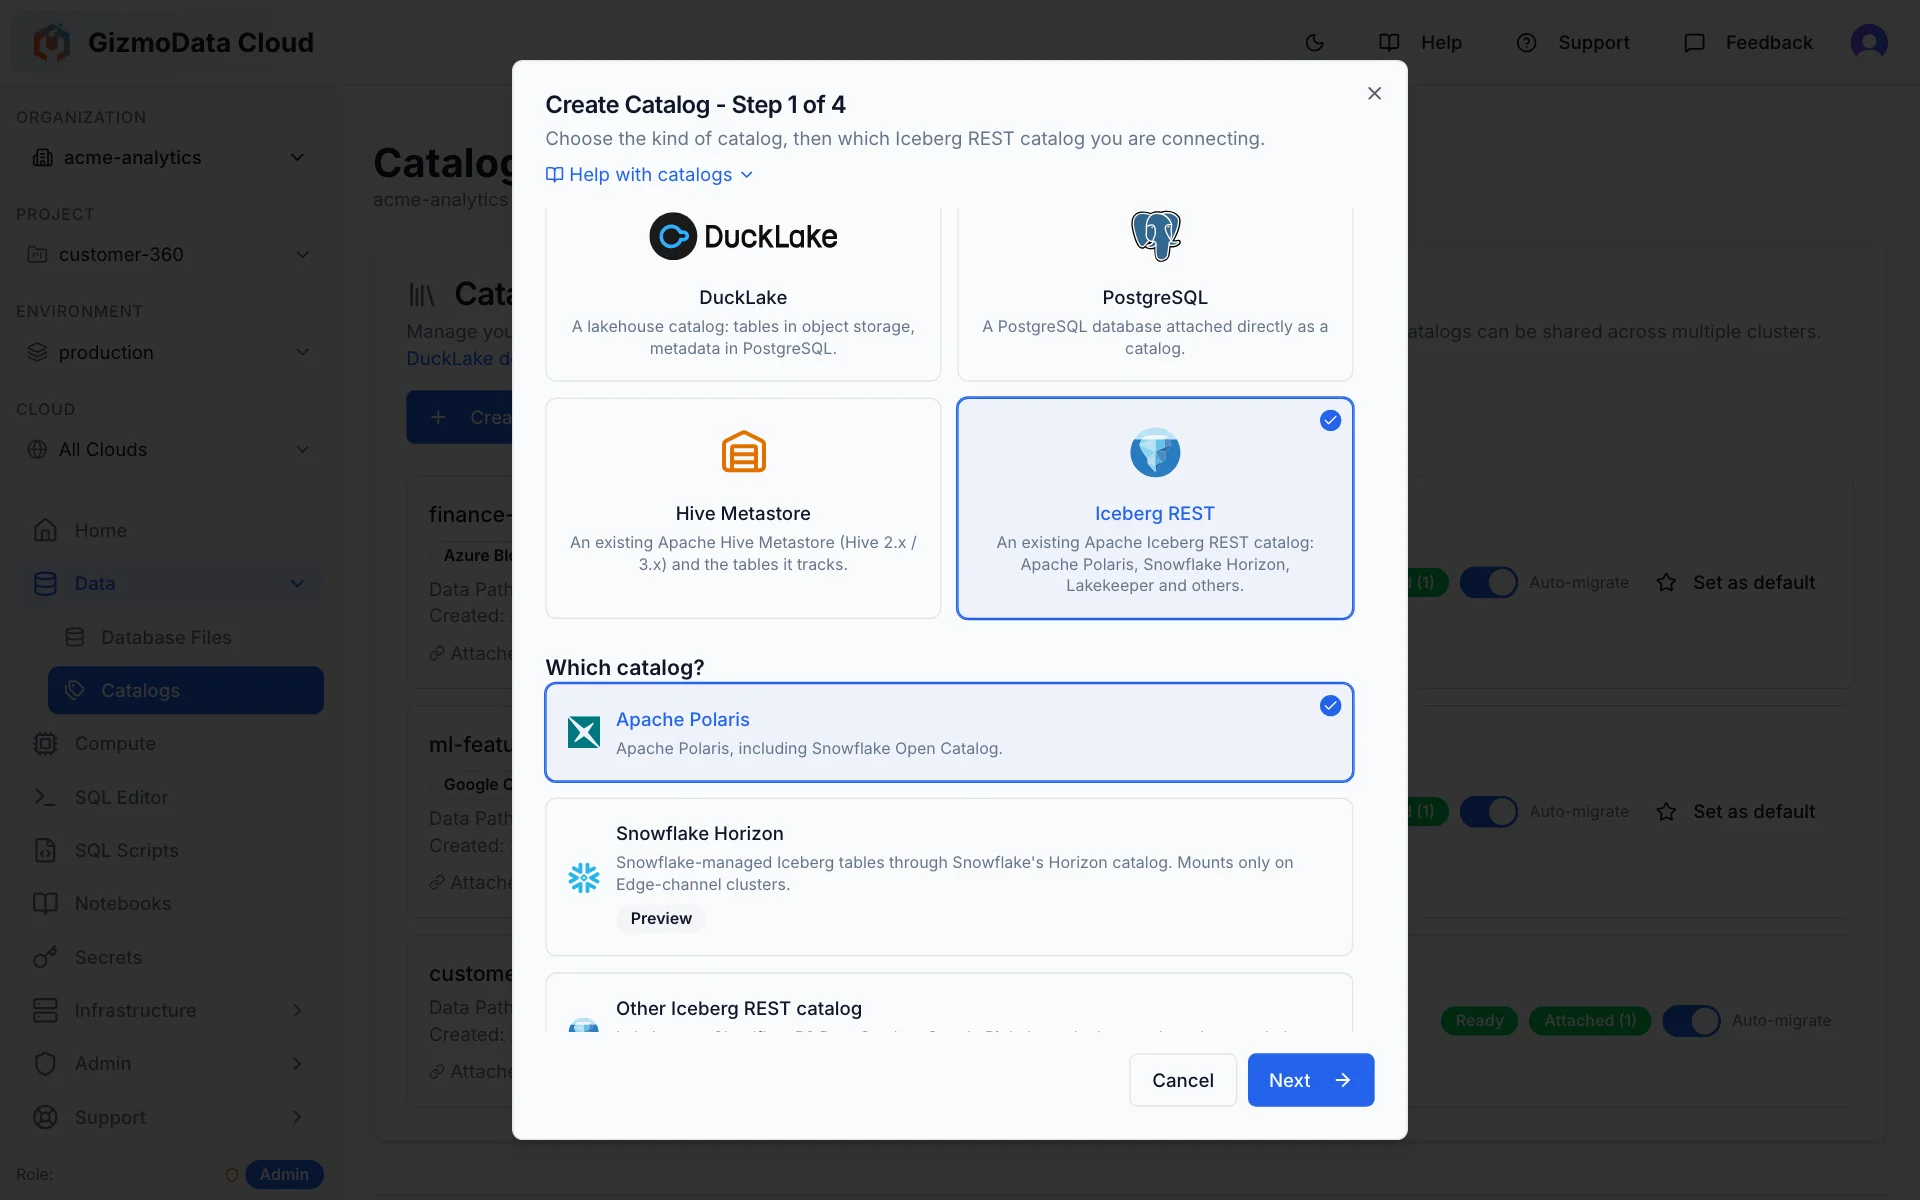
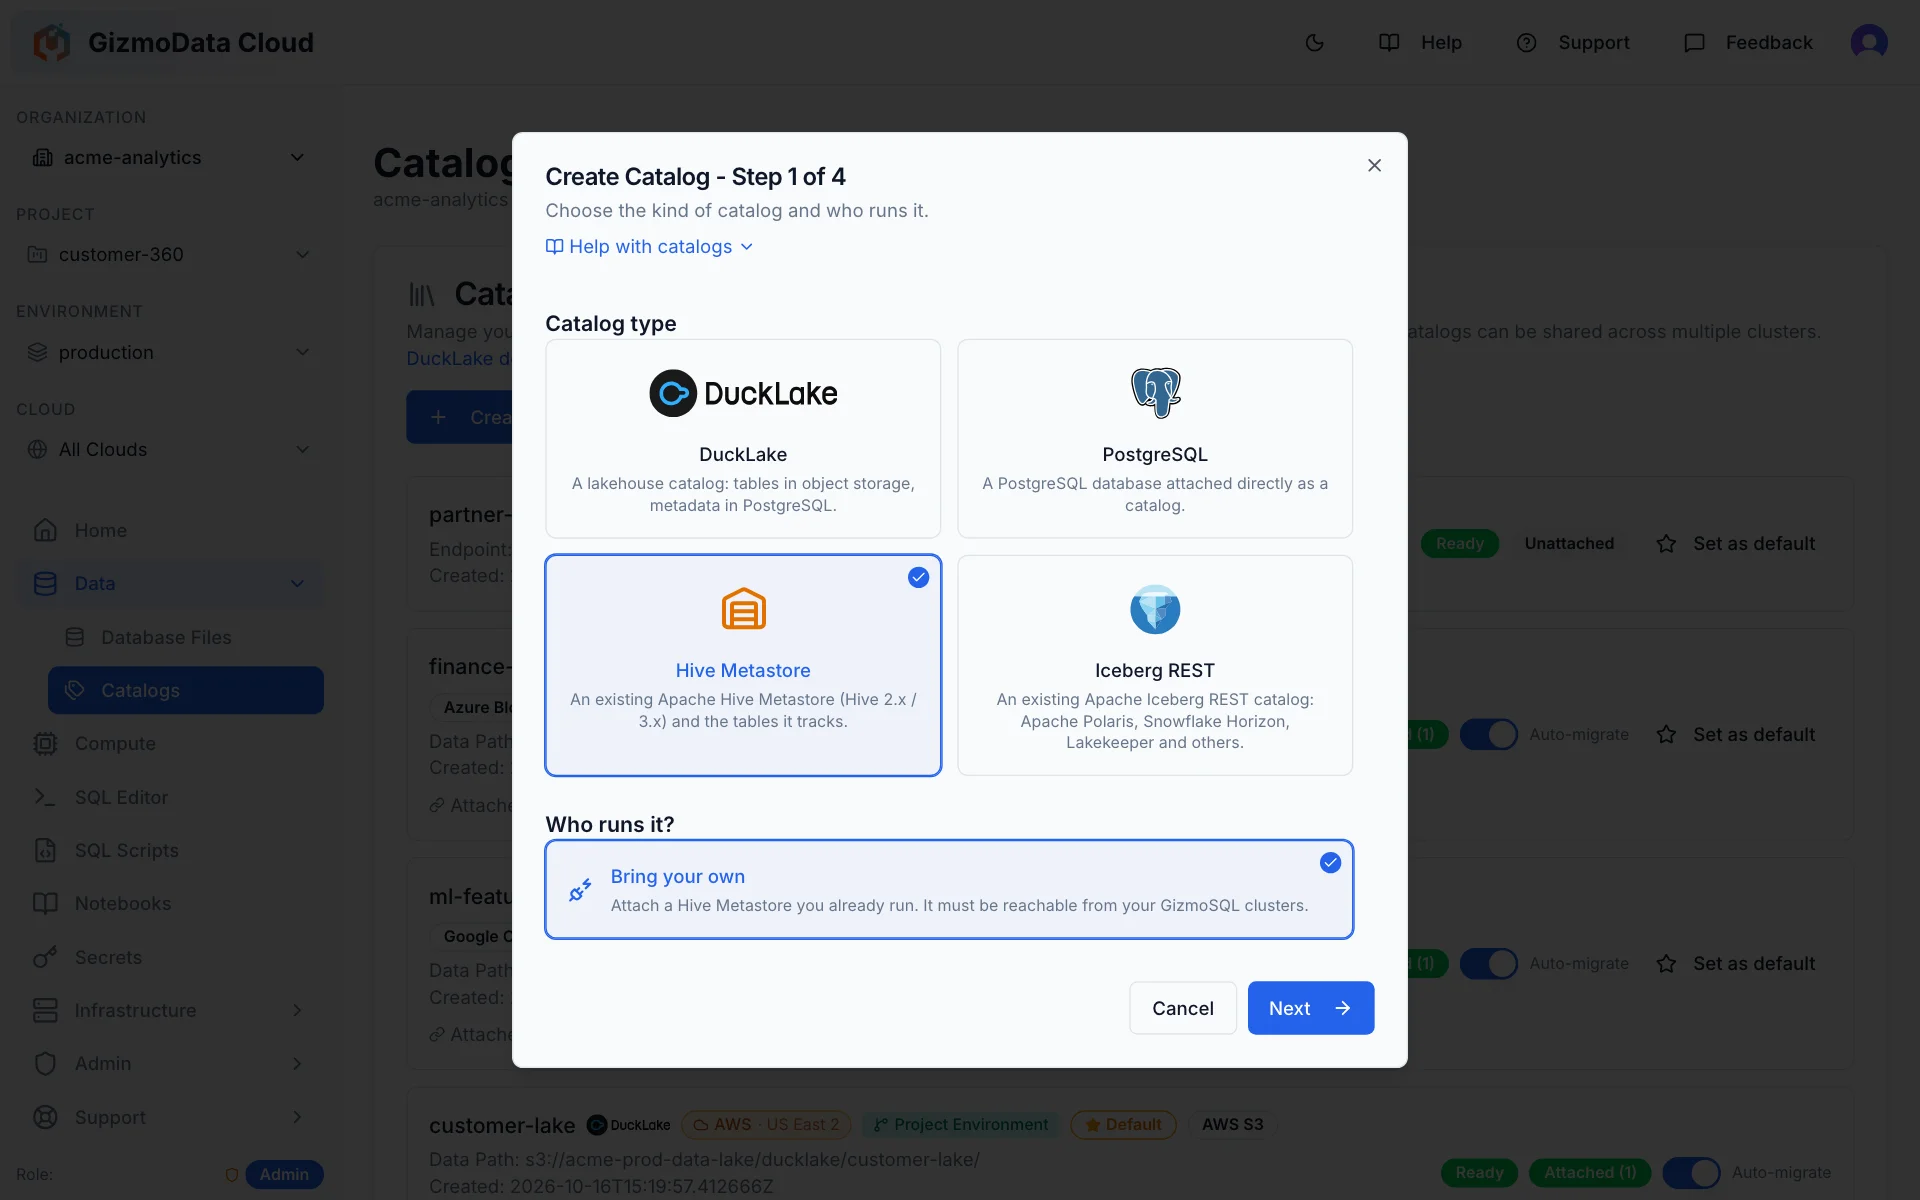
Credenciais armazenadas uma única vez, montadas onde precisam estar
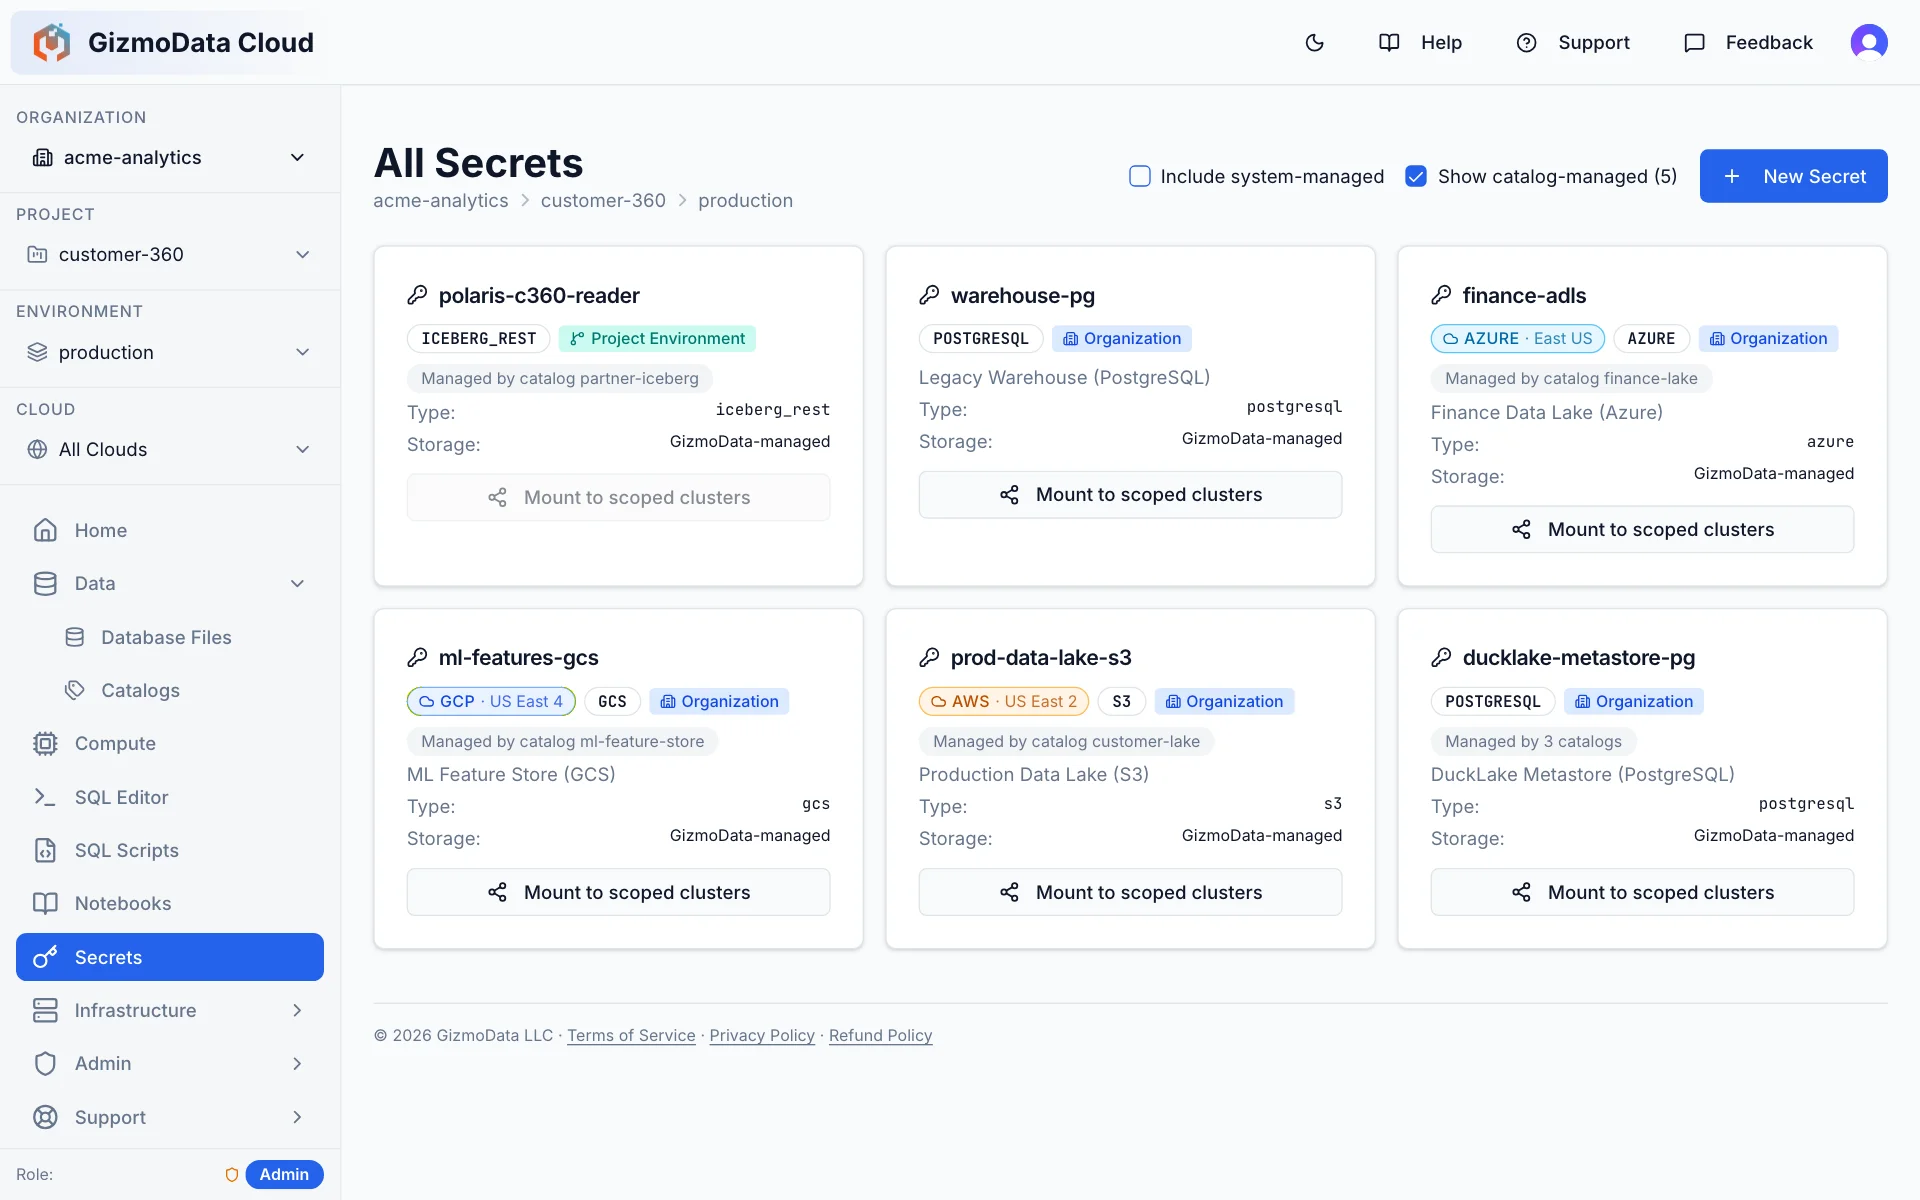
As credenciais de S3, GCS, Azure Storage, PostgreSQL e ADBC são criptografadas em repouso no plano de controle e injetadas nos pods GizmoSQL como segredos DuckDB na inicialização. Defina o escopo de um segredo para uma organização, projeto, ambiente ou destino de implantação e ele ficará disponível para todos os clusters subordinados.
- Modelos tipados de segredos por provedor — S3, GCS, Azure Storage, PostgreSQL, ADBC e credenciais de catálogo REST Iceberg
- Segredos gerenciados por catálogo são criados e rotacionados junto com o catálogo ao qual pertencem
- A ação “montar nos clusters do escopo”, em um clique, envia um novo segredo para todos os clusters em execução no escopo
- Segredos ADBC armazenam credenciais de bancos externos — Snowflake, Oracle, PostgreSQL, Db2 e outros — para viabilizar consultas federadas
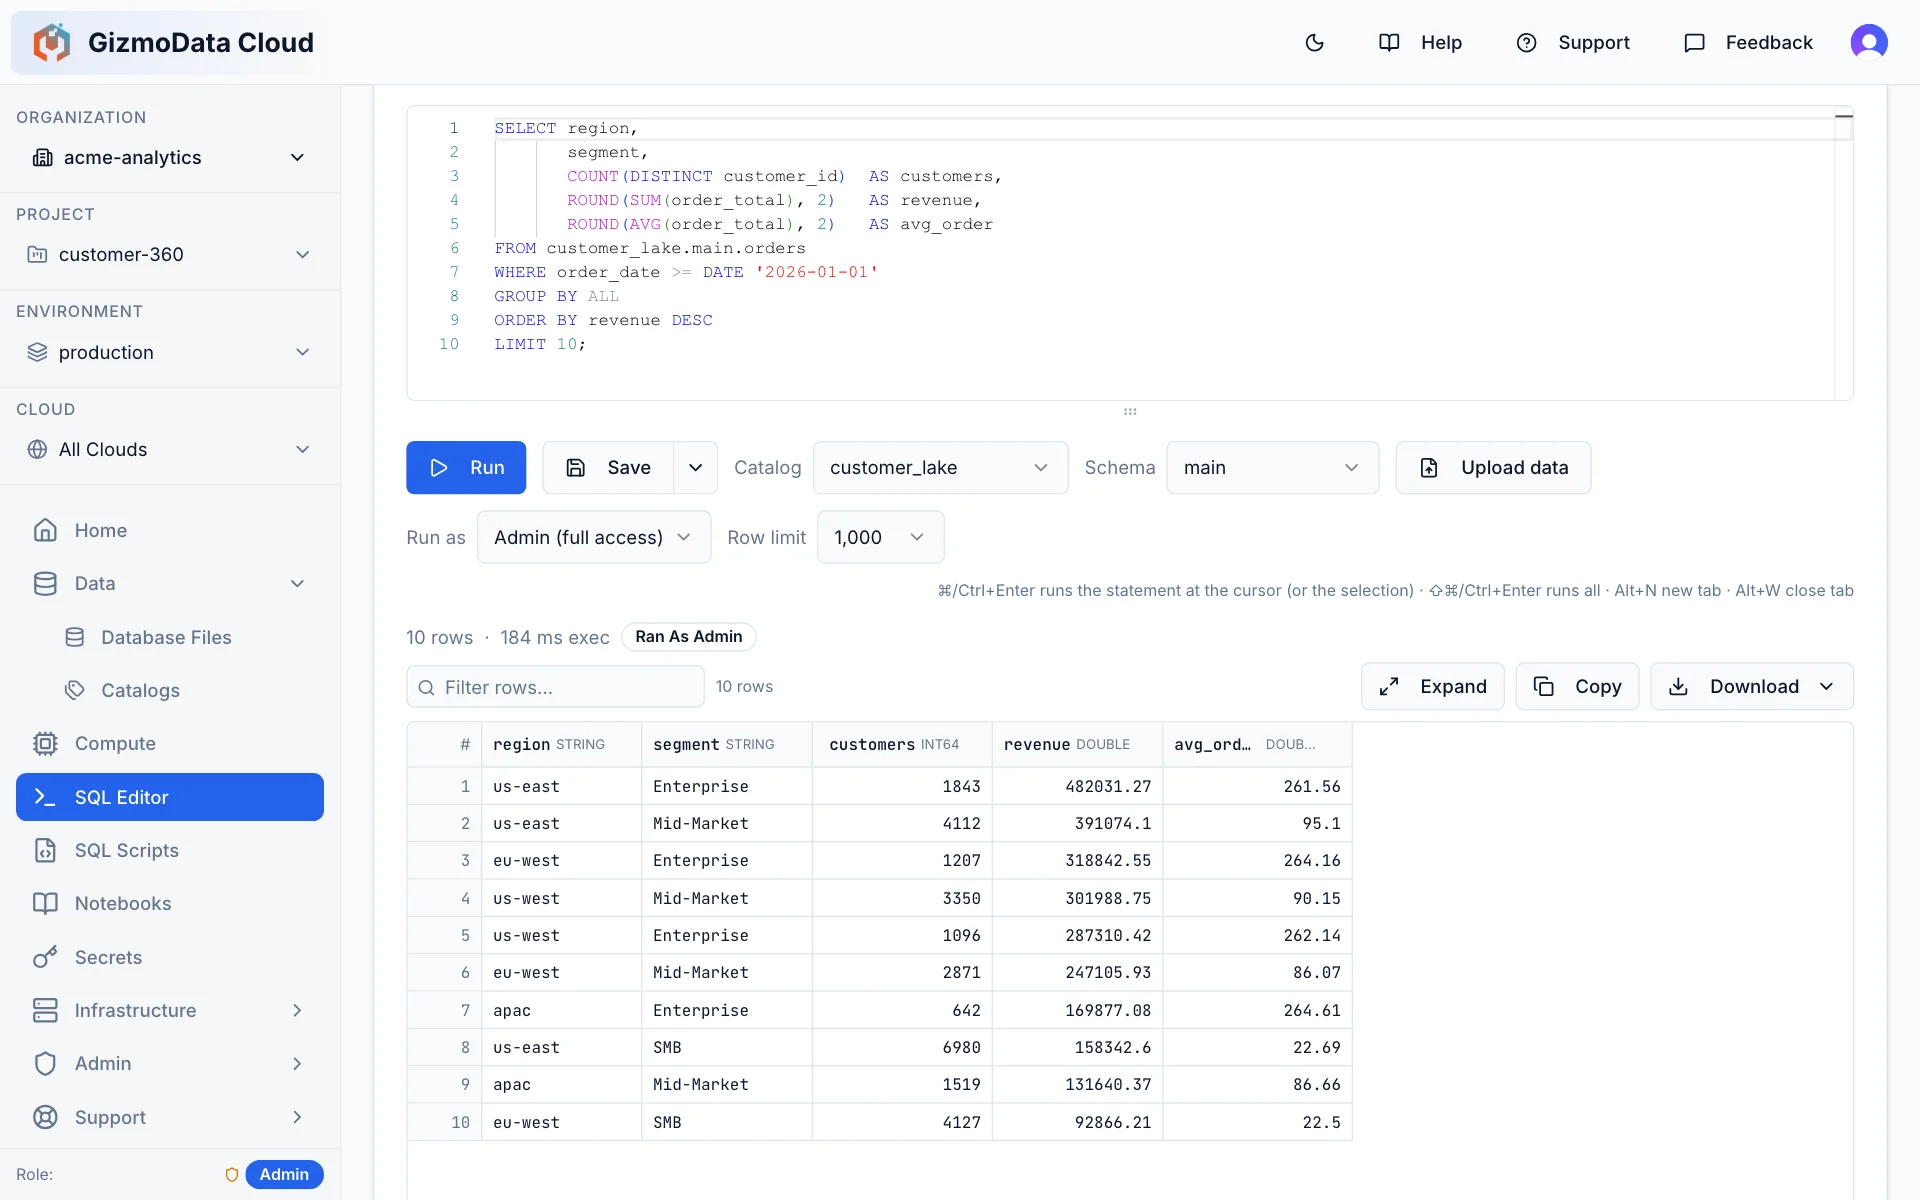
Consulte qualquer cluster no navegador — com sua própria identidade
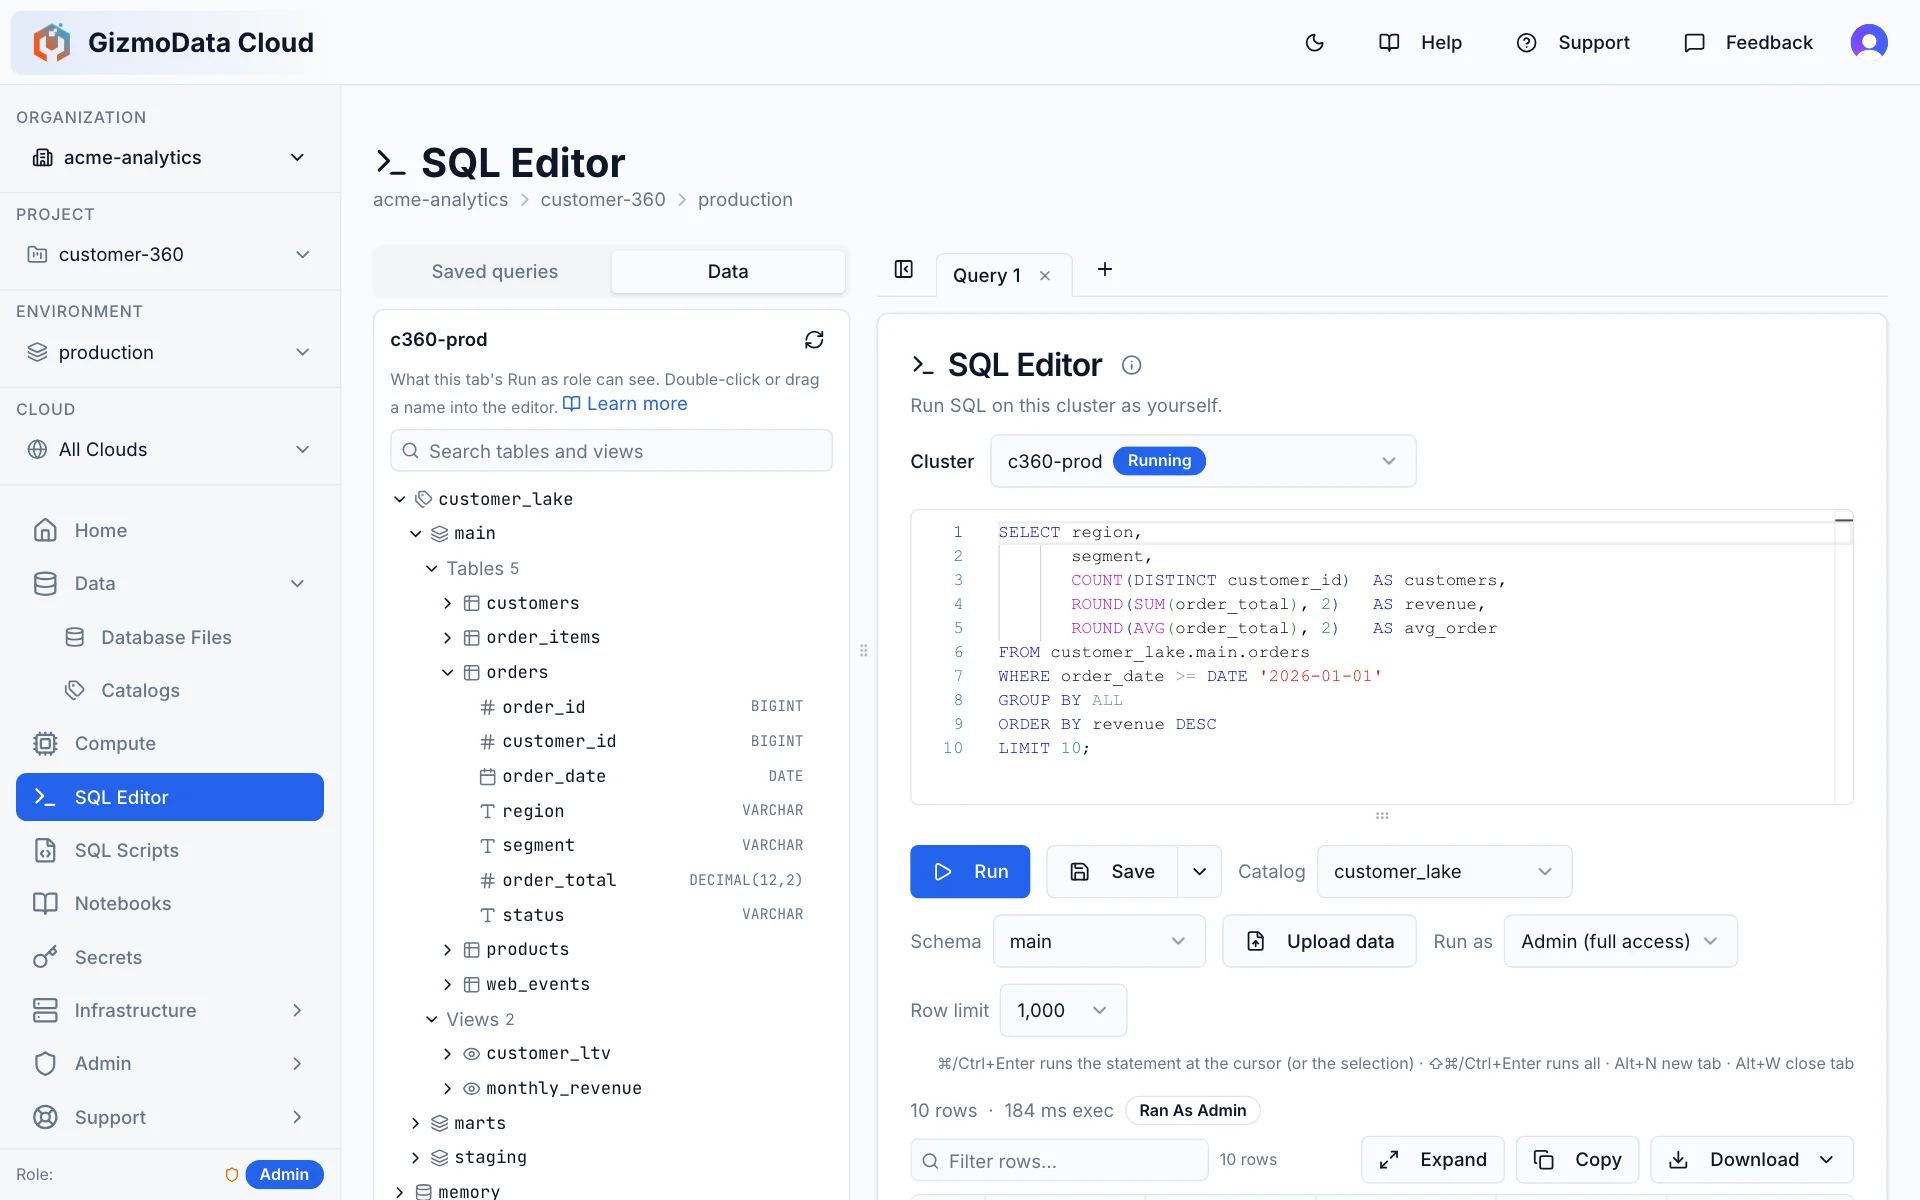
Cada cluster inclui um editor SQL com Monaco. As sessões usam suas permissões no GizmoData Cloud (administrador, usuário ou somente leitura), os resultados são transmitidos por Arrow Flight SQL e scripts SQL salvos podem ser associados como scripts de inicialização do cluster.
- Lotes com várias instruções, execução de seleção, limites de linhas e de tempo de consulta
- Explorador de dados ao lado do editor: navegue por catálogos, esquemas, tabelas, views e colunas com seus tipos; clique duas vezes ou arraste um nome para o editor, visualize uma tabela ou pesquise em todos os catálogos
- Seletores de catálogo e esquema preenchidos diretamente pelo mecanismo
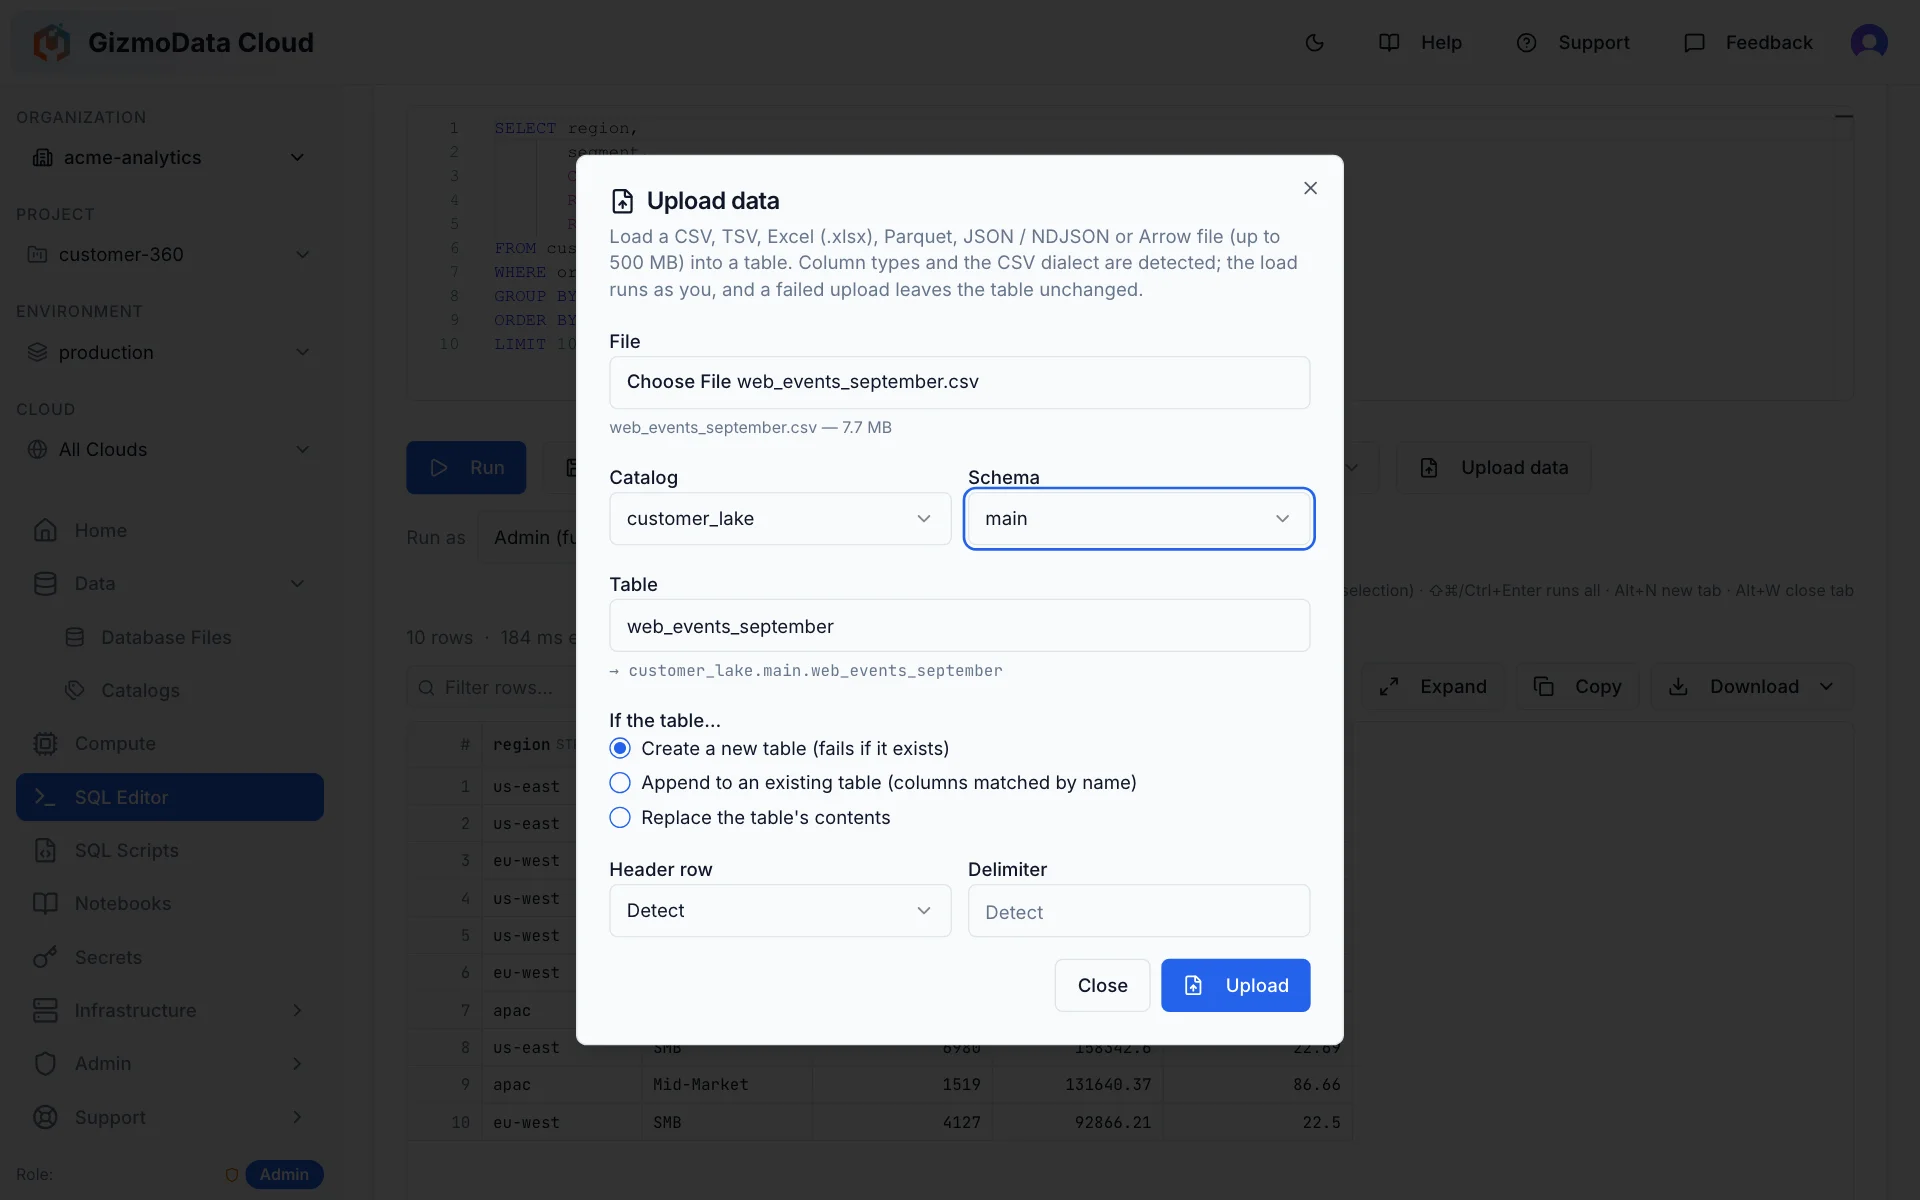
- Envio de dados: carregue um arquivo CSV, TSV, Excel, Parquet, JSON ou Arrow (até 500 MB) em uma tabela nova ou existente — os tipos das colunas e o dialeto CSV são detectados automaticamente
- Gere um token de conexão com escopo definido para DBeaver, Python (ADBC), JDBC ou GizmoSQL UI
Conecte Claude, Cursor ou VS Code a qualquer cluster em um minuto
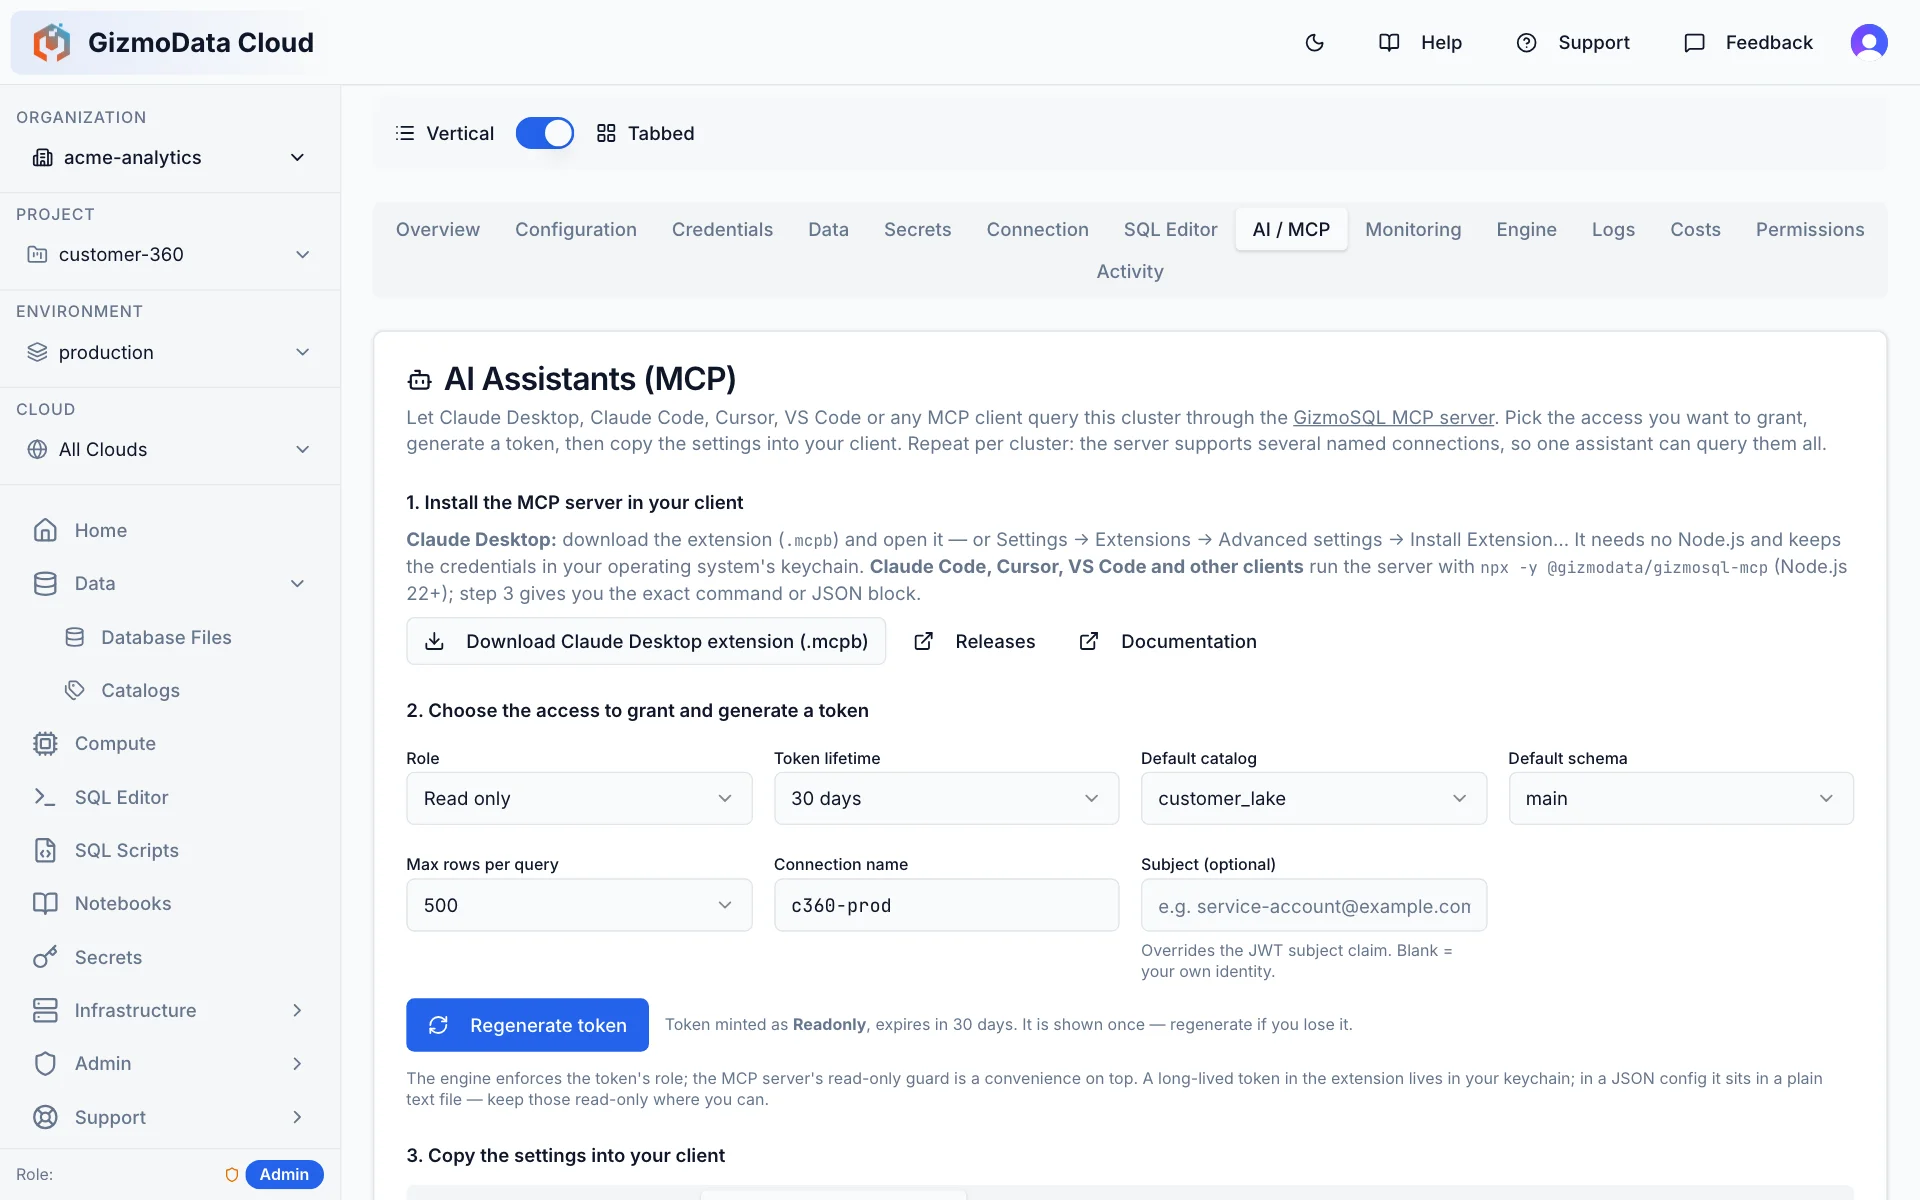
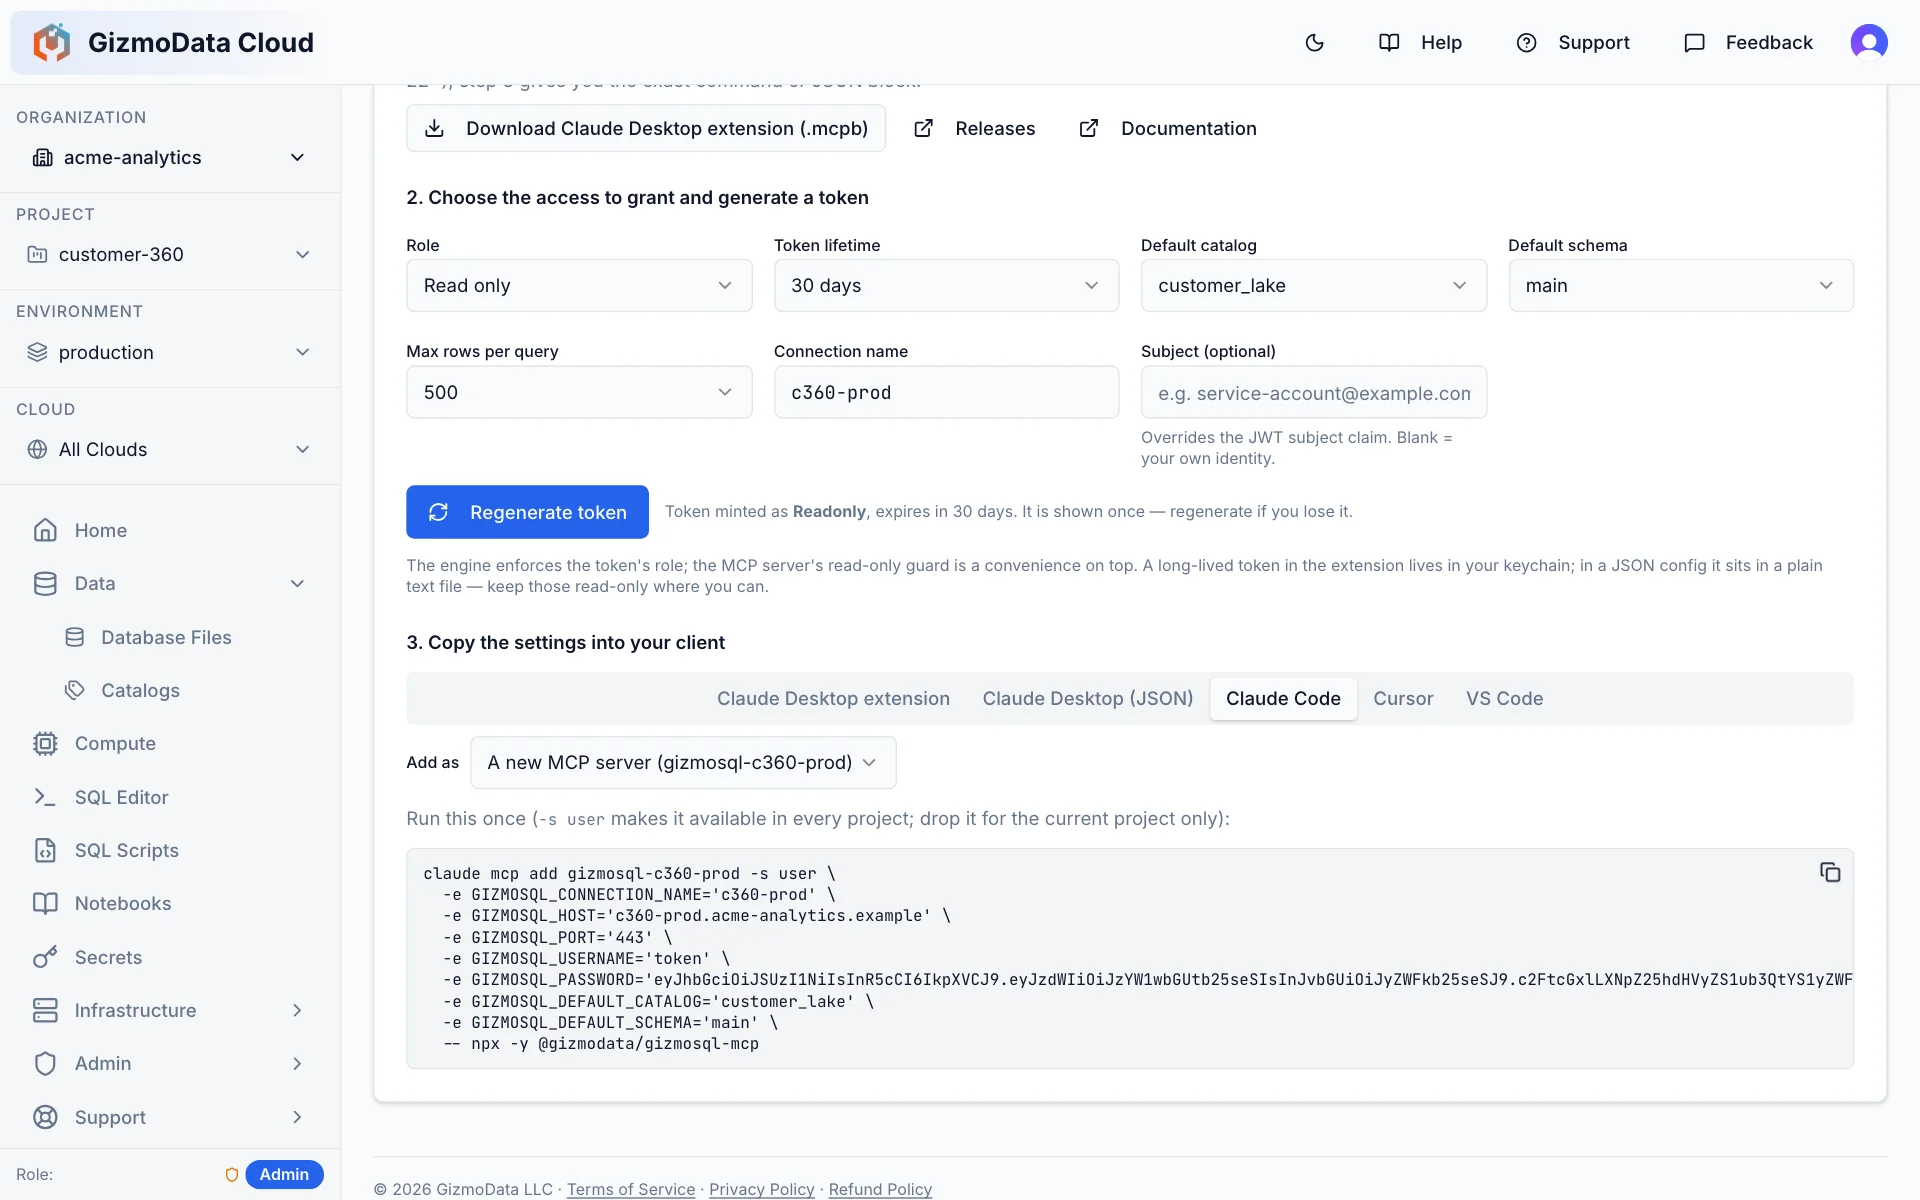
Cada cluster tem uma aba AI / MCP que conecta seu assistente de IA por meio do servidor MCP de código aberto do GizmoSQL. Escolha o acesso a conceder, gere um token e copie as configurações prontas para seu cliente — depois, faça perguntas em linguagem natural sobre os dados DuckLake. O assistente explora catálogos, esquemas e tabelas, descreve colunas, explica planos de consulta e executa SQL, respeitando o limite de linhas definido.
- Configurações prontas para colar na extensão Claude Desktop (sem Node.js; o token fica no chaveiro), no JSON do Claude Desktop, no Claude Code, Cursor e VS Code
- Privilégio mínimo por padrão: tokens são somente leitura, a menos que você escolha um papel mais amplo; o mecanismo aplica essa regra, e gravações exigem ativação explícita
- Validade de tokens de 24 horas a um ano, catálogo e esquema padrão e limite máximo de linhas por consulta
- Conexões nomeadas: adicione vários clusters — em diferentes nuvens — a um assistente e permita alternar entre eles; clusters Enterprise também podem limitar um token a catálogos específicos
Veja o que cada cluster está fazendo — até o mecanismo
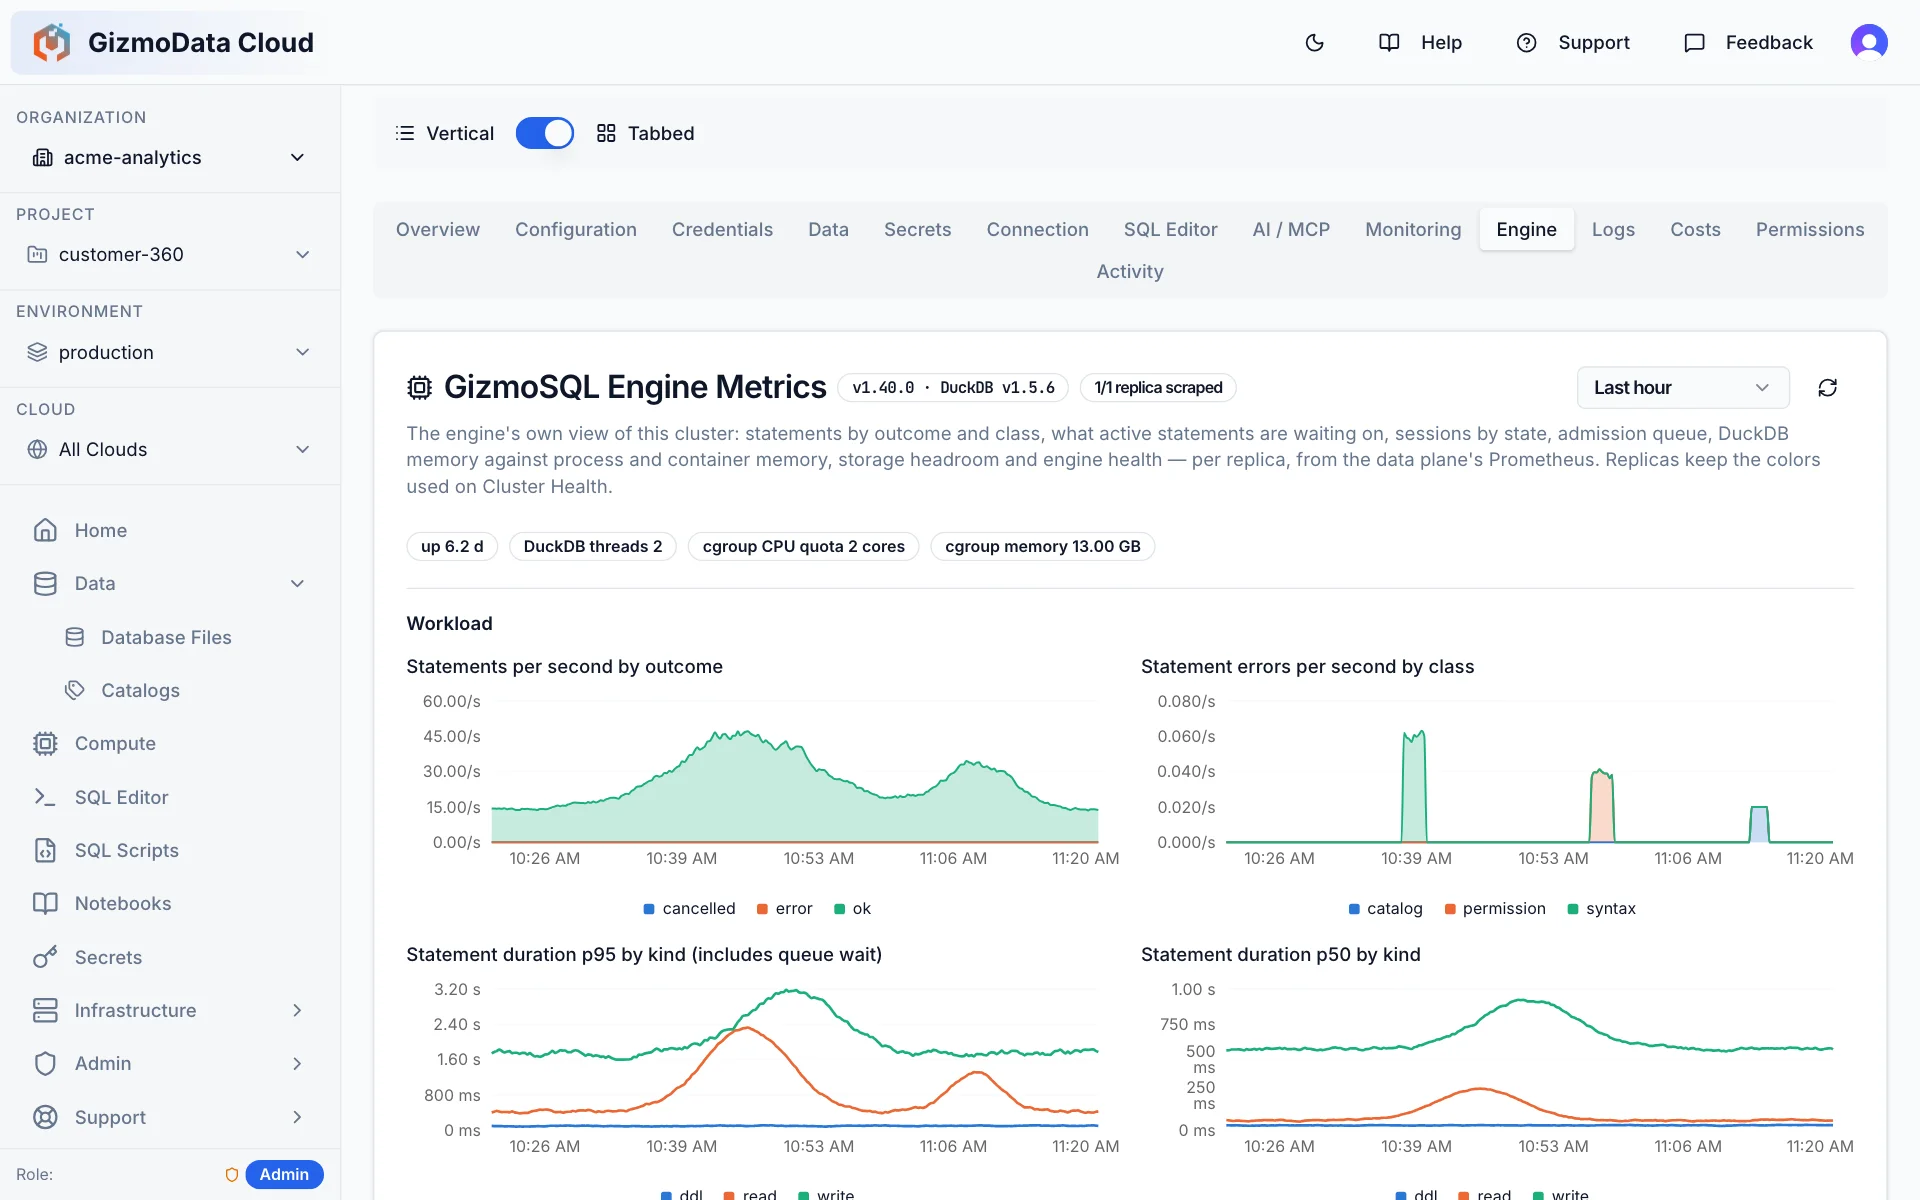
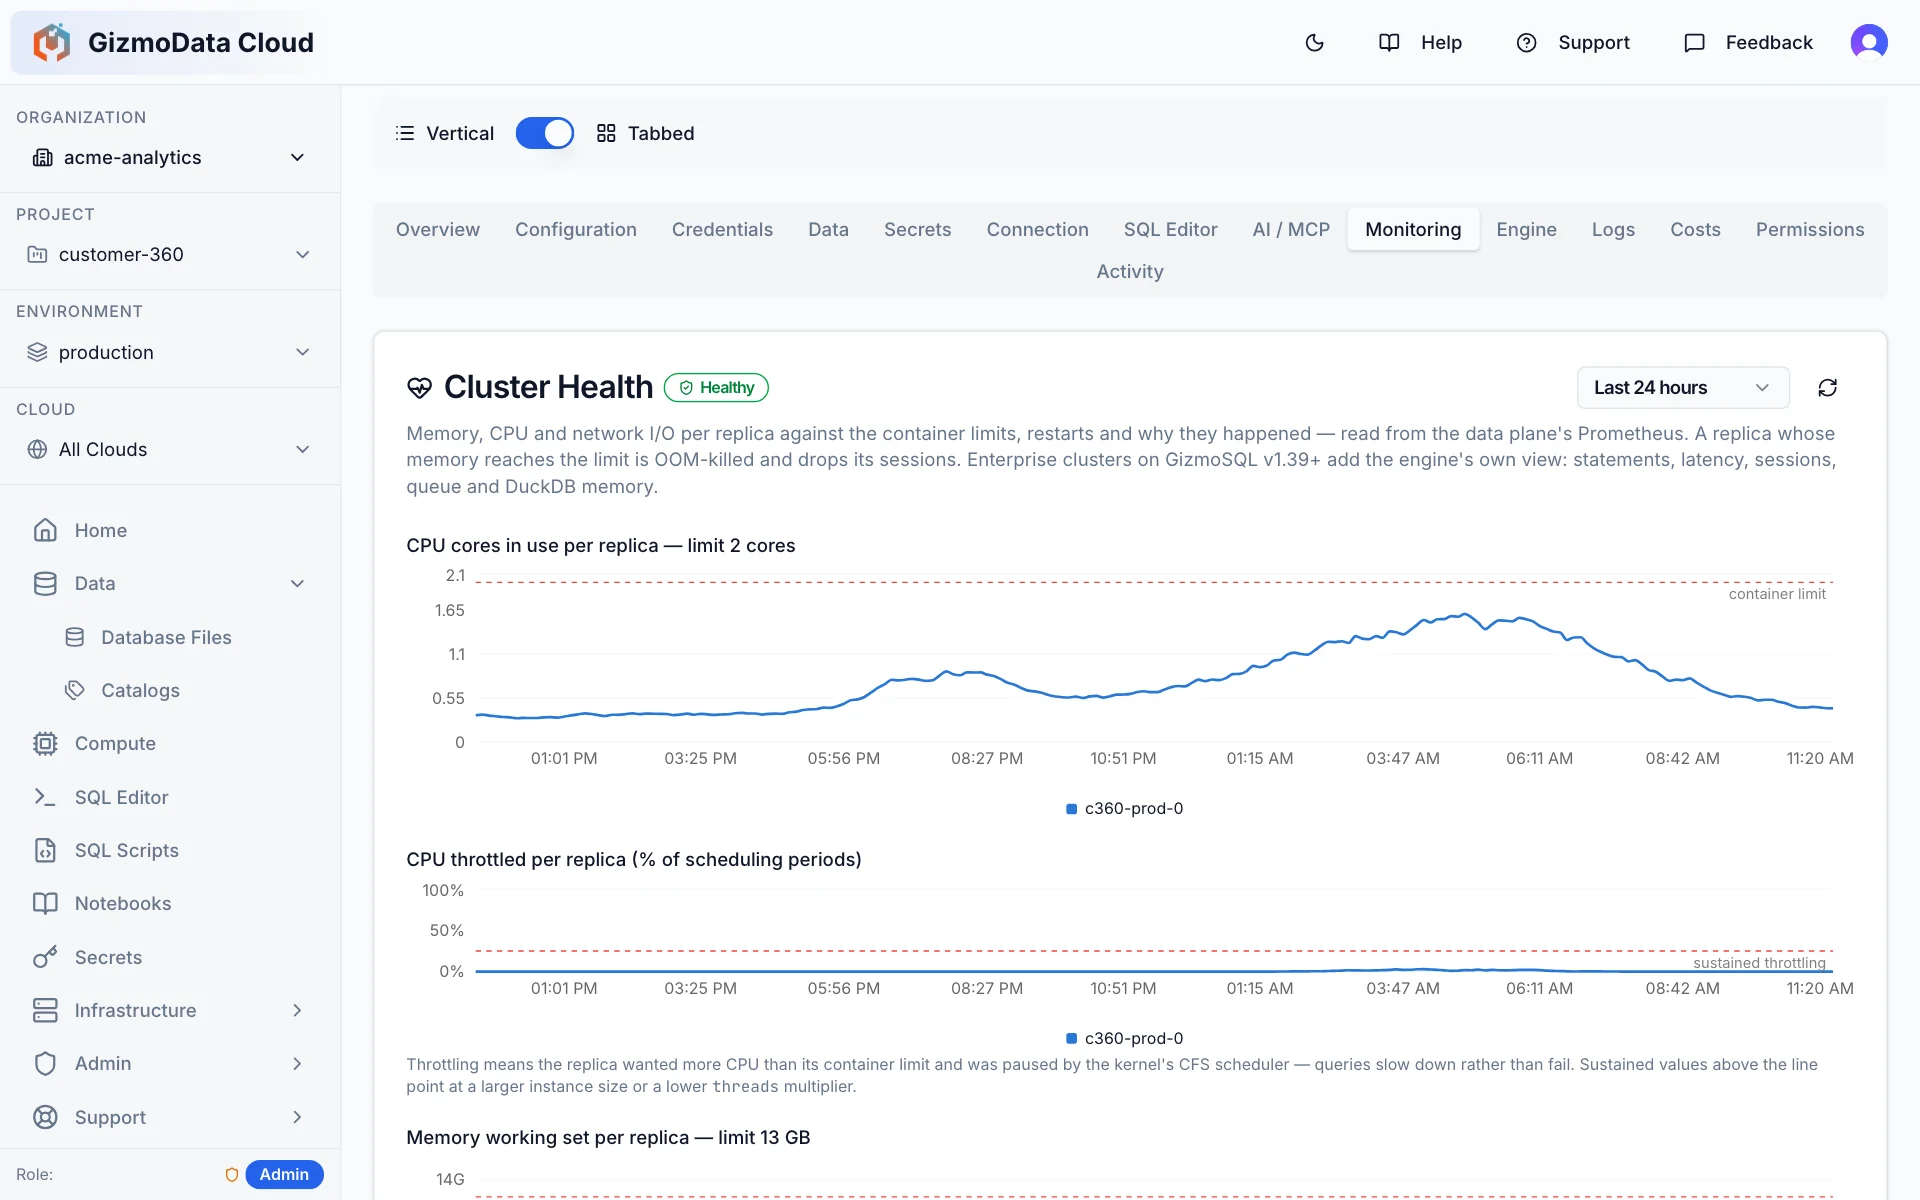
Cada cluster tem uma aba Monitoring: CPU, memória e rede por réplica em relação aos limites do contêiner, além de reinicializações e encerramentos por falta de memória com suas causas — obtidos do Prometheus do plano de dados. Nos clusters Enterprise, a aba Engine acrescenta as métricas do próprio GizmoSQL: o que o mecanismo executa, aguarda e mantém em memória.
- Monitoramento (todos os clusters): núcleos de CPU e limitação de processamento, conjunto de trabalho em memória, E/S de rede e réplicas prontas — na última hora ou nas últimas 6 horas, 24 horas ou 7 dias
- Reinicializações e encerramentos por falta de memória por réplica e suas causas, com indicador de integridade para consulta rápida
- Mecanismo (Enterprise): instruções por segundo por resultado, erros por classe e latências p50 / p95 por tipo de instrução
- Mecanismo (Enterprise): instruções ativas por estado de espera, fila de admissão e sessões, e memória do DuckDB em relação à memória do processo e do contêiner, uso de disco auxiliar e armazenamento temporário
As métricas do mecanismo vêm do endpoint Prometheus do próprio GizmoSQL, que faz parte da edição Enterprise. Os clusters Core têm a aba Monitoring.
Conecte Oracle, Snowflake, PostgreSQL, Db2 e outros — e consulte-os em tempo real
Os clusters do GizmoData Cloud executam as imagens de contêiner -adbc do GizmoSQL (v1.38.0+), que já vêm com 14 drivers ADBC pré-instalados e carregáveis pelo nome. Armazene as credenciais de conexão uma única vez como um segredo ADBC no GizmoData Cloud, conecte com ATTACH o banco remoto em SQL e federe — combine tabelas Snowflake ou Oracle com seus catálogos DuckLake em uma consulta, com resultados transmitidos por Arrow Flight SQL. É exatamente assim que consultamos o Snowflake em tempo real a partir de um cluster provisionado pelo GizmoData Cloud.
Credenciais gerenciadas pelo GizmoData Cloud
O portal e a API do GizmoData Cloud oferecem suporte completo à criação de segredos ADBC: tipados, criptografados em repouso, com escopo de organização, projeto ou ambiente e injetados em todos os clusters do escopo na inicialização — sem credenciais no seu SQL.
Use ATTACH e depois escreva SQL
As extensões ADBC da comunidade DuckDB funcionam dentro do GizmoSQL — o ADBC Scanner do nosso parceiro Query.Farm, e a extensão adbc da Columnar (cujo instalador dbc fornece os dez drivers de terceiros das nossas imagens; os quatro drivers GizmoData vêm das nossas próprias versões) — assim, um banco Snowflake, Oracle ou PostgreSQL conectado se comporta como um catálogo local, também com suporte a envio de filtros à origem e gravações.
Federe entre instâncias do próprio GizmoSQL
O driver ADBC nativo do GizmoSQL incluído permite que um cluster se conecte a outro — consulte um cluster em outra nuvem ou região a partir da conexão atual, com Arrow Flight SQL de ponta a ponta.
Orientação onde ajuda, clareza onde importa
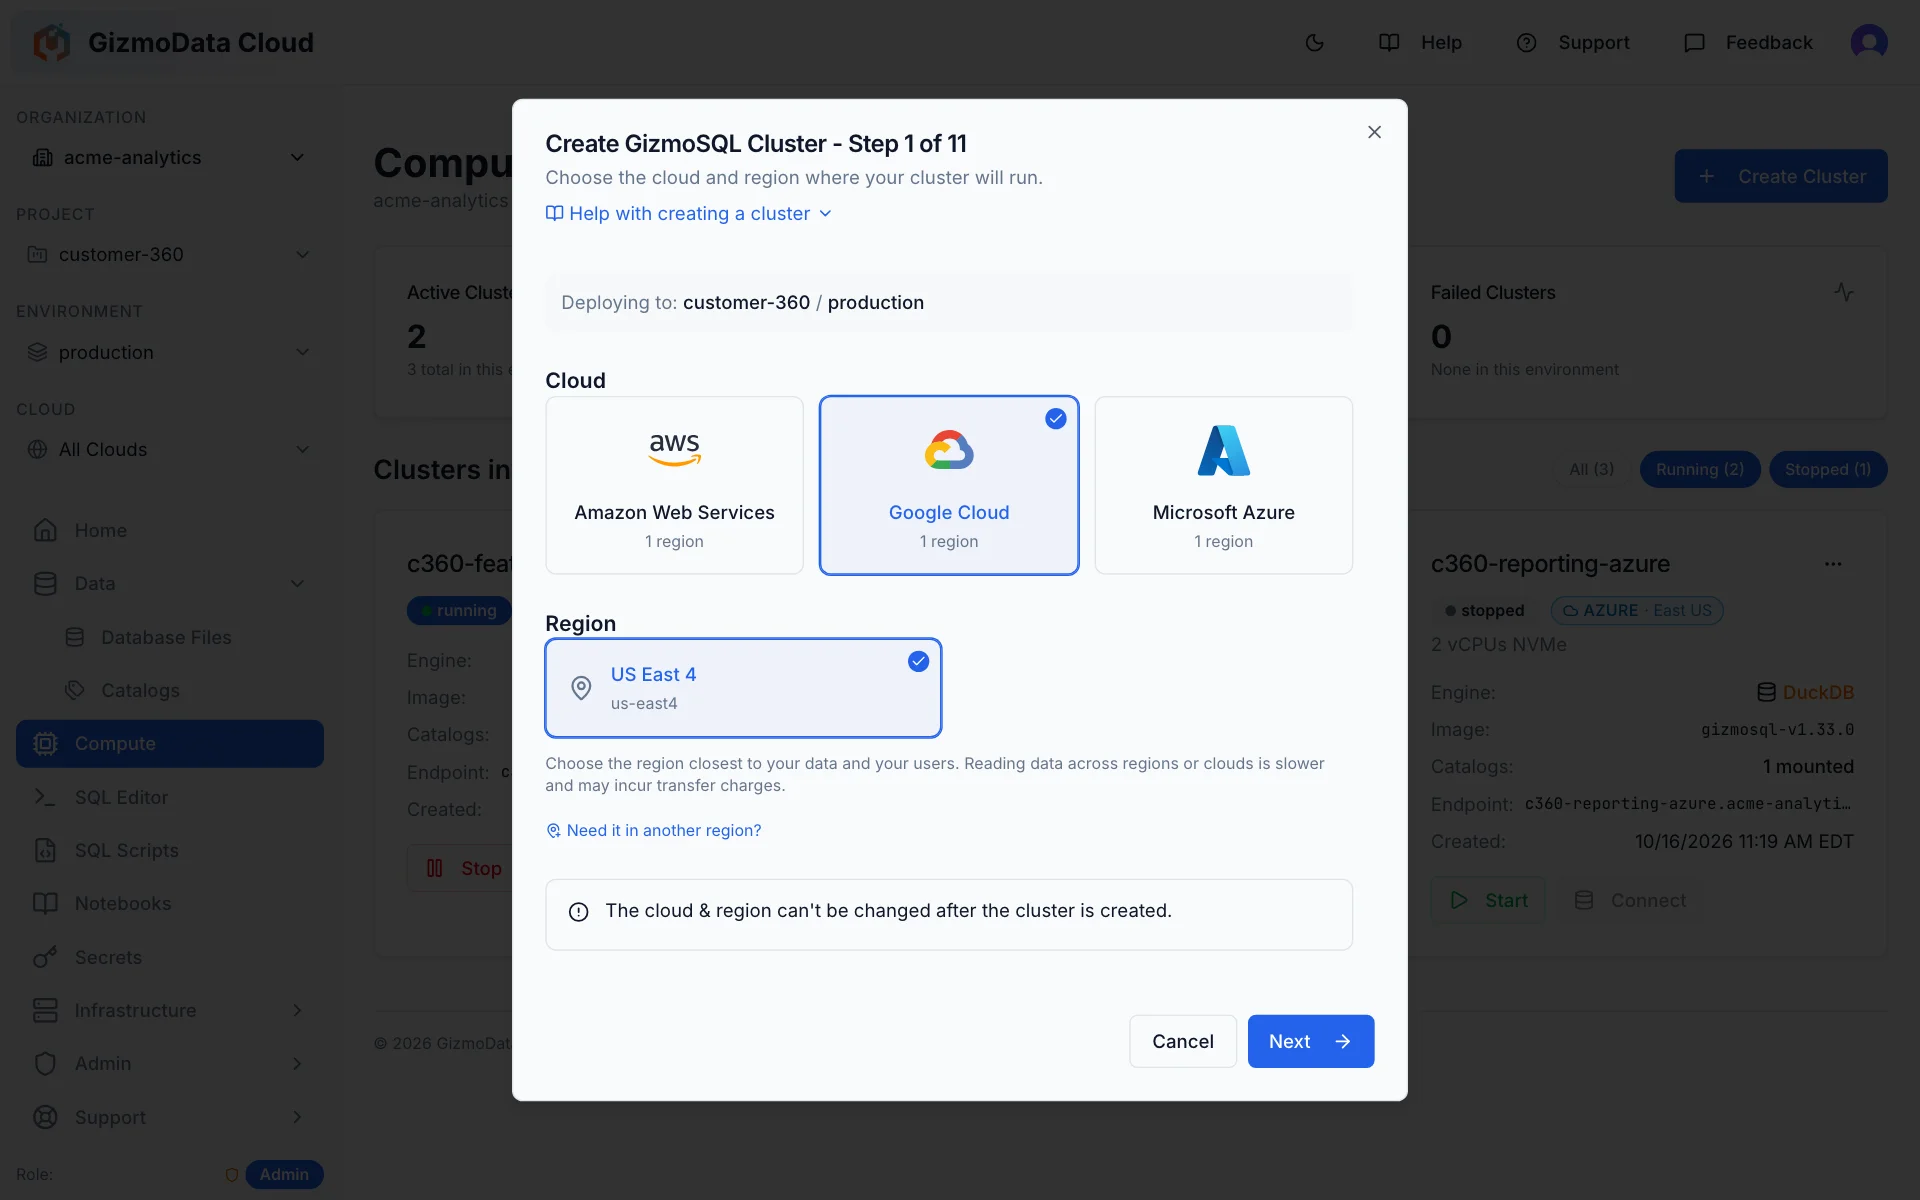
O assistente de cluster orienta a escolha de nuvem e região, configuração, mecanismo, catálogos, segredos, segurança e escalabilidade automática — herdando padrões de escopo a cada etapa e mostrando exatamente o que foi resolvido.
A melhor forma de executar DuckDB na nuvem
Uma afirmação ousada, então aqui estão os argumentos. O DuckDB é o mecanismo analítico mais rápido com que a maioria das equipes vai trabalhar — mas, sozinho, é uma biblioteca. O GizmoData Cloud é a plataforma que o transforma em um serviço seguro, multi-tenant e multinuvem: o GizmoSQL para servir as consultas, o DuckLake para os dados e tudo o que há em volta já resolvido.
DuckDB de verdade, servido adequadamente
O GizmoSQL envolve o mecanismo real do DuckDB em um servidor Apache Arrow Flight SQL — sessões simultâneas, TLS, autenticação e resultados colunares transmitidos para qualquer cliente Arrow. Não é uma fachada serverless sobre outro mecanismo.
Hardware adequado ao DuckDB
Análises em um único nó precisam de muita memória e disco local rápido. O GizmoData Cloud provisiona o GizmoSQL em instâncias otimizadas para memória e com NVMe local — AWS Graviton r8gd, GCP Axion C4A com SSD local e Azure Cobalt Epdsv6 — com ajustes de threads e memória aplicados automaticamente para cada nuvem.
DuckLake como recurso nativo
Catálogos lakehouse no S3, GCS ou Azure com metastore PostgreSQL são objetos nativos — montáveis em qualquer número de clusters, cientes da região, com navegação de esquemas sem computação e governança para evitar leituras entre regiões sem aviso.
Qualquer nuvem, qualquer região, um console
Um plano de controle gerencia simultaneamente planos de dados Kubernetes na AWS, no Google Cloud e no Azure. Posicione a computação perto de cada conjunto de dados e administre tudo com uma hierarquia, um conjunto de papéis e uma trilha de auditoria.
Controles empresariais sem o custo elevado
SSO/OAuth, permissões por catálogo, regras de firewall, segredos criptografados, identidades de carga de trabalho, catálogos de instrumentação e enfileiramento de consultas — os componentes que você teria de integrar já estão conectados.
Operação padronizada como software
Cada implantação é uma versão Helm com registro de alterações, teste de fumaça automatizado de ponta a ponta que provisiona um cluster real e executa uma consulta, e reversão em caso de falha. As atualizações são previsíveis — por escolha.
Tudo mais de que uma plataforma de dados precisa
Muito além de uma camada sobre um contêiner — a estrutura operacional que sua equipe teria de construir.
Organizações, projetos e ambientes
Uma hierarquia real — organização → projeto → ambiente → destino de implantação — para produção e homologação nunca compartilharem padrões por acidente.
Acesso baseado em papéis em todos os níveis
Papéis de administrador, gravação e leitura no escopo de organização, projeto ou ambiente. Convide colegas por e-mail; os papéis são herdados pela hierarquia.
Trilha de auditoria
Toda alteração feita pela API é registrada — quem, o quê, quando e com qual solicitação — e pode ser pesquisada no portal.
Escalabilidade automática e agendamentos
Escale réplicas por metas de CPU e memória ou por calendário: aumente para o pico de painéis pela manhã e reduza no fim de semana.
Regras de firewall e TLS em todos os pontos
Listas de CIDRs permitidos por cluster, TLS terminado no balanceador ou no pod e OAuth/SSO para sessões GizmoSQL.
Instrumentação e logs de consultas
Aponte um cluster para um catálogo de instrumentação e cada consulta, sessão e P99 será registrada em tabelas DuckLake que você mesmo pode consultar.
Arquivos de banco de dados
Envie arquivos DuckDB para um volume persistente com backups no S3, monte-os em modo somente leitura ou de gravador único e importe-os como tarefa em segundo plano.
Suporte e incidentes integrados
Abra um chamado a partir de qualquer cluster, veja incidentes da plataforma no aplicativo e receba alertas Sev-1 por SMS nos planos Business e Enterprise.
Scripts SQL e notebooks
Salve scripts SQL para reutilizar entre clusters ou executar na inicialização; notebooks para análise exploratória.
Comece grátis com US$ 25 de crédito
Não é preciso cartão de crédito. Seus US$ 25 de crédito de avaliação executam clusters GizmoSQL reais; escolha um plano só quando o crédito acabar.
- 1Clique em “Comece grátis” e cadastre-se com Google, Microsoft, Apple ou GitHub
- 2Crie sua organização: o crédito de lançamento de US$ 25 é aplicado automaticamente
- 3Inicie um cluster, sem cartão de crédito até o crédito acabar
Preços
Planos pré-pagos, sem surpresas. A mensalidade retorna como crédito de computação; os clusters consomem esse saldo por hora, pelo preço exibido na criação.
Starter
US$ 29 / mês
devolvidos integralmente como crédito de computação
- Até 8 vCPUs em execução simultânea
- Uso excedente cobrado pelo mesmo preço por hora; cobrança durante o mês ao ultrapassar US$ 100 ainda não faturados
- Armazenamento gerenciado a US$ 0,05 por GB-mês
- Regiões AWS, Google Cloud e Azure; capacidade spot com preços spot
Experimente com dados reais. Um cluster pequeno ou alguns clusters spot.
Team
US$ 99 / mês
devolvidos integralmente como crédito de computação
- Até 32 vCPUs em execução simultânea
- Uso excedente cobrado pelo mesmo preço por hora; cobrança durante o mês ao ultrapassar US$ 300 ainda não faturados
- Armazenamento gerenciado a US$ 0,05 por GB-mês
- Regiões AWS, Google Cloud e Azure; capacidade spot com preços spot
As análises diárias de uma equipe, com capacidade de sobra para uma tarefa grande.
Business
US$ 499 / mês
devolvidos integralmente como crédito de computação
- Até 128 vCPUs em execução simultânea
- Uso excedente cobrado pelo mesmo preço por hora; cobrança durante o mês ao ultrapassar US$ 1.500 ainda não faturados
- Armazenamento gerenciado a US$ 0,05 por GB-mês
- Regiões AWS, Google Cloud e Azure; capacidade spot com preços spot
Vários ambientes e cargas intensas, com suporte Sev-1 que aciona nosso engenheiro de plantão.
Enterprise
Cotas personalizadas de vCPU, faturamento e contratos, ambiente dedicado, Cloud at Customer nas suas contas e GizmoSQL Enterprise hospedado para você.
A computação é cobrada por hora de cluster, conforme tamanho da máquina, réplicas e edição de licença — o preço por hora aparece antes de criar ou redimensionar um cluster. O crédito pré-pago expira no fim do mês pago; o crédito promocional tem validade própria e não tem valor em dinheiro. Preços em USD; podem incidir impostos. Consulte os Termos de Serviço e Política de reembolso.
Perguntas frequentes
O que é o GizmoData Cloud?
O GizmoData Cloud é o serviço totalmente gerenciado do GizmoSQL. Seu plano de controle — o portal e a API do GizmoData Cloud em app.gizmodata.com — permite provisionar clusters GizmoSQL, catálogos DuckLake, segredos e infraestrutura na AWS, no Google Cloud e no Microsoft Azure em uma única interface, com escopos de organização/projeto/ambiente, acesso baseado em papéis e trilha de auditoria.
Quais nuvens e regiões o GizmoData Cloud oferece?
O plano de dados roda em Kubernetes na AWS (EKS), no Google Cloud (GKE) e no Microsoft Azure (AKS). Organizações de autoatendimento podem começar hoje em AWS US East 2 (Ohio), Google Cloud us-east4 (norte da Virgínia) e Azure East US 2 (Virgínia). Como os catálogos conhecem suas regiões, o GizmoData Cloud pode posicionar a computação perto dos seus dados e bloquear montagens entre regiões que gerariam cobrança de saída de dados (egress).
Posso ter o GizmoData Cloud na minha região?
Sim. Se precisar de computação em uma região onde ainda não operamos — por latência, proximidade dos dados ou residência de dados — solicite em gizmodata.com/contact. Novas regiões estão disponíveis para clientes Business e Enterprise: podemos ativar uma nova região AWS, Google Cloud ou Azure rapidamente, muitas vezes em menos de um dia. Organizações Starter e Team usam as regiões listadas acima.
O plano de controle está vinculado a uma nuvem?
Não. O plano de controle é independente de nuvem e pode gerenciar clusters Kubernetes em várias nuvens ao mesmo tempo. A GizmoData também oferece Cloud at Customer, com plano de controle e planos de dados dentro da sua conta de nuvem — veja gizmodata.com/cloud/at-customer.
O que é um catálogo DuckLake?
DuckLake é o formato lakehouse aberto da equipe DuckDB: um metastore SQL (PostgreSQL) e arquivos Parquet em armazenamento de objetos. No GizmoData Cloud, um catálogo reúne credenciais do metastore, credenciais de armazenamento e caminho dos dados, podendo ser montado em qualquer número de clusters GizmoSQL e compartilhado entre equipes. Para mais detalhes, veja ducklake.select(abre em uma nova aba).
Posso usar um Hive Metastore existente?
Sim. Crie um catálogo Hive Metastore e informe o endereço Thrift do metastore (thrift://host:port) e, opcionalmente, credenciais e o local de armazenamento dos arquivos das tabelas no S3, GCS ou Azure Blob Storage. Os clusters GizmoSQL poderão consultar as tabelas catalogadas e criar novas. Há suporte a metastores Hive 2.x e 3.x (não ao Hive 4). O metastore precisa estar acessível aos clusters GizmoSQL, e a conexão Thrift não tem autenticação; mantenha-a em uma rede privada.
O GizmoData Cloud pode executar consultas federadas em Snowflake, Oracle ou outros bancos?
Sim. Os clusters do GizmoData Cloud executam as imagens de contêiner -adbc do GizmoSQL (v1.38.0+), que incluem 14 drivers ADBC — Snowflake, Oracle, PostgreSQL, IBM Db2, BigQuery, Databricks, Redshift, SQL Server, MySQL, Trino, Exasol, Arrow Flight SQL, DuckDB (Quack) e o próprio GizmoSQL. Crie um segredo ADBC no portal ou na API do GizmoData Cloud, use ATTACH para conectar o banco remoto em SQL e consulte-o em tempo real — combinando suas tabelas com seus catálogos DuckLake em uma única consulta.
Posso experimentar o DuckDB 2.0 no GizmoData Cloud?
Sim, no canal de lançamento experimental Edge. Ao criar um cluster, escolha Edge (experimental) como Release Channel e selecione uma imagem GizmoSQL Edge: ela executa o GizmoSQL v1.41.0 ou posterior sobre uma versão de pré-lançamento do DuckDB 2.0 (hoje, v2.0.0-alpha43763). O Edge serve para avaliar o DuckDB 2.0 com antecedência e não é para cargas de trabalho de produção; os arquivos de banco de dados criados por um cluster Edge não podem ser abertos pelos canais Stable ou LTS. Clusters Edge podem montar seus catálogos DuckLake existentes sem atualizar o formato deles, então seus clusters Stable continuam podendo anexá-los. Stable é o canal padrão, e o LTS também está disponível. Veja gizmodata.com/news#gizmosql-edge-channel-duckdb-2.
Posso usar meu próprio armazenamento?
Sim, para seus dados. A computação é totalmente gerenciada: clusters GizmoSQL são executados em Kubernetes gerenciado pela GizmoData, na nuvem e região escolhidas, sem infraestrutura para cadastrar ou operar. Seus catálogos DuckLake podem usar armazenamento gerenciado pela GizmoData ou seus próprios buckets e metastores PostgreSQL, com credenciais armazenadas como segredos criptografados. Se precisar da plataforma inteira, incluindo computação, nas suas contas de nuvem, veja Cloud at Customer em gizmodata.com/cloud/at-customer.
Como funciona o preço do GizmoData Cloud?
Os planos por autoatendimento são pré-pagos: Starter (US$ 29/mês, até 8 vCPUs em execução simultânea), Team (US$ 99/mês, 32 vCPUs) e Business (US$ 499/mês, 128 vCPUs). A mensalidade retorna integralmente como crédito de computação; os clusters consomem esse crédito pelo preço por hora exibido na criação, e o uso excedente é cobrado pelo mesmo preço. Os tamanhos de computação compartilhada (Pico, Nano e Micro) começam em US$ 0,028 por hora para desenvolvimento e cargas leves. O armazenamento gerenciado — dados de catálogos DuckLake e volumes dos clusters — custa US$ 0,05 por GB-mês. Planos Enterprise com cotas personalizadas, contratos e Cloud at Customer têm preço mediante acordo.
O que acontece com créditos não utilizados? Posso receber créditos promocionais?
O crédito pré-pago de computação vale para o mês pago e expira no fim desse período de cobrança. O crédito promocional — de um convite ou da GizmoData — é um benefício com validade própria, aplica-se apenas ao uso medido e não tem valor em dinheiro. A página de cobrança mostra os dois tipos separadamente, seus saldos e como o período atual está sendo coberto.
Como faço o cadastro?
O GizmoData Cloud está em disponibilidade geral e aberto a todos: cadastre-se em app.gizmodata.com (Google, Microsoft, Apple ou GitHub), crie sua organização e inicie seu primeiro cluster. No lançamento, quem se cadastra por qualquer botão “Comece grátis” deste site recebe, na primeira organização, US$ 25 de crédito de avaliação, aplicado automaticamente, para começar sem cartão de crédito; você escolhe um plano quando o crédito acabar. Se você já usa o GizmoSQL Enterprise, também podemos hospedá-lo para você.
Do blog
Benchmarks, lançamentos e análises aprofundadas de arquitetura no GizmoData Cloud
Três nuvens, uma API: uma corrida TPC-H de 1 TB no GizmoData Cloud (AWS vs. Google Cloud vs. Azure)
Seis clusters GizmoSQL de 64 vCPUs na AWS, no Google Cloud e no Azure disputaram 1 TB de TPC-H em NVMe local e no DuckLake. O Graviton5 fez a volta mais rápida (79 s, US$ 0,30), o Google Cloud levou quatro das seis medalhas de ouro e o DuckDB 2.0 venceu em todas as raias. 38 minutos, cerca de US$ 37, uma API.
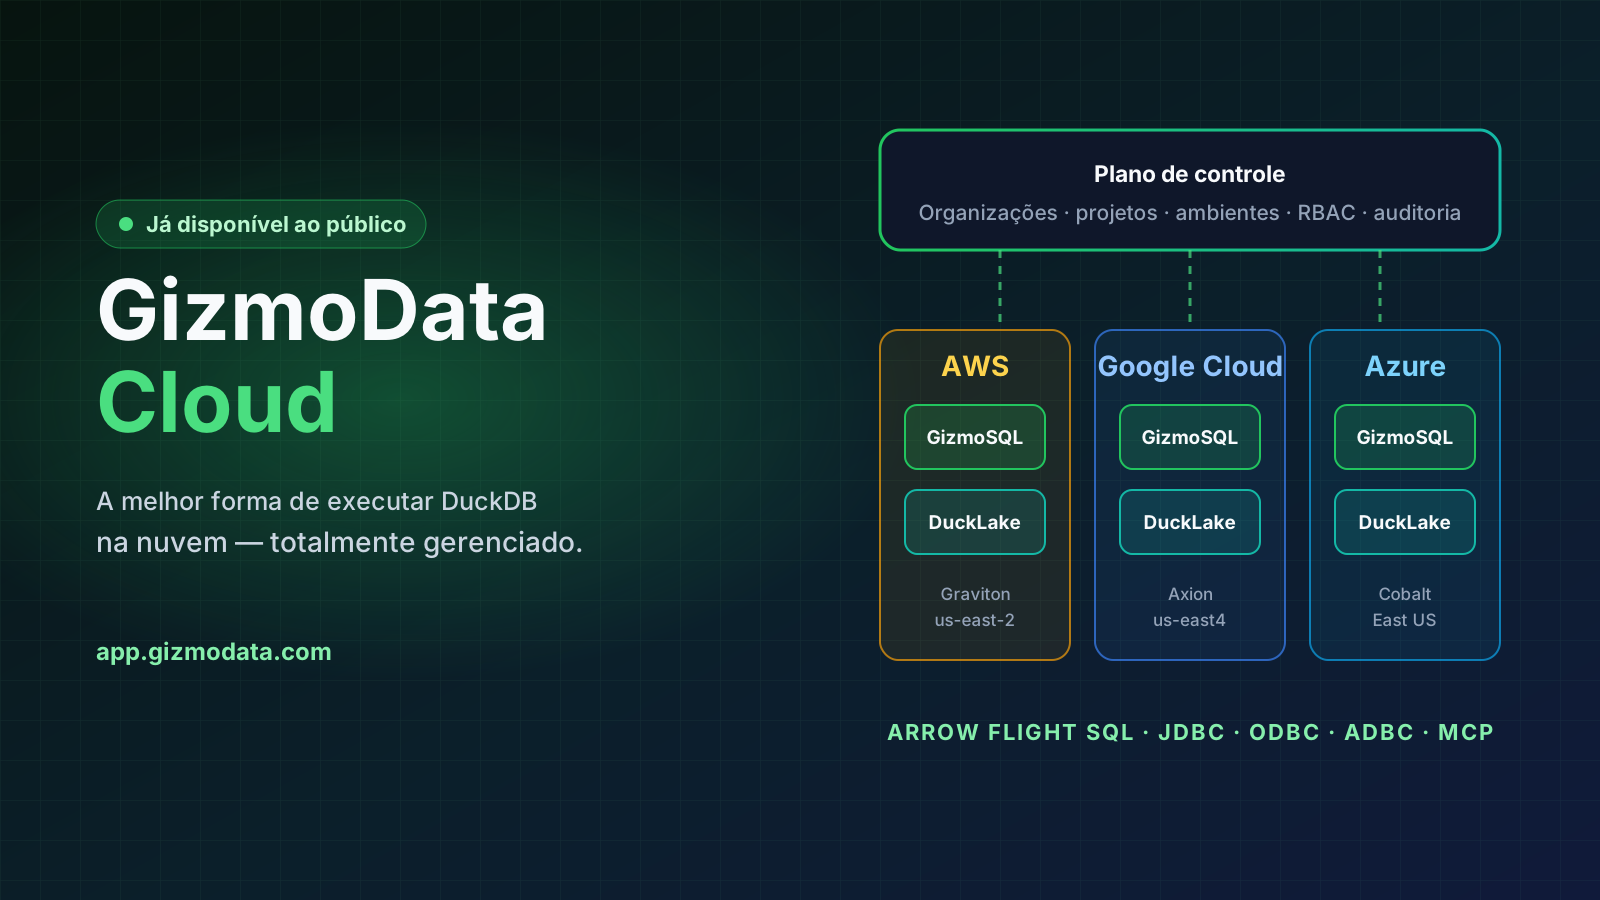
Apresentamos o GizmoData Cloud: a melhor forma de executar DuckDB na nuvem
O GizmoData Cloud está em disponibilidade geral: clusters GizmoSQL totalmente gerenciados, catálogos DuckLake e consultas federadas na AWS, no Google Cloud e no Azure. Cadastre-se grátis. Comece grátis com US$ 25 de crédito de lançamento, aplicado automaticamente, sem cartão de crédito.
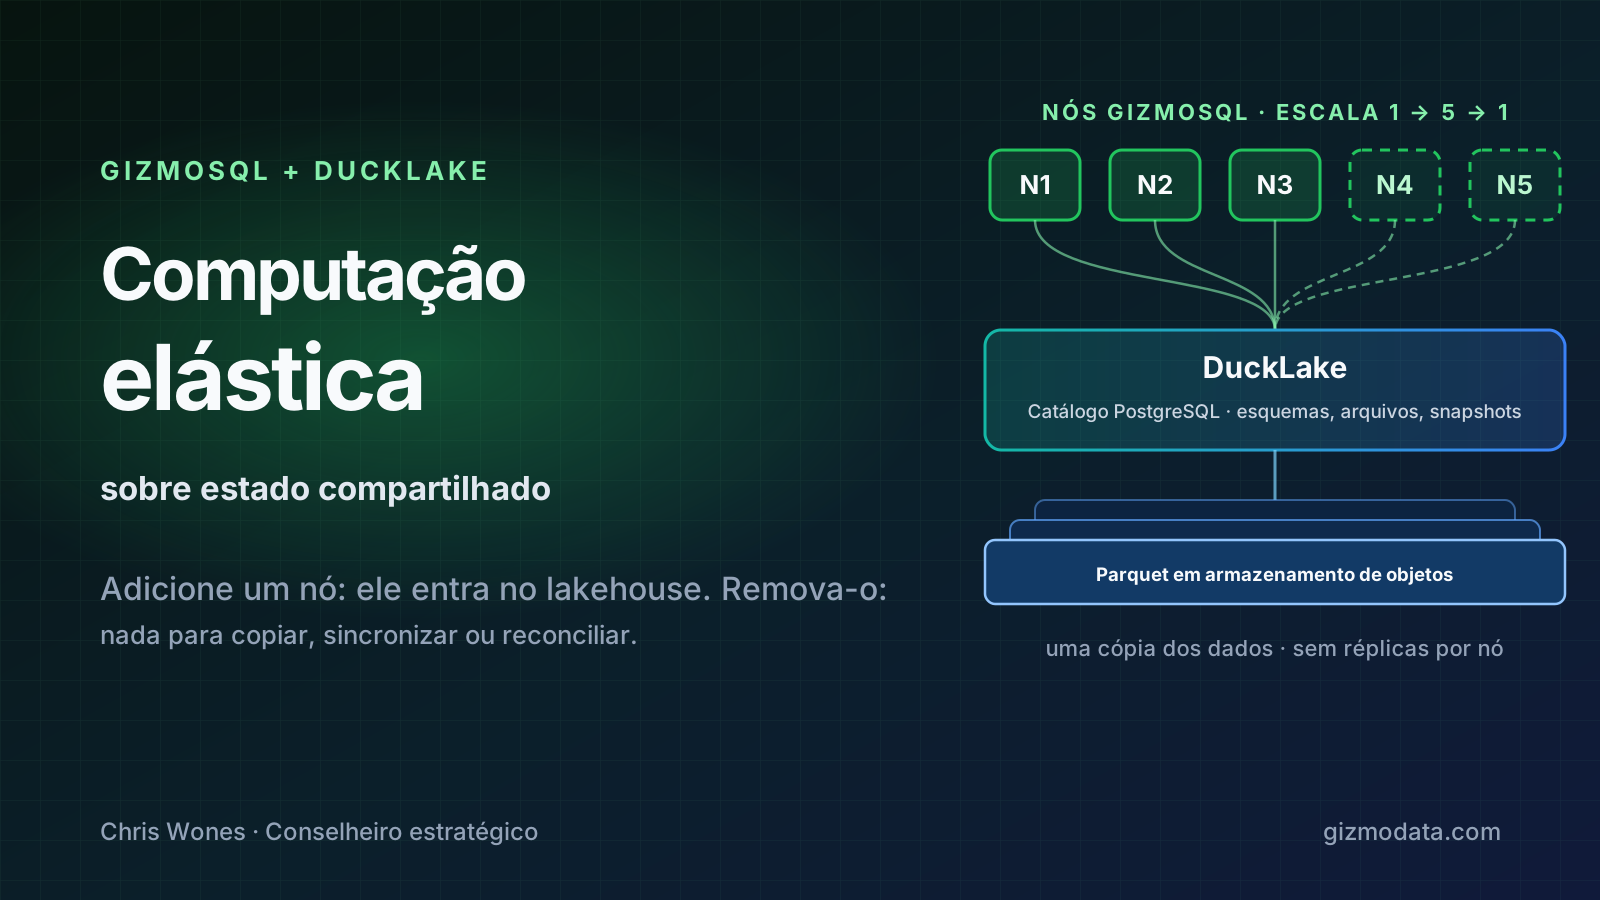
GizmoSQL + DuckLake: computação elástica sobre estado compartilhado
Escalar nós que compartilham dados mutáveis é a parte difícil da análise de dados. Com o DuckLake guardando o catálogo transacional e o Parquet no armazenamento de objetos, um cluster GizmoSQL cresce de um para cinco nós e volta, sem nada para copiar, sincronizar ou reconciliar.
Execute o GizmoSQL onde seus dados estão — sem cuidar da operação
Cadastre-se, crie sua organização e tenha um cluster GizmoSQL em execução em minutos — na AWS, no Google Cloud ou no Azure. Precisa de cotas personalizadas ou de um contrato? Fale conosco.