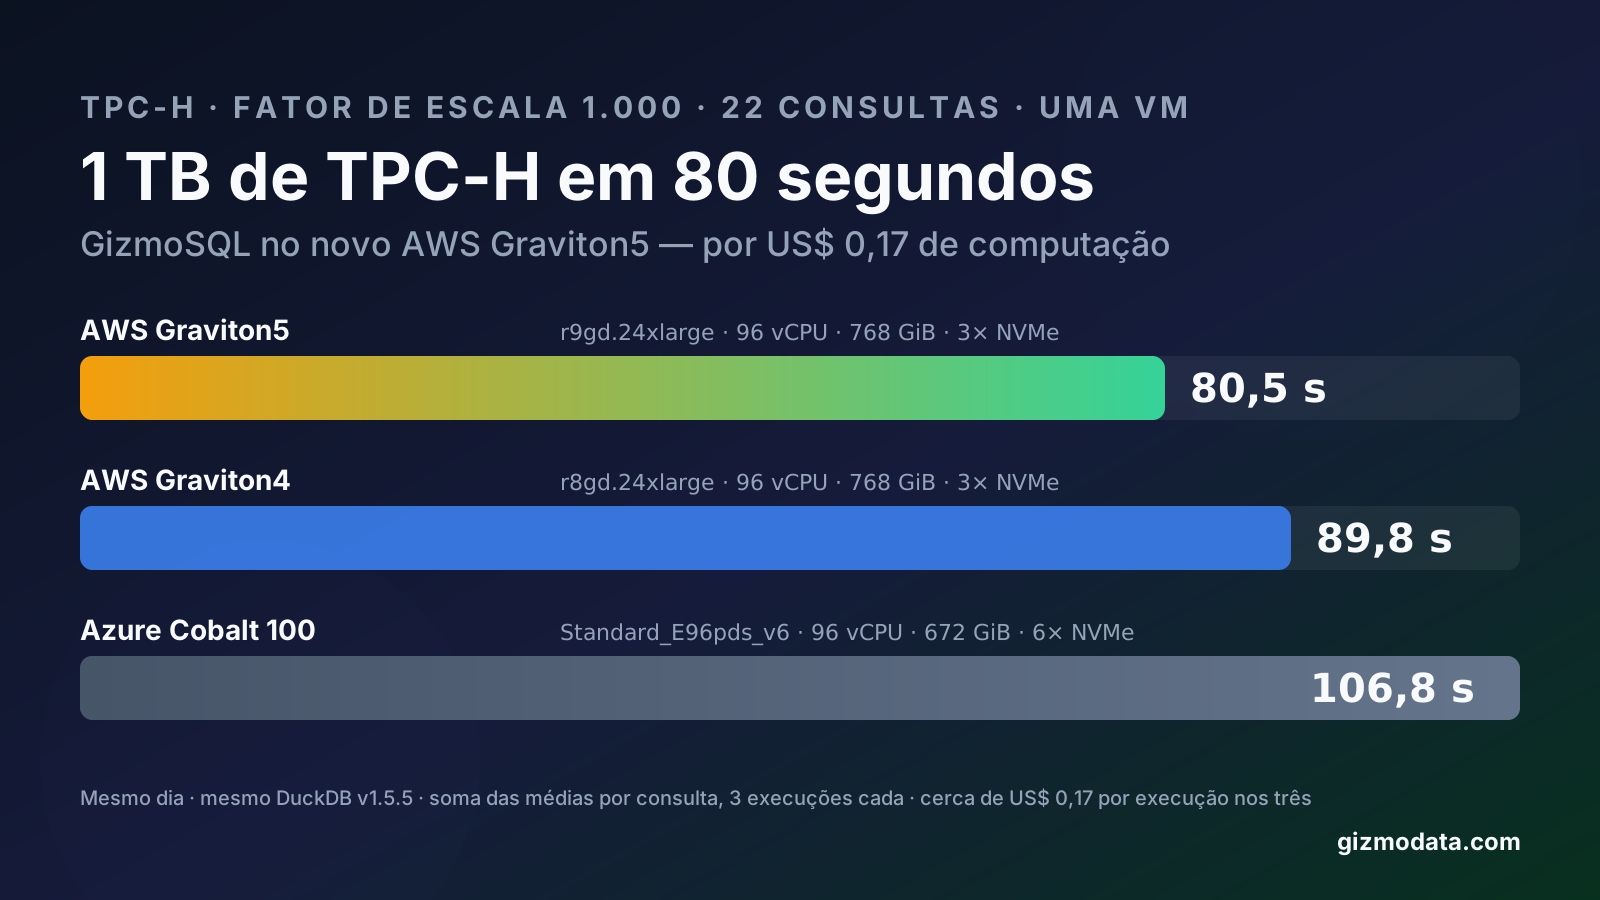
A AWS disponibilizou suas instâncias R9g e R9gd com Graviton5 ao público em 31 de agosto de 2026. Quatro dias depois, executei nosso benchmark padrão TPC-H de 1 TB em uma delas. O GizmoSQL executou as 22 consultas em um total de 80,475 segundos em uma única r9gd.24xlarge. A US$ 7,69 por hora sob demanda, isso representa US$ 0,17 de computação para a execução inteira.
Para medir quanto desse resultado vem do novo chip, executei o mesmo benchmark na mesma tarde, com a mesma versão do GizmoSQL e do DuckDB, em outras duas máquinas Arm de 96 vCPUs: a equivalente Graviton4, uma r8gd.24xlarge na mesma região AWS, e a configuração Azure Cobalt 100 de onde veio nosso resultado anterior, uma Standard_E96pds_v6. O Graviton4 levou 89,831 segundos. O Cobalt 100 levou 106,806 segundos. Nessa carga de trabalho, o Graviton5 é 10% mais rápido que o Graviton4 e 25% mais rápido que o Cobalt 100, com o mesmo número de núcleos, e vence a máquina Azure em todas as 22 consultas. Como a execução é mais curta, seu custo por execução também não é maior, apesar do maior preço por hora entre as três.
Este artigo explica exatamente como o benchmark é executado, compara as três máquinas lado a lado, apresenta os tempos de cada consulta nas três execuções e discute o que isso diz sobre Arm na nuvem.
Os principais números
| AWS Graviton5 | AWS Graviton4 | Azure Cobalt 100 | |
|---|---|---|---|
| Instância | r9gd.24xlarge | r8gd.24xlarge | Standard_E96pds_v6 |
| vCPUs | 96 | 96 | 96 |
| Memória | 768 GiB | 768 GiB | 672 GiB |
| NVMe local | 3 × 1.900 GB | 3 × 1.900 GB | 6 × 880 GiB |
| Região | us-east-2 (Ohio) | us-east-2 (Ohio) | East US |
| Mecanismo DuckDB | v1.5.5 | v1.5.5 | v1.5.5 |
| Preço sob demanda | US$ 7,69 / hora | US$ 7,05 / hora | US$ 5,62 / hora |
| TPC-H de 1 TB, 22 consultas | 80,475 s | 89,831 s | 106,806 s |
| Custo de computação por execução | US$ 0,172 | US$ 0,176 | US$ 0,167 |
As três máquinas têm 96 vCPUs, são configurações otimizadas para memória com NVMe local e usam Arm. As três execuções ocorreram em um intervalo de cerca de uma hora em 4 de setembro de 2026, com a mesma versão do GizmoSQL, o mesmo DuckDB v1.5.5, os mesmos dados e o mesmo operador. É o máximo de controle possível em um benchmark entre nuvens. Para referência, nosso resultado Azure publicado anteriormente era de 108,88 segundos; os 106,806 de hoje na mesma configuração mostram uma melhora de cerca de 2% no DuckDB nesse intervalo, portanto a diferença para o Graviton5 vem quase toda do hardware.
Metodologia
Executo o teste da mesma forma em todas as nuvens, para que os números sejam comparáveis entre provedores e ao longo do tempo. Nada aqui é ajustado por consulta.
1. Provisione uma VM com NVMe local
Escolho a família de instâncias com discos NVMe locais na nuvem de destino, porque análises nessa escala dependem tanto da largura de banda de armazenamento quanto da CPU. Na AWS, isso corresponde ao sufixo d (r9gd, r8gd); no Azure, ao d de E96pds_v6. O armazenamento em bloco pela rede acrescentaria uma variável indesejada à medição.
Também paro deliberadamente em 96 vCPUs. As três configurações têm um único nó NUMA: cada núcleo acessa todos os bytes de memória com a mesma latência. Os tamanhos 48xlarge de 192 vCPUs têm dois nós NUMA (dois soquetes no Graviton4; duas regiões de memória no único chip de 192 núcleos do Graviton5), e um processo DuckDB que precisa buscar tabelas hash através dessa fronteira não escala de forma próxima à linear. Mais detalhes adiante.
2. Combine os discos NVMe em um volume RAID 0
Os discos chegam como dispositivos brutos separados. Eu os combino em um único arranjo RAID 0, para que o DuckDB veja um volume rápido com a taxa de transferência agregada de todos os discos. O RAID 0 não tem redundância, o que é aceitável aqui: os dados do benchmark são reproduzíveis e o volume é efêmero por definição.
# Three NVMe drives on the r9gd/r8gd 24xlarge; the Azure VM had six
sudo mdadm --create /dev/md0 --level=0 --raid-devices=3 \
  /dev/nvme1n1 /dev/nvme2n1 /dev/nvme3n1
sudo mkfs.ext4 -F /dev/md0
sudo mkdir -p /data && sudo mount /dev/md0 /data
3. Copie os dados Parquet TPC-H de fator de escala 1.000 para o volume
O conjunto é o TPC-H com fator de escala 1.000, aproximadamente 1 TB sem compressão, armazenado em Parquet com um diretório por tabela. Eu o gero com nosso utilitário de código aberto tpch-datagen, que usa DuckDB e multiprocessamento para produzir as tabelas em paralelo, e o preparo em armazenamento de objetos para que toda execução comece com bytes idênticos. A cópia para o volume RAID 0 não faz parte do tempo medido.
4. Carregue os arquivos Parquet em tabelas GizmoSQL
Com o GizmoSQL apontando para um novo arquivo de banco DuckDB no volume NVMe, carrego cada tabela com um CREATE TABLE ... AS SELECT sobre um padrão glob do diretório Parquet correspondente. Oito tabelas, oito instruções:
CREATE TABLE lineitem AS SELECT * FROM read_parquet('/data/tpch/sf1000/lineitem/*.parquet');
CREATE TABLE orders   AS SELECT * FROM read_parquet('/data/tpch/sf1000/orders/*.parquet');
CREATE TABLE customer AS SELECT * FROM read_parquet('/data/tpch/sf1000/customer/*.parquet');
CREATE TABLE part     AS SELECT * FROM read_parquet('/data/tpch/sf1000/part/*.parquet');
CREATE TABLE partsupp AS SELECT * FROM read_parquet('/data/tpch/sf1000/partsupp/*.parquet');
CREATE TABLE supplier AS SELECT * FROM read_parquet('/data/tpch/sf1000/supplier/*.parquet');
CREATE TABLE nation   AS SELECT * FROM read_parquet('/data/tpch/sf1000/nation/*.parquet');
CREATE TABLE region   AS SELECT * FROM read_parquet('/data/tpch/sf1000/region/*.parquet');
O tempo de ingestão também não faz parte do resultado. O objetivo do benchmark é medir o desempenho das consultas no armazenamento nativo do DuckDB, que é como o GizmoSQL roda em produção.
5. Execute as 22 consultas em ordem, três vezes cada
A execução usa nossa ferramenta de código aberto benchmark-flight-sql. Ela se conecta ao servidor GizmoSQL pelo Apache Arrow Flight SQL, como um cliente real, e executa as 22 consultas padrão do TPC-H em ordem. Cada consulta é executada três vezes seguidas antes da próxima. O tempo decorrido e a contagem de linhas de cada execução são gravados em um arquivo JSON.
benchmark-flight-sql \
  --hostname ec2-XX-XX-XX-XX.us-east-2.compute.amazonaws.com \
  --port 443 \
  --username scott \
  --password '...' \
  --num-query-runs 3
6. Calcule a média de cada consulta e some as médias
Para cada consulta, calculo a média das três execuções. O resultado do benchmark é a soma dessas 22 médias: os 80,475 segundos. Deliberadamente, não uso o "melhor de três": a primeira execução de cada consulta costuma ser a mais lenta porque o cache de páginas do sistema operacional está frio, e ela entra na conta.
As três máquinas, consulta por consulta
Média de três execuções por consulta, em segundos; quanto menor, melhor. O Graviton5 tem a barra mais curta nos 22 grupos. O rótulo à direita mostra quanto tempo a menos ele levou em relação ao Cobalt 100 naquela consulta. Passe o cursor sobre uma barra para ver o valor exato.
Mostrar os números brutos (as três execuções por consulta)
Dados diretamente dos arquivos de saída da ferramenta; as 66 execuções foram bem-sucedidas em todas as máquinas. As duas colunas de razão dividem a média do Graviton5 pelas médias do Graviton4 e do Cobalt 100; assim, 0,74 significa que o Graviton5 levou 74% do tempo.
| Consulta | G5 execução 1 | G5 execução 2 | G5 execução 3 | G5 média (s) | G4 média (s) | Cobalt média (s) | G5 / G4 | G5 / Cobalt |
|---|---|---|---|---|---|---|---|---|
| Q1 | 5,35 | 1,69 | 1,68 | 2,905 | 3,913 | 4,738 | 0,74 | 0,61 |
| Q2 | 0,85 | 0,47 | 0,55 | 0,624 | 0,700 | 0,851 | 0,89 | 0,73 |
| Q3 | 2,69 | 2,50 | 2,50 | 2,561 | 2,709 | 3,323 | 0,95 | 0,77 |
| Q4 | 3,09 | 2,23 | 2,37 | 2,563 | 3,184 | 3,718 | 0,81 | 0,69 |
| Q5 | 2,31 | 2,06 | 2,34 | 2,237 | 2,593 | 3,273 | 0,86 | 0,68 |
| Q6 | 0,60 | 0,62 | 0,58 | 0,599 | 0,732 | 0,793 | 0,82 | 0,76 |
| Q7 | 1,82 | 2,00 | 2,31 | 2,042 | 2,272 | 2,816 | 0,90 | 0,73 |
| Q8 | 2,02 | 1,82 | 2,50 | 2,115 | 2,491 | 3,381 | 0,85 | 0,63 |
| Q9 | 14,16 | 13,57 | 13,86 | 13,865 | 14,744 | 17,420 | 0,94 | 0,80 |
| Q10 | 6,05 | 4,30 | 4,48 | 4,947 | 5,874 | 5,909 | 0,84 | 0,84 |
| Q11 | 1,20 | 0,84 | 0,50 | 0,847 | 0,905 | 1,070 | 0,94 | 0,79 |
| Q12 | 1,39 | 1,58 | 1,64 | 1,537 | 1,695 | 2,122 | 0,91 | 0,72 |
| Q13 | 7,55 | 8,72 | 8,81 | 8,360 | 8,926 | 9,660 | 0,94 | 0,87 |
| Q14 | 3,23 | 2,15 | 2,07 | 2,487 | 2,407 | 3,182 | 1,03 | 0,78 |
| Q15 | 1,37 | 0,97 | 1,18 | 1,173 | 1,217 | 1,568 | 0,96 | 0,75 |
| Q16 | 2,53 | 2,12 | 1,95 | 2,199 | 2,207 | 3,792 | 1,00 | 0,58 |
| Q17 | 2,52 | 2,05 | 2,77 | 2,446 | 2,819 | 3,719 | 0,87 | 0,66 |
| Q18 | 9,73 | 10,27 | 10,22 | 10,075 | 10,811 | 11,462 | 0,93 | 0,88 |
| Q19 | 2,53 | 2,72 | 2,34 | 2,530 | 3,074 | 3,498 | 0,82 | 0,72 |
| Q20 | 2,68 | 2,53 | 2,62 | 2,611 | 3,089 | 3,961 | 0,85 | 0,66 |
| Q21 | 8,17 | 12,03 | 8,85 | 9,686 | 11,318 | 13,783 | 0,86 | 0,70 |
| Q22 | 2,46 | 1,78 | 1,96 | 2,066 | 2,151 | 2,767 | 0,96 | 0,75 |
| Total | 84.29 | 79.04 | 78.10 | 80.475 | 89.831 | 106.806 | 0.90 | 0.75 |
Alguns pontos que merecem atenção:
- O Graviton5 vence o Graviton4 em 20 das 22 consultas e o Cobalt 100 em todas as 22. Contra o Graviton4, Q14 e Q16 ficam empatadas (dentro da variação entre execuções), e as demais são de 4% a 26% mais rápidas. Contra o Cobalt 100, o menor ganho é de 12% (Q18) e o maior, de 42% (Q16), seguido de perto pela Q1, com 39%.
- As consultas com varredura intensa tiveram os maiores ganhos. A Q1 (uma passagem completa pela tabela
lineitemde seis bilhões de linhas) caiu 26%, e Q4, Q6, Q19, Q10 e Q20 caíram de 15% a 19%. Essas consultas percorrem colunas pela CPU tão rápido quanto a memória consegue alimentá-la, exatamente onde a memória DDR5-8800 mais rápida do Graviton5 deve fazer diferença. - As grandes junções ganharam menos. Q9, Q13 e Q18, as três junções múltiplas mais pesadas, melhoraram de 6% a 7%. Elas ainda concentram o tempo: essas três, mais a Q21, respondem por cerca de 42 dos 80 segundos no Graviton5.
- A passagem com cache frio é onde a máquina Azure mais sofre. A primeira passagem totaliza 84,3 s no Graviton5, 96,1 s no Graviton4 e 117,9 s no Cobalt 100; só a primeira execução da Q1 leva 5,4 s, 7,5 s e 10,0 s, respectivamente. Se reportássemos apenas execuções com cache quente, o resultado do Graviton5 seria de 78 segundos. Não fazemos isso.
- Doze das 22 consultas terminam em menos de 2,5 segundos sobre um terabyte de dados, pela rede, por meio de um cliente Flight SQL. Essa é a parte que ainda me parece inacreditável.
Por que o Graviton5 cumpre o que promete
Dez por cento sobre o Graviton4 pode não parecer uma manchete, então vale contextualizar. É uma única geração, em uma carga limitada pela largura de banda da memória e pela taxa de transferência do NVMe, não pela aritmética de cada núcleo, medida sem nenhuma mudança de software: não recompilei, reajustei nem alterei uma configuração entre as três execuções. O mesmo binário simplesmente rodou 10% mais rápido que no Graviton4 e 25% mais rápido que no Cobalt 100. A execução no Graviton5 custou 2% menos que no Graviton4, embora a instância custe 9% mais por hora. É desempenho gratuito, que se acumula a cada versão do DuckDB.
As informações da própria AWS sobre o chip explicam de onde vem o ganho:
- Até 25% mais desempenho de computação por vCPU em relação ao Graviton4. Observamos 10% em uma carga analítica intensa em E/S e memória; cargas limitadas por computação devem ganhar mais.
- Memória DDR5-8800, contra DDR5-5600 no Graviton4. SQL analítico nessa escala transmite colunas pela CPU, e a largura de banda da memória é o limite. Isso é coerente com os maiores ganhos nas consultas de varredura intensa.
- Cinco vezes o cache L3 do Graviton4. Junções hash e agregações sobre centenas de milhões de grupos dependem das taxas de acerto do cache, e Q9, Q18 e Q21 são exatamente esse tipo de consulta.
- Até 192 vCPUs nos maiores tamanhos. Usei a 24xlarge, com 96, para manter o mesmo número de núcleos das outras duas execuções. Há uma 48xlarge com o dobro de núcleos e memória esperando a próxima rodada.
As ressalvas: cada máquina recebeu uma execução do benchmark, em uma tarde de quinta-feira, portanto um ou dois pontos percentuais da diferença podem ser ruído. A máquina Azure tem 672 GiB de memória contra 768 GiB na AWS, além de NVMe diferente (seis discos de 880 GiB contra três de 1.900 GB); a comparação entre nuvens inclui a plataforma, não apenas a CPU. Além disso, Cobalt 100 é o chip Arm de primeira geração da Microsoft; Graviton5 é o de quinta geração da Amazon. Graviton5 contra Graviton4 é a comparação mais controlada, e a que eu citaria: mesma nuvem, mesma região, mesma configuração de instância, uma geração de diferença e 10% mais velocidade. A 48xlarge é a próxima da lista.
Quanto custa
A conta é simples: segundos divididos por 3.600, multiplicados pelo preço por hora sob demanda.
Graviton5   80.475 s ÷ 3,600 × $7.689/hr = $0.172
Graviton4   89.831 s ÷ 3,600 × $7.054/hr = $0.176
Cobalt 100 106.806 s ÷ 3,600 × $5.616/hr = $0.167
Os três valores arredondam para US$ 0,17 por execução completa do TPC-H de 1 TB, o número que já publicamos há algum tempo. Isso significa que nossa comparação com os data warehouses na nuvem não muda em custo: nessa carga, o custo por execução do GizmoSQL continua sendo aproximadamente 1/16 do Snowflake, 1/31 do Databricks SQL e 1/138 do BigQuery. O que muda é a velocidade. Com 80,5 segundos, o GizmoSQL agora é mais rápido que todos eles, inclusive os 103,4 segundos do Snowflake, que antes nos superava ligeiramente no tempo, mas custava 16 vezes mais.
E esses são preços sob demanda. O preço spot das instâncias Graviton costuma ser uma fração desse valor; para uma tarefa de análise em lote que termina em 80 segundos, spot é uma opção perfeitamente razoável.
O que importa é a competição
Esta é a parte que considero mais importante do que qualquer número isolado. O GizmoSQL é um processo executado em uma máquina, construído sobre o DuckDB, que é compilado para Arm e fica mais rápido a cada versão. Assim, sempre que um provedor de nuvem lança uma CPU melhor, todos os usuários do GizmoSQL recebem a melhoria no mesmo dia, gratuitamente, alterando uma string no script de inicialização. Sem trocar de plataforma, mudar de faixa de preço ou esperar que um fornecedor "passe a dar suporte" ao novo tipo de instância. Hoje, essa string foi r9gd.24xlarge.
E a competição está longe de acabar:
- Azure Cobalt 200 é a resposta da Microsoft exatamente a esse resultado. É um chip de 132 núcleos com Arm Neoverse V3 e fabricação TSMC de 3 nm, e a Microsoft afirma que ele oferece mais de 50% de ganho de desempenho sobre o Cobalt 100 em cargas reais. Se metade disso aparecer no TPC-H, o Cobalt 200 ultrapassará o Graviton4 e ficará perto do Graviton5. A Microsoft informa que a disponibilidade geral chegará mais adiante em 2026. Executaremos este mesmo benchmark na semana em que ele estiver disponível.
- Google Cloud Axion é o terceiro concorrente Arm. A família C4A usa Neoverse V2, a mesma geração de núcleos do Graviton4, e suas configurações
-lssdincluem até 6 TiB de SSD Titanium local, exatamente o que este benchmark precisa. A C4A chega a 72 vCPUs, portanto não permite uma comparação equivalente de 96 núcleos, mas o GizmoData Cloud já provisiona GizmoSQL em C4A, e um resultado do Axion merece entrar nesta tabela. Ele virá. - Os tamanhos 48xlarge e o NUMA. Dobrar para 192 vCPUs em qualquer geração também significa passar de um nó NUMA para dois. Na minha experiência, é aí que a escalabilidade linear de um único processo DuckDB deixa de funcionar: junções hash e agregações que cabem com folga na memória de um soquete passam a gastar tempo transferindo dados pela interconexão. A 48xlarge do Graviton4 tem dois soquetes de 96 núcleos. A do Graviton5 tem um chip de 192 núcleos com duas regiões NUMA, e a AWS afirma que a latência entre núcleos é cerca de um terço menor. Ela pode ser a primeira 48xlarge em que o segundo nó se paga nessa carga. Medir isso, e verificar se dois processos GizmoSQL fixados em nós NUMA superam um único processo grande, merece um artigo próprio.
Amazon, Microsoft e Google investem bilhões para que seus chips Arm superem os outros dois. Clientes de Snowflake, Databricks e BigQuery recebem esses ganhos na medida em que o fornecedor decide repassá-los — se decidir. Clientes GizmoSQL recebem o ganho inteiro, pelo preço por hora da VM. Essa é a vantagem estrutural de um mecanismo de nó único em hardware comum de nuvem, e ela aumenta a cada geração.
Reproduza o teste
Tudo aqui é de código aberto, e as etapas são as descritas acima. O gerador de dados é o gizmodata/tpch-datagen, o executor de consultas é o gizmodata/benchmark-flight-sql, e o GizmoSQL Core é gratuito, licenciado sob Apache-2.0 e instalado com um comando. Se obtiver um resultado diferente na mesma configuração, quero saber.
Se sua equipe paga um data warehouse por crédito, DBU ou byte varrido para responder a perguntas como essas, veja o que uma VM Arm bem dimensionada faz por US$ 0,17. Ajudamos você a migrar a carga de trabalho e garantimos a redução da conta pela metade.