
No mês passado, uma única máquina AWS Graviton5 executou nosso benchmark TPC-H de 1 TB, com 22 consultas, em 80 segundos. Encerrei aquele artigo com uma promessa: a disputa entre os chips Arm das nuvens continuaria. Então organizamos uma corrida de verdade. Seis clusters GizmoSQL na AWS, no Google Cloud e no Azure, todos com 64 vCPUs e NVMe local. Cada um executou o benchmark completo de 1 TB de duas formas: uma vez no NVMe local e outra em um catálogo DuckLake no armazenamento de objetos da própria nuvem, usando tanto a versão atual do DuckDB quanto a versão alpha do DuckDB 2.0.
Foram 12 resultados e todas as 792 execuções de consultas foram concluídas com sucesso. A corrida inteira, da criação do primeiro cluster à exclusão do último, levou 38 minutos e custou cerca de US$ 37 no GizmoData Cloud. A volta mais rápida foi a do AWS Graviton5 em NVMe local com a versão alpha do DuckDB 2.0: 79 segundos para executar as 22 consultas sobre 1 TB, por US$ 0,30. Isso supera os 80,5 segundos do mês passado usando um terço a menos de núcleos. Se sua equipe paga um data warehouse por crédito, DBU ou byte lido, aqui é isso que 64 vCPUs e 1 TB custam: cerca de 30 centavos.
A configuração que a maioria das equipes nunca consegue montar
Antes dos cavalos, os boxes. Um benchmark justo entre nuvens envolve principalmente infraestrutura. Antes de executar uma única consulta, é preciso ter o mesmo mecanismo, os mesmos dados e as mesmas configurações em três nuvens — e desmontar tudo antes de pagar pelo fim de semana.
Fazendo por conta própria exige:
- Três contas de nuvem, com faturamento configurado e a cota de 64 vCPUs liberada em cada uma (o Google Cloud também tem uma cota separada por família para as máquinas Axion).
- Redes, clusters Kubernetes ou máquinas virtuais e discos NVMe locais preparados em cada nuvem.
- Certificados TLS, registros DNS e balanceadores de carga para cada servidor.
- Gerar 1 TB de dados TPC-H e copiá-los para três armazenamentos de objetos.
- Um catálogo Postgres por região para o DuckLake, além das credenciais de armazenamento de cada nuvem.
- Instalar e configurar o mecanismo de 12 maneiras (três nuvens, duas versões e dois modos de armazenamento).
- Lembrar de excluir tudo no final.
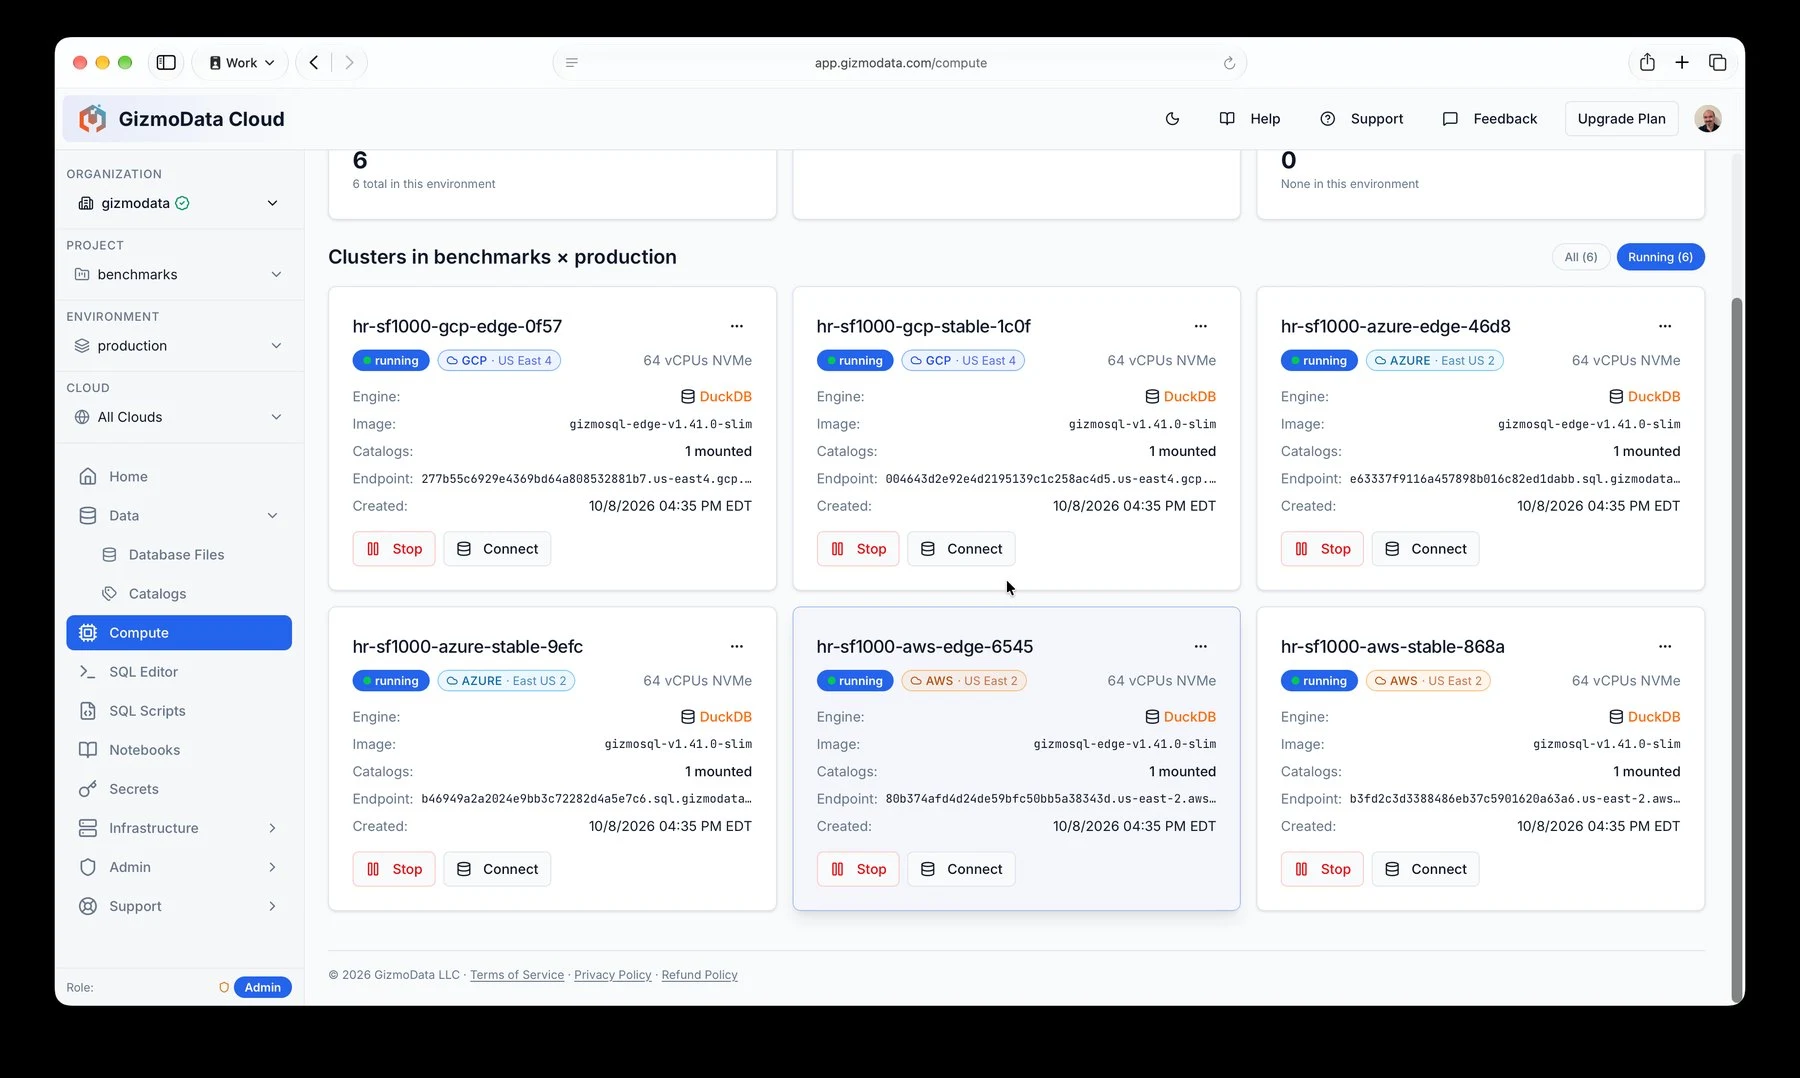
No GizmoData Cloud bastou:
- Uma chamada de API por cluster, informando a região da nuvem, o tamanho da máquina e o canal de lançamento do GizmoSQL.
- Um script SQL de inicialização que carrega o banco TPC-H de 1 TB no NVMe local do cluster durante a inicialização.
- Um catálogo DuckLake com os mesmos dados no armazenamento de objetos da própria nuvem, montado durante a criação.
- Um balanceador de carga, certificado TLS e nome de host para cada cluster nas três nuvens, sem nenhuma configuração manual.
- Um sinal de "pronto para conectar", para que o benchmark comece assim que os dados estiverem disponíveis.
- Encerramento automático como proteção e uma chamada de exclusão assim que cada competidor termina.
Os clusters da AWS estavam ativos, com o terabyte completo carregado no NVMe e verificado, cerca de 5 minutos após a chamada de API. Os clusters do Google Cloud ficaram prontos em cerca de 7 minutos. Cada competidor foi excluído assim que terminou a última consulta, por isso a corrida inteira custou cerca de US$ 37.
Execute a mesma corrida na sua região. Comece gratuitamente com US$ 25 em crédito de lançamento, aplicado automaticamente.
Comece gratuitamente no GizmoData Cloud →Resultados
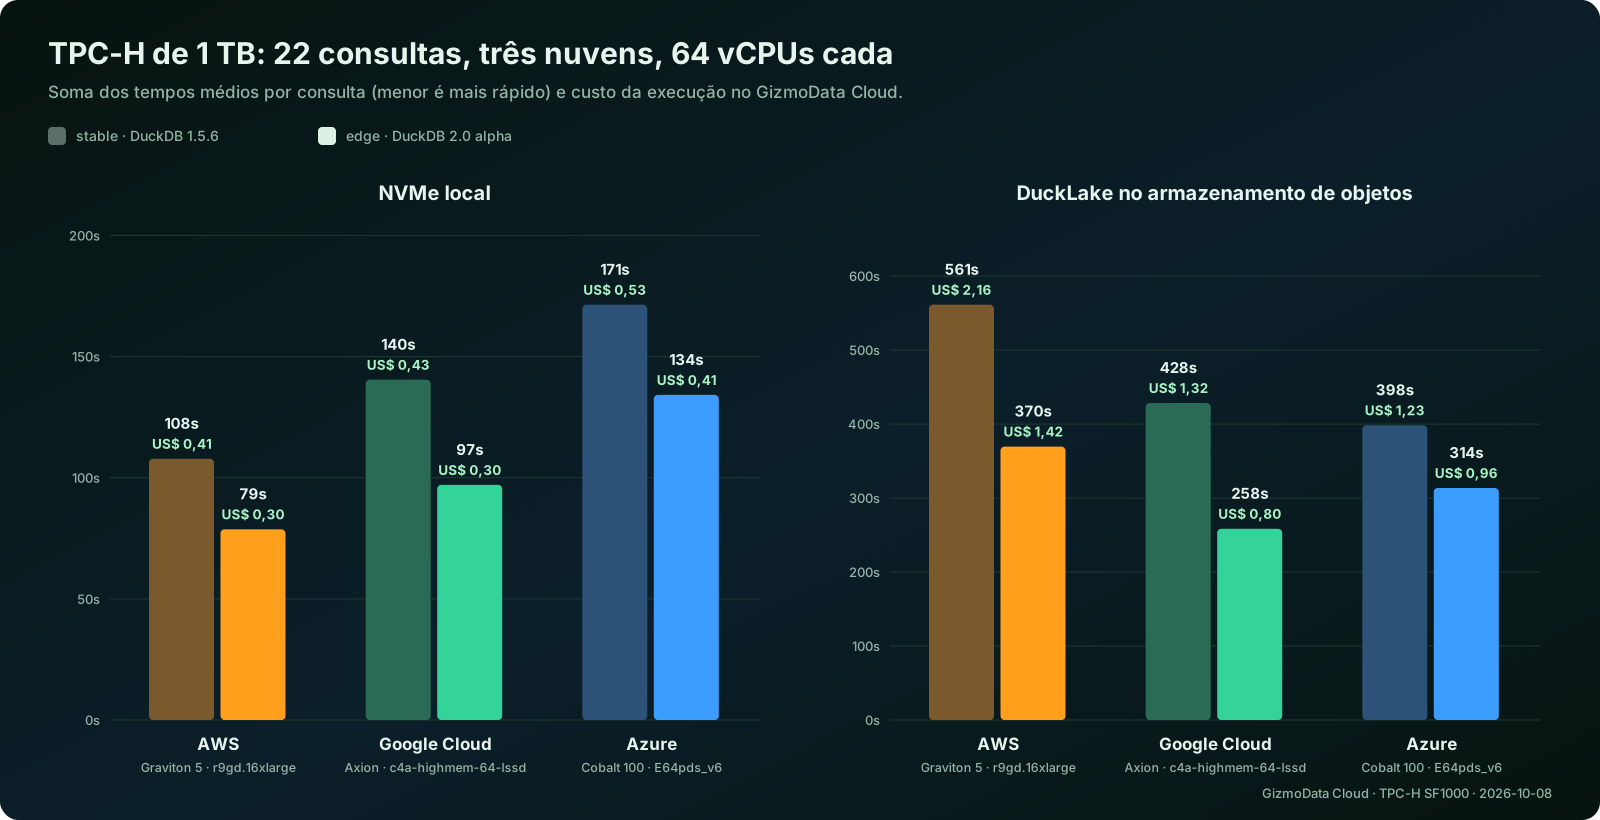
Cada número representa a soma dos tempos médios das 22 consultas TPC-H (quanto menor, mais rápido). Abaixo aparece o custo dessa execução no GizmoData Cloud, edição Enterprise. Stable é o GizmoSQL v1.41.0 com DuckDB 1.5.6; edge é o GizmoSQL v1.41.0 com a versão alpha do DuckDB 2.0.
Mais rápido: AWS Graviton5, 79 s · Mais barato: Google Cloud, cerca de US$ 0,30 (um quarto de centavo abaixo da AWS) · Melhor no armazenamento de objetos: Google Cloud, 258 s
| 64 vCPUs | NVMe · stable | NVMe · edge | DuckLake · stable | DuckLake · edge |
|---|---|---|---|---|
AWSr9gd.16xlarge (Graviton5) | 108 s US$ 0,41 | 79 s US$ 0,30 | 561 s US$ 2,16 | 370 s US$ 1,42 |
Google Cloudc4a-highmem-64-lssd (Axion) | 140 s US$ 0,43 | 97 s US$ 0,30 | 428 s US$ 1,32 | 258 s US$ 0,80 |
AzureStandard_E64pds_v6 (Cobalt 100) | 171 s US$ 0,53 | 134 s US$ 0,41 | 398 s US$ 1,23 | 314 s US$ 0,96 |
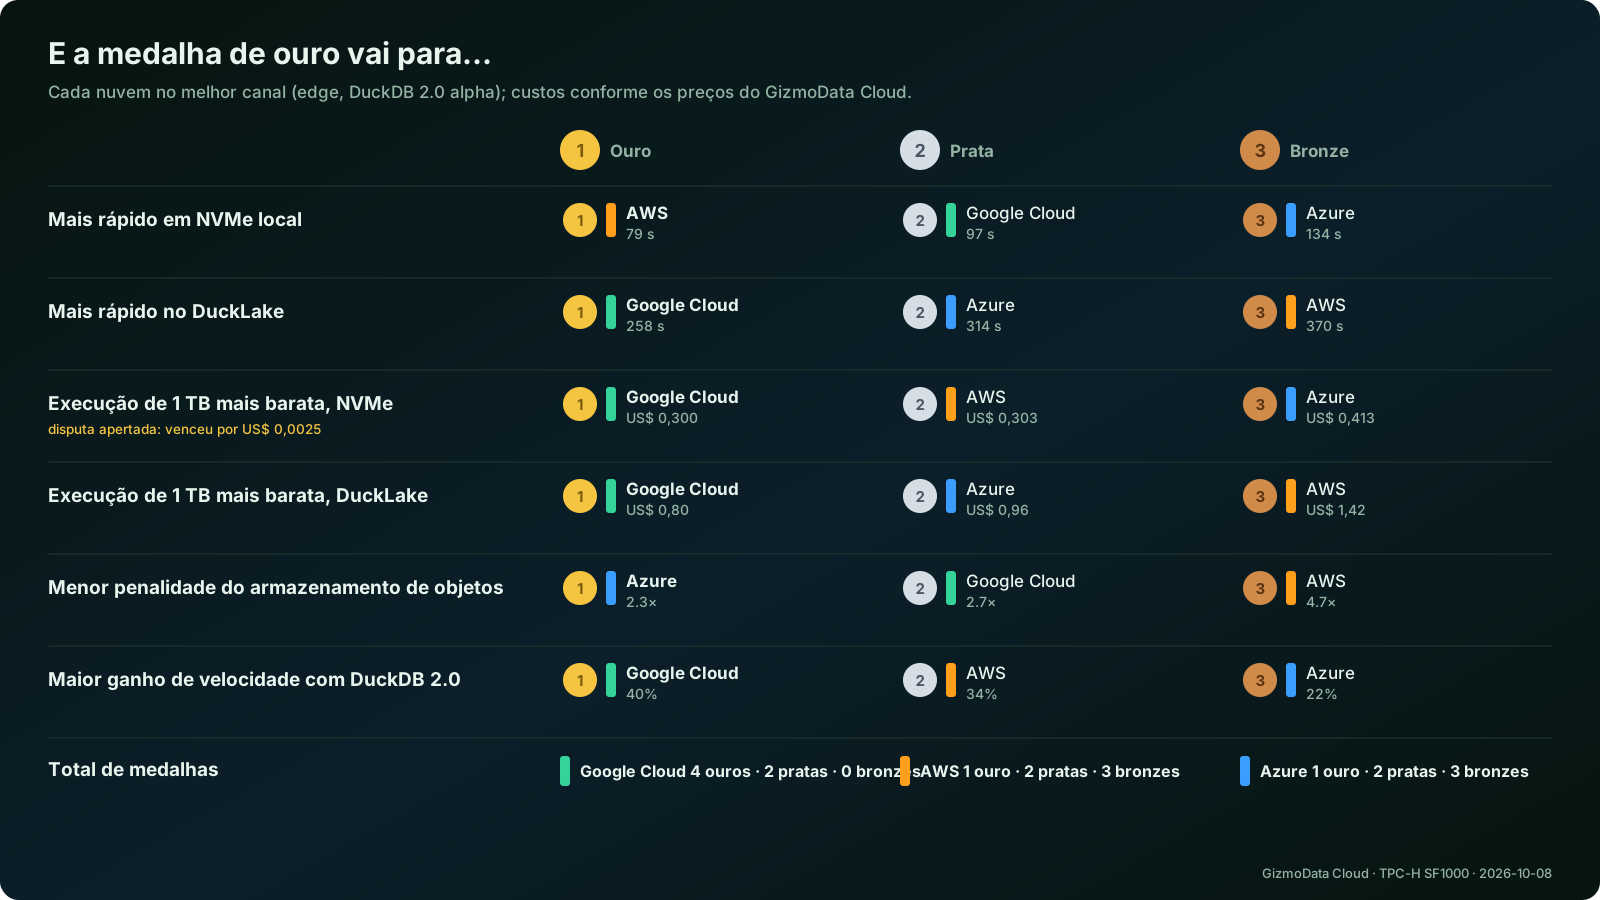
E a medalha de ouro vai para…
Avaliamos seis categorias, com cada nuvem no seu melhor canal (edge).
- O Google Cloud leva quatro ouros: a execução mais rápida no DuckLake, a mais barata tanto em NVMe local quanto no DuckLake e o maior ganho de velocidade com o DuckDB 2.0.
- A AWS leva o ouro em velocidade absoluta: a execução mais rápida em NVMe local, com 79 segundos para as 22 consultas.
- O Azure leva o ouro pela menor penalidade do armazenamento de objetos: sua execução no DuckLake levou apenas 2,3 vezes o tempo da execução em NVMe.
A disputa pela execução mais barata em NVMe foi apertada: o Google Cloud venceu a AWS por um quarto de centavo.
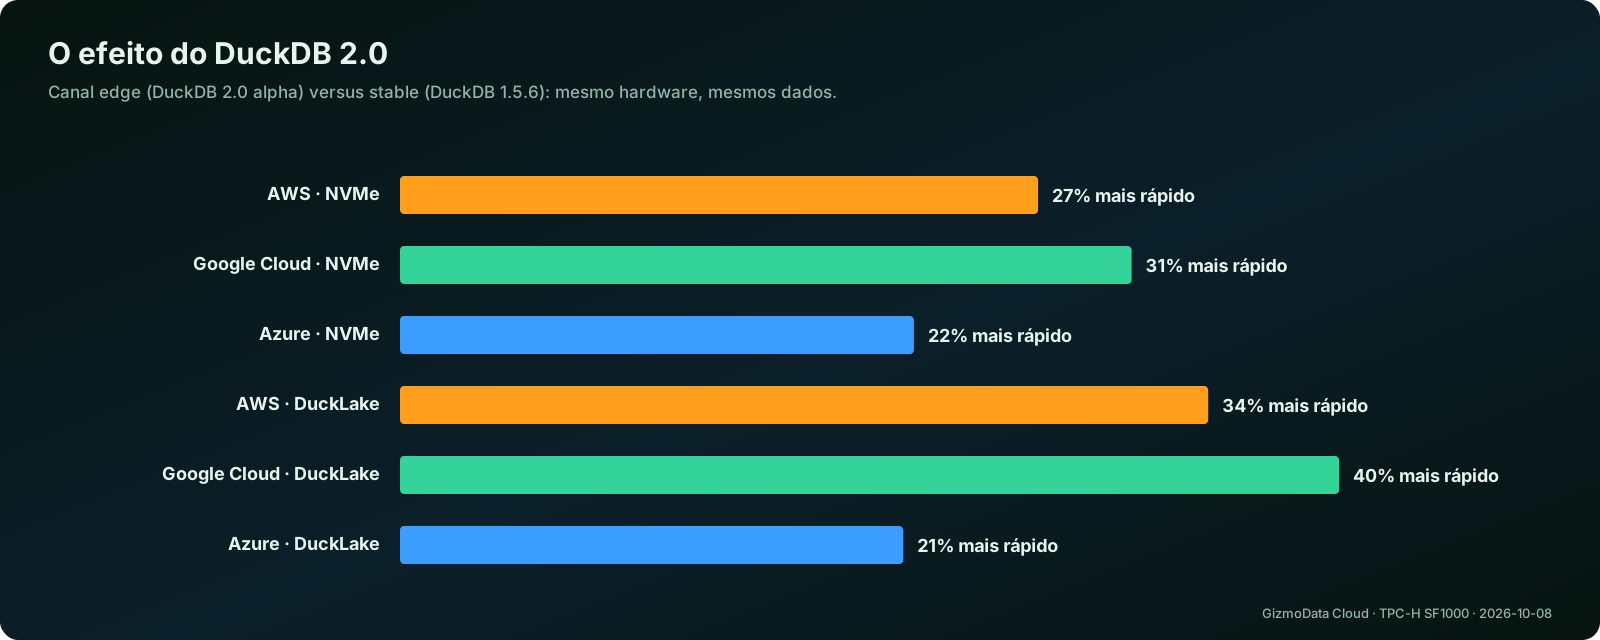
E o próprio mecanismo vence em todas as categorias: o canal edge, com a versão alpha do DuckDB 2.0, superou o canal stable nas seis combinações de nuvem e armazenamento.
O que aprendemos
O DuckDB 2.0 é um grande avanço, sobretudo no armazenamento de objetos
O canal edge reduziu o tempo total das consultas em 22% a 31% no NVMe local e em 21% a 40% no DuckLake, usando o mesmo hardware e os mesmos dados. É um ganho expressivo obtido apenas com a atualização do mecanismo; no GizmoData Cloud, basta alterar um campo na chamada de criação.
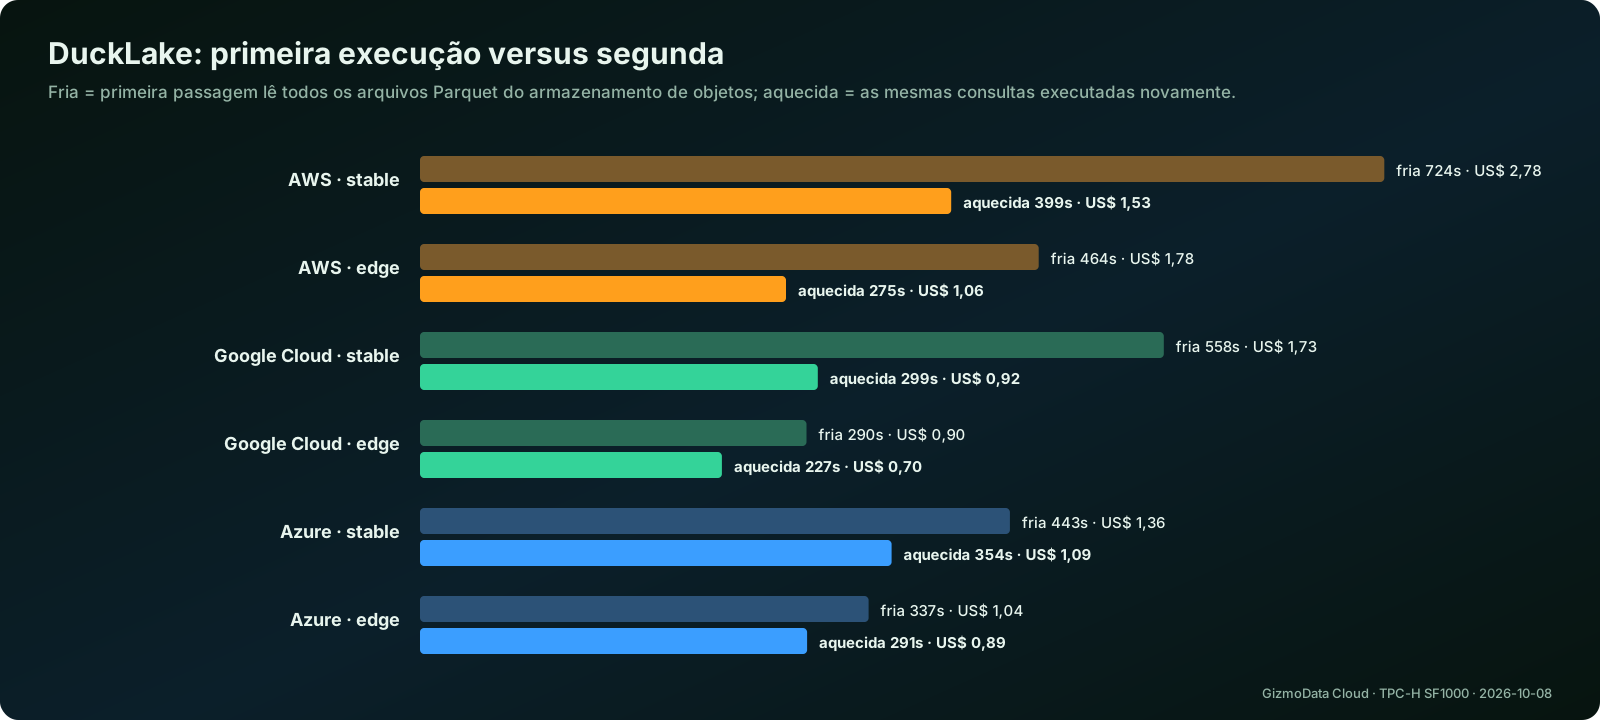
O mérito é da equipe do DuckDB: não alteramos nada além da versão do mecanismo. A principal causa provável é a E/S assíncrona que agora é usada pelo DuckDB 2.0. A camada de E/S escala de forma independente do processamento das consultas, permitindo que muito mais leituras do armazenamento de objetos aconteçam simultaneamente. Isso é especialmente relevante no DuckLake, em que cada arquivo Parquet chega pela rede, e condiz com o que observamos na AWS: a execução fria do DuckLake caiu de 724 para 464 segundos. Segundo a equipe do DuckDB, o armazenamento local se beneficia pouco da E/S assíncrona; portanto, o ganho no NVMe provavelmente vem de outras mudanças do 2.0, como o novo formato de armazenamento e a poda mais ampla de grupos de linhas. Não analisamos o perfil de cada consulta, então essa divisão é nossa melhor interpretação, não uma medição.
NVMe local: AWS Graviton5 é o mais rápido, e há empate no menor custo
Em NVMe local, a AWS r9gd.16xlarge executou o benchmark completo de 1 TB em 79 segundos no canal edge. Em custo, AWS e Google Cloud empatam em cerca de US$ 0,30 por execução completa: o menor preço por hora do Google Cloud compensa o tempo maior (97 segundos).
DuckLake no armazenamento de objetos: a classificação se inverte
Ao ler Parquet do armazenamento de objetos, o Google Cloud fez a execução mais rápida da corrida: 258 segundos no canal edge, contra 314 no Azure e 370 na AWS. No canal stable, o Azure ficou pouco à frente do Google Cloud (398 contra 428 segundos), com a AWS em 561. A AWS perdeu a maior parte do tempo na primeira execução, a fria, quando todos os arquivos vêm do S3.
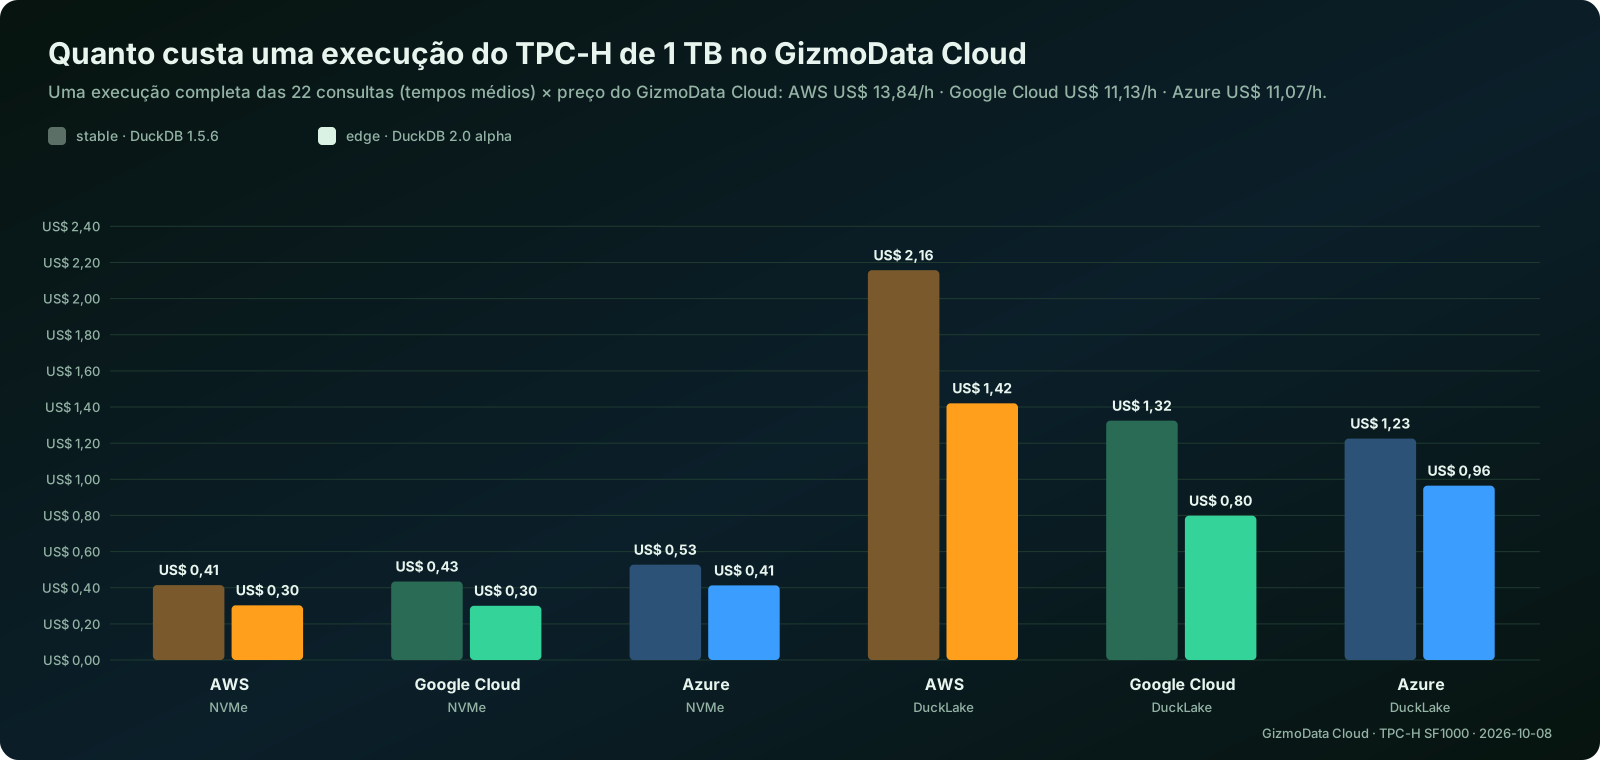
Quanto custa uma execução de 1 TB
Uma execução completa das 22 consultas sobre 1 TB custa entre US$ 0,30 e US$ 2,16 no GizmoData Cloud, dependendo da nuvem, do armazenamento e da versão do mecanismo. A versão mais nova reduz o custo na mesma proporção em que reduz o tempo.
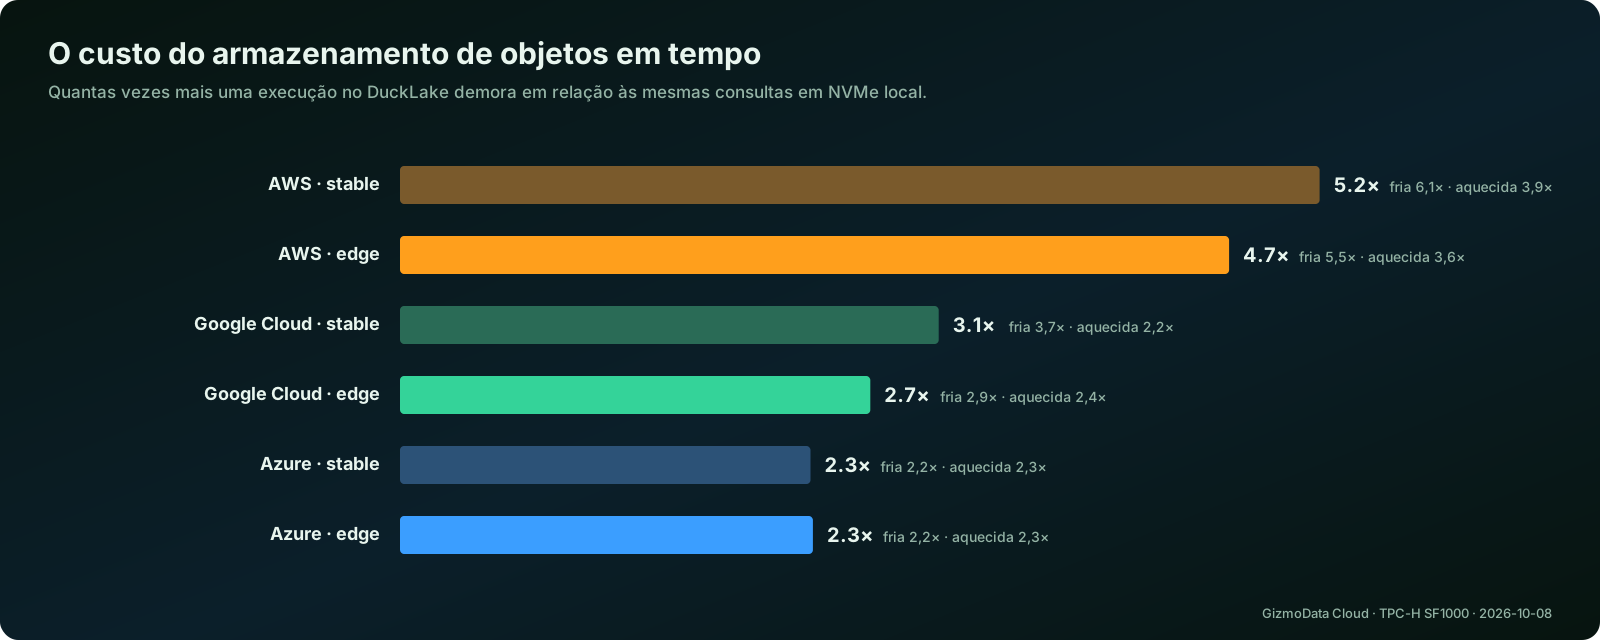
NVMe local ou DuckLake?
O NVMe local foi mais rápido em todas as nuvens. No Azure, uma execução no DuckLake levou 2,3 vezes o tempo de uma execução em NVMe; no Google Cloud, de 2,7 a 3,1 vezes; e na AWS, de 4,7 a 5,2 vezes. A maior parte da diferença na AWS está na primeira execução, a fria, quando todos os arquivos Parquet vêm do S3. A diferença do Azure é a menor, em parte porque sua execução em NVMe foi a mais lenta das três; no DuckLake, a execução edge do Azure (314 segundos) superou a da AWS (370).
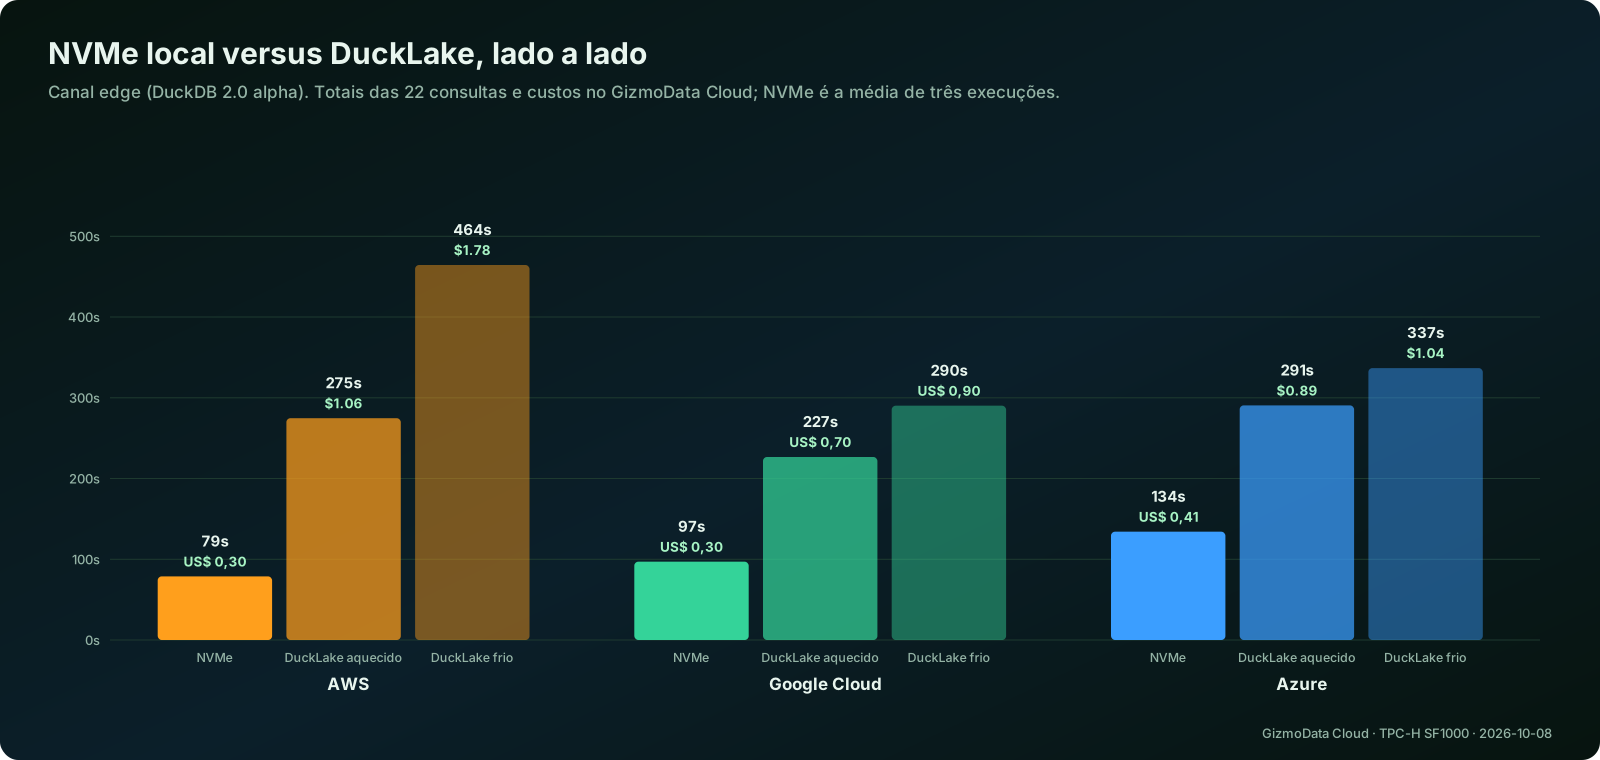
Então por que usar DuckLake? A velocidade do NVMe tem condições: os dados precisam ser carregados em cada cluster na inicialização e permanecem disponíveis somente enquanto ele existir. Um catálogo DuckLake mantém os dados no seu próprio armazenamento de objetos, de onde qualquer quantidade de clusters GizmoSQL pode lê-los ao mesmo tempo, sem etapa de carga, e onde continuam disponíveis depois que você cria ou exclui os clusters. O GizmoData Cloud oferece as duas opções: monte um catálogo DuckLake para compartilhar dados duráveis e carregue um conjunto de trabalho frequente no NVMe local com um script de inicialização quando precisar de velocidade.
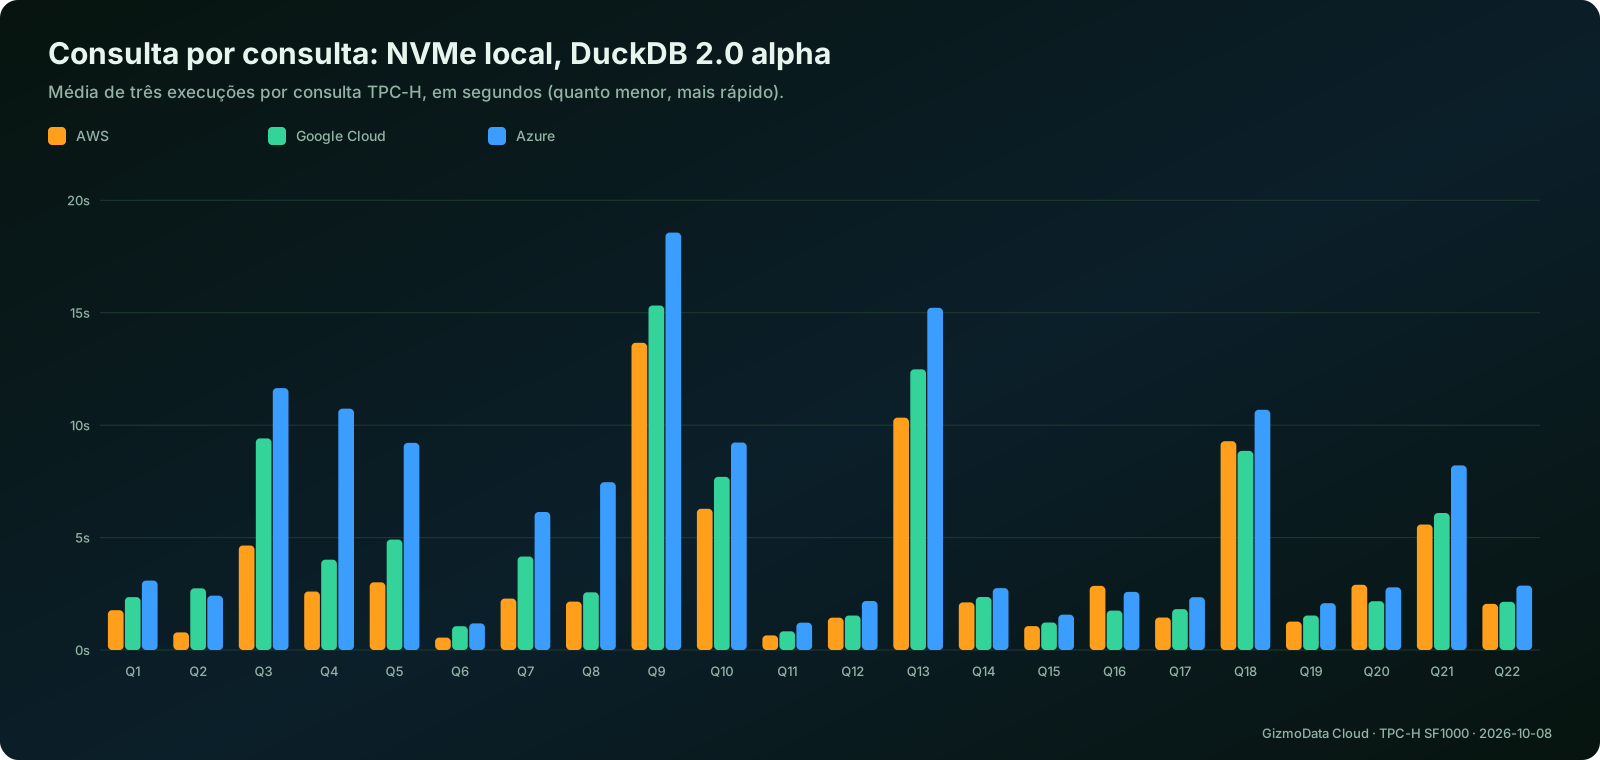
Consulta por consulta
Q9, Q13, Q18 e Q3 representam a maior parcela de todos os tempos totais. Em NVMe local no canal edge, a AWS foi mais rápida em 19 das 22 consultas; o Google Cloud venceu as outras três (Q16, Q18 e Q20). A maior diferença do Azure ocorreu em Q4, Q8, Q2 e Q5, que levaram de três a quatro vezes mais tempo que na AWS.
Como executamos o benchmark
- Hardware: 64 vCPUs por cluster com NVMe local: AWS
r9gd.16xlarge(Graviton5) em US East 2, Google Cloudc4a-highmem-64-lssd(Axion) em US East 4, AzureStandard_E64pds_v6(Cobalt 100) em East US 2. - Mecanismo: GizmoSQL v1.41.0 nos canais stable (DuckDB 1.5.6) e edge (DuckDB 2.0 alpha), com a mesma configuração de threads do DuckDB em todos os clusters.
- Dados: TPC-H com fator de escala 1.000. NVMe local: banco DuckDB no disco NVMe do cluster, carregado na inicialização. DuckLake: arquivos Parquet no armazenamento de objetos da mesma região (S3, Google Cloud Storage ou Azure Blob Storage), com catálogo Postgres.
- Execuções: cada uma das 22 consultas foi executada três vezes no NVMe e duas vezes no DuckLake. Informamos a soma das médias por consulta e, no DuckLake, separamos a primeira execução (fria) da segunda (aquecida).
- Cliente: nosso projeto de código aberto benchmark-flight-sql via Arrow Flight SQL com TLS, a partir de uma máquina. Como as respostas do TPC-H são pequenas, o tempo de rede representa uma parcela insignificante de cada consulta.
- Correção: todas as 792 execuções de consultas retornaram as mesmas contagens de linhas nas 12 combinações.
- Custo: tempo de execução multiplicado pelo preço por hora do cluster no GizmoData Cloud, edição Enterprise (AWS US$ 13,84; Google Cloud US$ 11,13; Azure US$ 11,07 por hora). A edição Core custa menos.
Uma observação sobre o Azure: nesta execução, os pods solicitaram 62 CPUs ao Kubernetes em vez de 63 para contornar um tamanho de solicitação que não cabia no nó; isso já foi corrigido. O mecanismo usou a mesma quantidade de threads das outras nuvens. E vale a ressalva honesta do artigo anterior: cada combinação corresponde a uma única sessão de benchmark, em uma tarde (8 de outubro de 2026), portanto, alguns por cento de qualquer diferença são ruído.
A corrida ainda não acabou
Nosso cavalo do Azure é o Cobalt 100, o chip Arm de primeira geração da Microsoft; ele conquistou um ouro e superou a AWS no DuckLake. Cobalt 200 vem em seguida: a Microsoft afirma que ele oferece desempenho mais de 50% superior ao Cobalt 100 e, quando chegar às configurações do Azure com NVMe local, provavelmente mudará esta corrida novamente. Vamos testá-lo na mesma semana em que estiver disponível. O DuckDB 2.0 ainda está em versão alpha, e também há tamanhos maiores de Graviton5 e Axion por vir.
E isso nos leva ao verdadeiro resultado. O verdadeiro vencedor desta corrida é nosso cliente. Amazon, Microsoft e Google investem bilhões para fazer seus chips superarem os dos concorrentes, e o DuckDB fica mais rápido a cada versão. No GizmoData Cloud, você recebe tudo isso: um novo chip aparece como um novo tamanho, e uma nova versão do DuckDB chega como um novo canal de lançamento. Para atualizar, basta mudar uma string na chamada de criação, sem migrar de plataforma. Quando a classificação dos cavalos muda, você acompanha. Hoje, na AWS, somente essa atualização reduziu em 27% o tempo de execução e o custo.
Faça sua própria corrida
Experimente o GizmoData Cloud gratuitamente
Comece gratuitamente com US$ 25 em crédito de lançamento, aplicado automaticamente. Não é necessário cadastrar cartão de crédito. Todos os clusters podem montar o mesmo conjunto público de dados TPC-H de 1 TB usado na corrida, na própria região. Seu primeiro benchmark fica a uma consulta de distância.
Execute você mesmo
Todas as regiões do GizmoData Cloud têm um catálogo TPC-H público e somente leitura, com um esquema por fator de escala (sf1, sf10, sf100 e sf1000). Assim, você pode repetir a parte da corrida que usa DuckLake sem carregar nada. Você precisa de uma conta do GizmoData Cloud, de uma chave de API no menu do avatar, em Profile & API keys (perfil e chaves de API), e de curl, jq e openssl instalados na sua máquina. A forma mais fácil de obter o ID do ambiente do projeto é usar o botão Copy as curl ao final do assistente de criação de clusters do portal. Um cluster de 64 vCPUs exige um plano com cota suficiente (o Business executa até 128 vCPUs simultaneamente); durante a avaliação com crédito, escolha um tamanho menor, como r9gd.2xlarge, e um esquema menor.
Mostrar a chamada de API que cria um competidor (curl)
export GIZMODATA_API_KEY=...                  # Profile & API keys in the portal
export GIZMODATA_PROJECT_ENVIRONMENT_ID=...   # from the create wizard's "Copy as curl"

# Letters and digits only: a password containing ':' can't be sent in Basic auth.
GIZMOSQL_PASSWORD=$(openssl rand -hex 16)

CLUSTER_ID=$(curl -sS --fail-with-body -X POST "https://app.gizmodata.com/api/database-clusters/?wait=false" \
  -H "Authorization: Bearer $GIZMODATA_API_KEY" \
  -H "Content-Type: application/json" \
  --data @- <<EOF | jq -r .id
{
  "name": "tpch-racer",
  "label": "TPC-H racer",
  "project_environment_id": "$GIZMODATA_PROJECT_ENVIRONMENT_ID",
  "cloud_region": {"label": "aws-us-east-2"},
  "compute_instance_size": {"name": "r9gd.16xlarge"},
  "enable_local_nvme_ssd": true,
  "database_engine": {"name": "duckdb"},
  "database_image": {"name": "gizmosql-edge-v1.41.0-slim"},
  "license_edition": "enterprise",
  "admin_username": "racer",
  "admin_password": "$GIZMOSQL_PASSWORD",
  "allow_any_ip": true,
  "auto_terminate_after_minutes": 120
}
EOF
)

# Wait until the engine answers through its endpoint, then print the connection URI.
until curl -sS "https://app.gizmodata.com/api/database-clusters/$CLUSTER_ID" \
        -H "Authorization: Bearer $GIZMODATA_API_KEY" | jq -e .ready_to_connect > /dev/null; do
  sleep 15
done
curl -sS "https://app.gizmodata.com/api/database-clusters/$CLUSTER_ID" \
  -H "Authorization: Bearer $GIZMODATA_API_KEY" | jq -r '"grpc+tls://\(.ingress_host):443"'

# When you're done:
# curl -sS -X DELETE "https://app.gizmodata.com/api/database-clusters/$CLUSTER_ID" \
#   -H "Authorization: Bearer $GIZMODATA_API_KEY"
Para os outros competidores, use gcp-us-east4 com c4a-highmem-64-lssd, ou azure-eastus2 com Standard_E64pds_v6; para o canal stable, use gizmosql-v1.41.0-slim. auto_terminate_after_minutes é uma proteção que exclui o cluster após duas horas, mesmo se você esquecer. Depois, configure o executor do benchmark para usar o cluster e o catálogo público:
git clone https://github.com/gizmodata/benchmark-flight-sql
cd benchmark-flight-sql
pip install .

benchmark-flight-sql \
  --hostname <the host printed above> \
  --port 443 \
  --username racer \
  --password "$GIZMOSQL_PASSWORD" \
  --database gizmodata_tpch_aws_us_east_2 \
  --schema sf1000 \
  --num-query-runs 2
A ideia principal
Escolher uma nuvem para análise de dados não deveria exigir um mês de trabalho com infraestrutura, nem ser uma decisão da qual você não possa voltar atrás. No GizmoData Cloud, o mesmo GizmoSQL é executado na AWS, no Google Cloud e no Azure por meio de uma única API. Assim, você mede qual opção é mais rápida ou barata para seus dados e muda quando a resposta mudar. E ela vai mudar: o Cobalt 200 e o DuckDB 2.0 estão a caminho.
Se sua equipe paga um data warehouse por crédito, DBU ou byte lido para executar consultas como essas, aqui estão 64 vCPUs e 1 TB por 30 centavos. Comece gratuitamente no GizmoData Cloud, ou fale conosco sobre a migração de uma carga de trabalho.