Artigo de convidado: este artigo foi escrito por Chris Harrison e é publicado aqui com a autorização do autor. O benchmark executável que reproduz todos os números deste artigo está no GitHub.
No início da minha carreira, ficar de plantão era o pior. A conexão era lenta: um modem, uma linha telefônica e muito café. Eu acessava remotamente para consertar o que estivesse quebrado, e a conexão em si já era metade do trabalho: discar, esperar a negociação, esperar de novo até algo útil aparecer no monitor.
Então veio a banda larga, e a mudança foi além da velocidade. Tarefas que antes justificavam sair da mesa ficaram tão rápidas que você deixou de perceber que estavam acontecendo. Isso mudou minha forma de trabalhar.
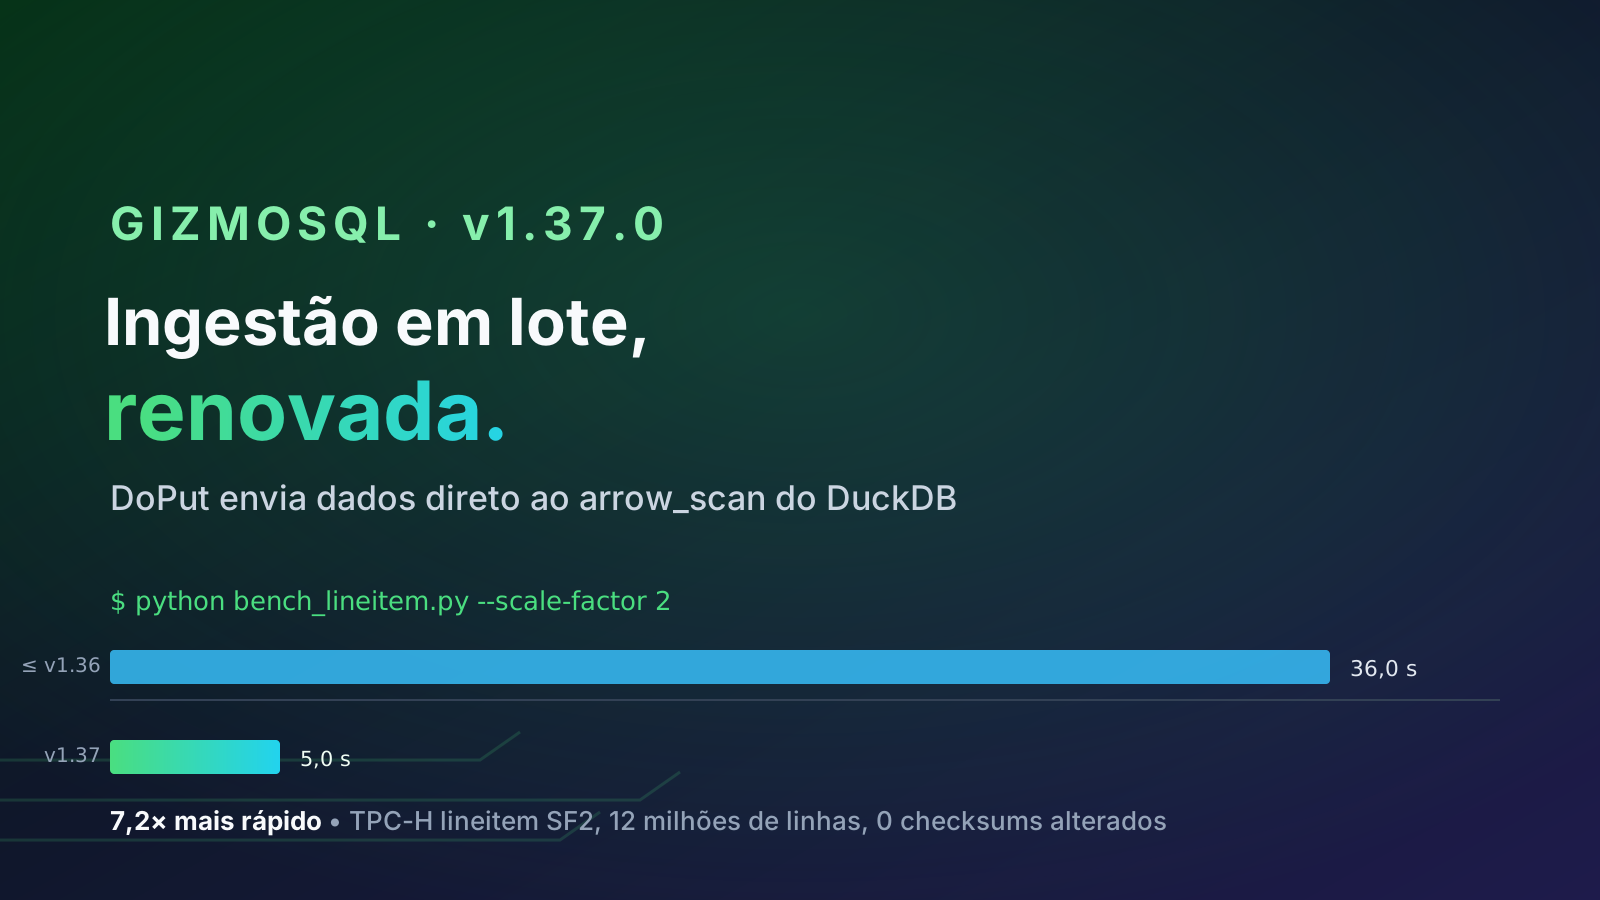
Ao medir o novo caminho de ingestão em massa do GizmoSQL, essa lembrança voltou várias vezes. Veja o que a v1.37.0 faz ao carregar a lineitem do TPC-H com fator de escala 2: de 36 segundos para 5. Tempo suficiente para desviar o olhar, verificar outra coisa e voltar — contra simplesmente… pronto. Não é só um número maior no gráfico de benchmark. É a diferença entre esperar pelo banco e não esperar.
Resumo da versão
| Versão | 1.37.0 |
| Lançamento | 2026-08-24 |
| Commit | b264f7c |
| Autor | Philip Moore |
| Alterações | 8 arquivos, +418 / −424 |
36,0 s → 5,0 s para carregar alineitemdo TPC-H SF2 (11.997.996 linhas, 16 colunas, lotes de 50.000 linhas, Python ADBC sobre gRPC sem criptografia em localhost, banco novo,mode="create"). Mesma contagem de linhas e mesmo checksum desum(l_quantity)nas duas execuções. Tempo decorrido 7,2× menor; de 0,33 para 2,39 milhões de linhas/s.
O que o DoPut fazia antes
Toda chamada ADBC adbc_ingest() e toda carga em massa Flight SQL chegam ao mesmo ponto no servidor: DoPut(CommandStatementIngest). Até a v1.36, esse manipulador fazia tudo pelo caminho difícil. Para cada RecordBatch Arrow recebido, percorria cada linha e coluna, passava o tipo Arrow da célula por um switch de dezessete casos, construía manualmente um duckdb::Value e o enviava a um duckdb::Appender. Cada célula passava por sua própria pequena negociação: identificar o tipo e transferir o valor, um de cada vez.
Esse switch precisava reimplementar conversões que o próprio DuckDB já tinha: cálculos de época para DATE32/DATE64, ajustes conforme a unidade para TIME32/TIME64/TIMESTAMP e processamento recursivo de LIST, STRUCT e MAP. Os decimais não se saíam bem:
// -------- DECIMAL128 -> DuckDB DECIMAL --------
case arrow::Type::DECIMAL128: {
  auto typed = std::static_pointer_cast<arrow::Decimal128Array>(arr);
  std::string s = typed->FormatValue(row);
  // Parse to double – yes, this loses exactness but is simple + robust
  double d = std::stod(s);
  return duckdb::Value::DOUBLE(d);
}
Uma coluna financeira DECIMAL(18,2) entrava exata e saía como um double arredondado. O modo append também tinha sua adaptação: como o Appender ignora o planejador de consultas, não havia como usar o preenchimento de padrões de BY NAME nas colunas não enviadas pelo cliente. O servidor criava uma tabela temporária <table>_interim_bulk_ingest_temp_<session>, inseria nela e depois executava INSERT INTO target BY NAME SELECT * FROM interim e a excluía. Eram uma segunda tabela e uma segunda passagem apenas para acertar os valores padrão, e só em um dos três modos de ingestão.
Esse código não estava exatamente errado: era específico demais. Cada tipo Arrow que o leitor Arrow do próprio DuckDB já entendia precisava ser ensinado novamente a esse caminho e mantido em sincronia manualmente conforme Arrow e DuckDB evoluíam.
O que a v1.37.0 faz: para de converter célula a célula e passa a usar o scanner
Se o caminho antigo era uma conexão discada — negociar e transferir cada célula lentamente — este é a banda larga: negociar uma vez, registrar o fluxo inteiro e deixar a outra ponta consumir na velocidade que puder. O DuckDB já tem um importador Arrow vetorizado e amplamente usado: arrow_scan, a função de tabela por trás de cada chamada duckdb.from_arrow() e leitura de arquivo Arrow. A solução da v1.37.0 é parar de competir com ele e começar a usá-lo. O fluxo Flight recebido é encapsulado uma vez em um arrow::RecordBatchReader real, exportado pela interface Arrow C stream e registrado como uma view temporária da sessão. Carregar um lote vira uma instrução, em todos os modos:
ArrowIngestStream ingest_stream(reader, arrow_schema);
const std::string ingest_view =
    "__gizmosql_ingest_" + strip_dashes(client_session->session_id);
ARROW_RETURN_NOT_OK(ingest_stream.RegisterView(conn, ingest_view));

const std::string insert_sql =
    "INSERT INTO " + target_table +
    " BY NAME SELECT * FROM " + QuoteIdent(ingest_view);
ARROW_ASSIGN_OR_RAISE(auto insert_res,
                       RunAndLogQueryWithResult(client_session, insert_sql));
total_rows = insert_res->GetValue(0, 0).GetValue<int64_t>();

if (total_rows != ingest_stream.total_rows())
  return Status::Invalid("row count mismatch: inserted vs. streamed");
BY NAME agora preenche os valores padrão das colunas em todos os modos, não apenas append. A tabela intermediária desapareceu, junto com a segunda passagem que exigia. Tipos aninhados, decimais, timestamps com fuso e codificações por dicionário passam pelo mesmo caminho vetorizado que o DuckDB usa em todo o sistema, sem uma implementação paralela que precisasse acompanhá-lo. E como a contagem de linhas retornada pelo INSERT é conferida com o que FlightIngestBatchReader contou na rede, uma carga parcial silenciosa é detectada imediatamente.
A view é registrada sobre um objeto de fluxo que vive na pilha de chamadas e não pode sobreviver à solicitação. Uma pequena proteção RAII a remove em qualquer saída, seja por sucesso ou exceção:
struct ViewDropper {
  duckdb::Connection& conn;
  std::string name;
  ~ViewDropper() {
    try { conn.Query("DROP VIEW IF EXISTS " + QuoteIdent(name)); }
    catch (...) {}
  }
} view_dropper{conn, ingest_view};
Mesma origem, mesmo destino — quatro etapas em vez de seis
BEFORE · ≤v1.36.1                          AFTER · v1.37.0
────────────────────────────           ────────────────────────────
Flight DoPut stream (batches)          Flight DoPut stream (batches)
        │ reader->Next(), per batch            │ wrapped once as RecordBatchReader
        ▼                                       ▼
chunk loop, one batch at a time        ArrowIngestStream
        │ per row × per column                  │ (FlightIngestBatchReader)
        ▼                                        │ conn.TableFunction("arrow_scan")
ConvertArrowCellToDuckDBValue()                  ▼
  17-case type switch, hand-rolled       session-temp VIEW
  decimal / date / time math             __gizmosql_ingest_<session>
        │ Appender.Append(), per cell            │ one query, every mode
        ▼                                        ▼
duckdb::Appender                        INSERT INTO target BY NAME
  ├─ create/replace: straight in          SELECT * FROM view
  └─ append: scratch *_interim_temp               │ verify: rows inserted ==
       │ 2nd INSERT ... BY NAME, DROP             │ rows streamed by client
        ▼                                        ▼
target table                            target table
Colunas geoarrow.* são materializadas como GEOMETRY no mesmo ponto em que os demais tipos são convertidos. Mais detalhes abaixo.
Colunas de geometria finalmente chegam como GEOMETRY
O GeoPandas — e qualquer ferramenta que use GeoArrow — marca o campo Arrow de uma coluna geométrica com uma chave de metadados ARROW:extension:name, como geoarrow.wkb. É exatamente o que as próprias colunas GEOMETRY do GizmoSQL emitem na saída. Na entrada, até a v1.36, nada examinava esses metadados: GetDuckDBTypeFromArrowType() via apenas um array Arrow binary. Assim, uma tabela nova recebia uma coluna BLOB, e acrescentar geometria a uma coluna GEOMETRY existente falhava na conversão de blob para geometry, que não podia ser realizada.
A correção é uma verificação de metadados de quatro linhas, aplicada na criação da tabela e respeitada automaticamente quando a ingestão passa por arrow_scan, que já sabe materializar tipos de extensão GeoArrow como GEOMETRY quando a extensão espacial está carregada:
bool IsGeoArrowField(const arrow::Field& field) {
  const auto& metadata = field.metadata();
  if (!metadata) return false;
  const int idx = metadata->FindKey("ARROW:extension:name");
  return idx >= 0 && metadata->value(idx).rfind("geoarrow.", 0) == 0;
}
Como a verificação fica no servidor, corrige o comportamento de todos os clientes — JDBC, Go, C++, Python ADBC e a CLI dbc — e não apenas a adaptação pontual no cliente lançada em adbc-driver-gizmosql 2.0.1, que esta versão torna redundante. Um novo teste de regressão (tests/integration/test_geoarrow.cpp) ingere pontos WKB em uma tabela nova (create), acrescenta outros à mesma coluna GEOMETRY (append) e substitui a tabela inteira (replace), verificando typeof(geom) = 'GEOMETRY' e fazendo cada lote passar por ST_AsText para confirmar que as coordenadas foram preservadas.
O gargalo mudou: o limite de mensagens do gRPC
Como a conversão no servidor deixou de ser a parte lenta, a decodificação de Parquet no cliente e a transferência gRPC passam a dominar. Isso evidencia um limite que sempre existiu, mas raramente era atingido: cada lote Arrow viaja como uma mensagem Flight, e o limite padrão do gRPC é de 16 MB. Até uma conexão de banda larga tem um tamanho máximo de quadro — este é o do GizmoSQL. Um lote de 1.000.000 de linhas da lineitem do TPC-H ocupa cerca de 170 MB e é rejeitado: trying to send message larger than max.
1with conn.cursor() as cur:
2    cur.adbc_ingest(
3        table_name="lineitem",
4        data=record_batch_reader,   # 50,000-row batches: comfortably
5                                     # under the 16 MB gRPC message cap
6        mode="create",
7    )
docs/bulk_ingestion.md agora explica isso diretamente: 50.000 a 100.000 linhas por lote é um padrão seguro para tabelas típicas. Aumente se suas linhas forem especialmente estreitas; reduza se forem especialmente largas.
Em números: o que mudou no diff
O saldo de linhas quase não muda: seis linhas a menos no total. O que mudou foi onde a complexidade fica: duckdb_server.cpp perdeu todo o switch manual de conversão e a lógica da tabela intermediária, substituídos por uma chamada a dois arquivos pequenos, cada um com uma única finalidade.
| Arquivo | + | − | O que mudou |
|---|---|---|---|
| duckdb_server.cpp | +42 | −423 | remoção do switch de conversão de tipos e do caminho da tabela intermediária |
| duckdb_arrow_ingest.cpp | +125 | −0 | novo: a ponte com arrow_scan |
| duckdb_arrow_ingest.h | +93 | −0 | novo: sua interface pública |
| test_geoarrow.cpp | +91 | −0 | testes de regressão para create / append / replace |
| docs/bulk_ingestion.md | +27 | −0 | orientação de tamanho no gRPC e funcionamento da nova carga |
| CHANGELOG.md | +30 | −0 | — |
| docs/geometry.md | +8 | −0 | nota sobre GEOMETRY na ingestão |
| CMakeLists.txt | +2 | −1 | inclusão do novo arquivo-fonte |
| Total · 8 arquivos | +418 | −424 | saldo de −6 linhas |
O código não encolheu porque alguém encontrou um canal maior. Ele encolheu porque o servidor parou de construir seu próprio modem.
Comprove você mesmo
Números em uma página ainda são só uma história com um gráfico. Por isso, este artigo acompanha um pequeno projeto real, bulk-ingest-demo, que executa o driver apresentado aqui contra dois servidores GizmoSQL ativos ao mesmo tempo: v1.36.1, a última versão antes da reescrita, e a atual, cada um em sua própria porta.
# 1. start both servers, side by side
docker run --name gizmosql-v1361 --detach --rm --publish 31338:31337 \
    --env TLS_ENABLED=1 --env GIZMOSQL_PASSWORD=gizmosql_password \
    gizmodata/gizmosql:v1.36.1                    # before, port 31338

docker run --name gizmosql --detach --rm --publish 31337:31337 \
    --env TLS_ENABLED=1 --env GIZMOSQL_PASSWORD=gizmosql_password \
    gizmodata/gizmosql:latest                     # after,  port 31337

# 2. install the driver this article is actually about
pip install -r requirements.txt

# 3. the article's actual benchmark shape, against both
python bench_lineitem.py --scale-factor 1 --port 31338   # before
python bench_lineitem.py --scale-factor 1 --port 31337   # after

# 4. see the gRPC cap for yourself: force one giant batch
python bench_ingest.py --rows 2000000 --batch-size 0 --port 31337
#    -> trying to send message larger than max (16 MB gRPC cap)
Executado agora, nesta máquina, com a lineitem do TPC-H de fator de escala 1 (6.001.215 linhas): v1.36.1 carregou os dados em 9,0 s; o servidor atual, em 1,1 s — 8,2× mais rápido, com checksum de sum(l_quantity) idêntico nos dois. Não é um número copiado de um slide: veio de uma execução real, que é justamente o objetivo.
Uma ressalva descoberta na execução: teste uma tabela mais estreita do mesmo modo, nas duas portas, e a diferença quase desaparece. Com 5.000.000 de linhas, os dois servidores ficam dentro da margem de variação. O custo do caminho antigo cresce com o número de colunas e as conversões decimais, elineitemtem muitos dos dois. O resultado principal vale para o perfil delineitem, não para qualquer tabela.
Notas da versão v1.37.0 — 24/08/2026
- Alterado: a ingestão em massa (Flight SQL
DoPut/ ADBCadbc_ingest) agora é transmitida pelo scanner Arrow do DuckDB: um únicoINSERT INTO target BY NAME SELECT * FROM viewsobre umarrow_scanregistrado substitui a conversãoduckdb::Valuepor célula e a tabela intermediária do modo append. - Corrigido: colunas de geometria agora são ingeridas em massa como
GEOMETRY, em vez deBLOB, no servidor (adbc-driver-gizmosql#5), para todos os clientes, nos modos create, append e replace.
Trinta anos depois, a mesma lição: uma conexão que deixa de atrapalhar muda sua forma de trabalhar.
O projeto de benchmark deste artigo — bench_lineitem.py, bench_ingest.py e instruções para executar as duas versões do GizmoSQL lado a lado — está no GitHub.
GizmoSQL: github.com/gizmodata/gizmosql · commit b264f7c