Sobre o autor: Chris Wones é consultor estratégico da GizmoData. Ao longo de 34 anos, liderou iniciativas de dados corporativos e engenharia na James River, Retek, dunnhumby e Kroger/84.51°, e traz ao GizmoSQL e ao GizmoData Cloud a perspectiva de quem compra plataformas de dados.
Escalar computação sem estado é fácil. Escalar nós de computação independentes que precisam compartilhar o mesmo estado mutável dos dados é mais interessante — e é a realidade da análise de dados moderna.
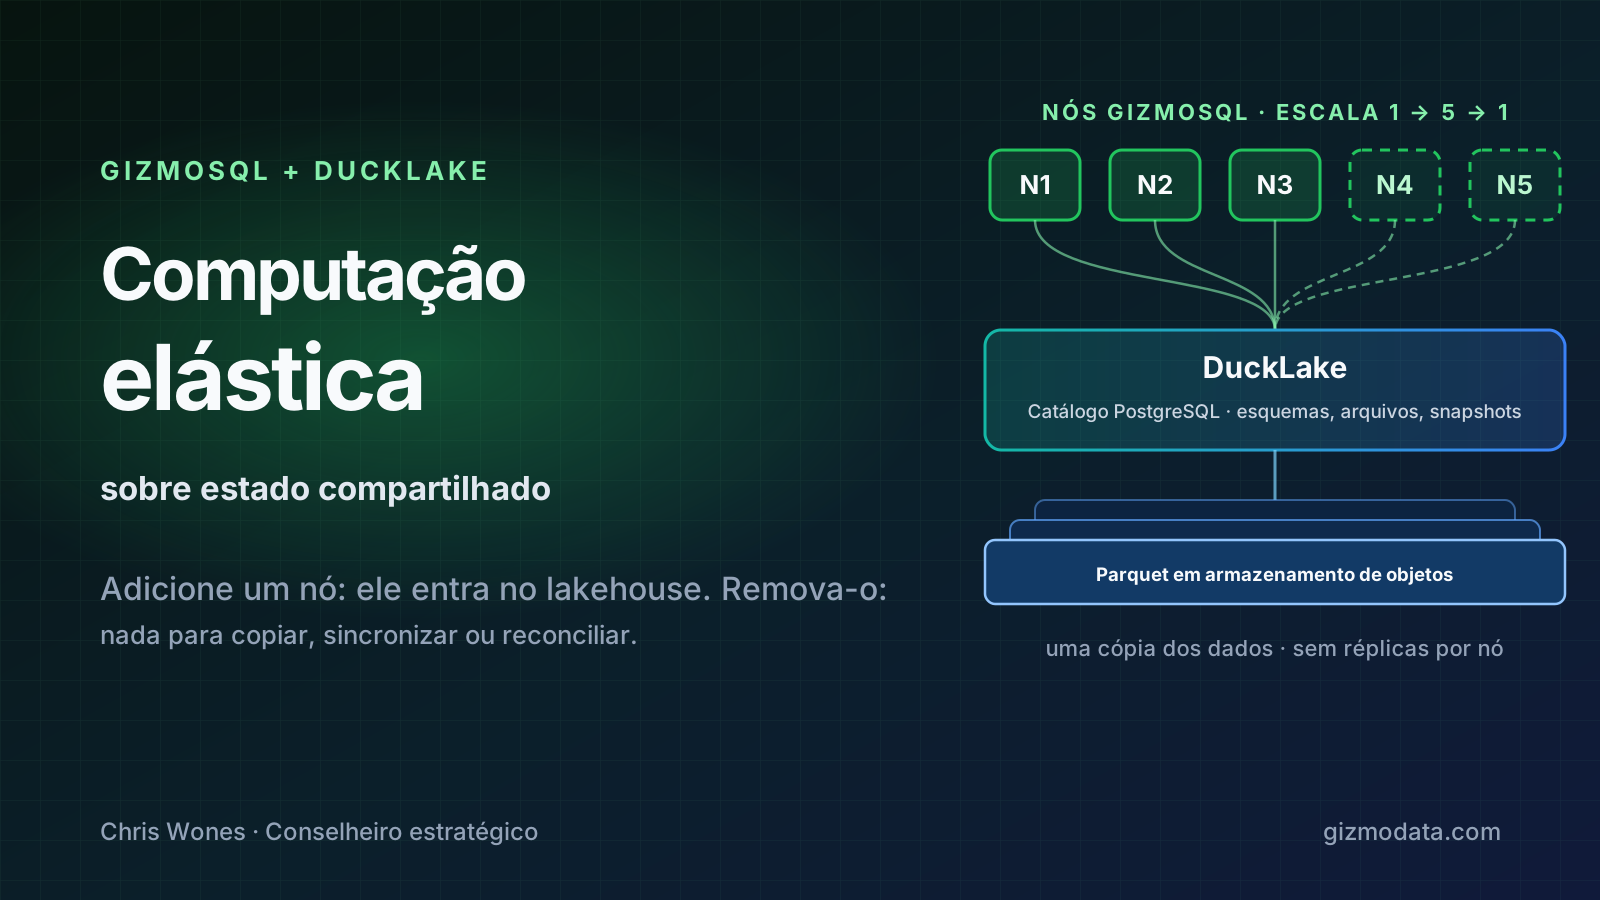
A GizmoData executa cargas de trabalho SQL analíticas em nós GizmoSQL independentes. Um cluster pode operar com um nó quando há pouca concorrência, crescer para cinco com o aumento da demanda e voltar a diminuir quando a capacidade adicional não for mais necessária.
Esse é um dos cenários em que GizmoSQL e DuckLake se destacam juntos.
Catálogo compartilhado, dados compartilhados
O DuckLake mantém os dados das tabelas em arquivos Parquet comuns e armazena os metadados do lakehouse em um catálogo SQL transacional. Esse catálogo acompanha esquemas, tabelas, colunas, arquivos de dados, snapshots, estatísticas e tudo o que é necessário para interpretar os arquivos subjacentes. Para um lakehouse com vários usuários e clientes remotos, a orientação do próprio DuckLake é usar PostgreSQL como banco do catálogo.
Em uma implantação GizmoData, vários nós GizmoSQL se conectam ao mesmo catálogo DuckLake e ao mesmo armazenamento de objetos:
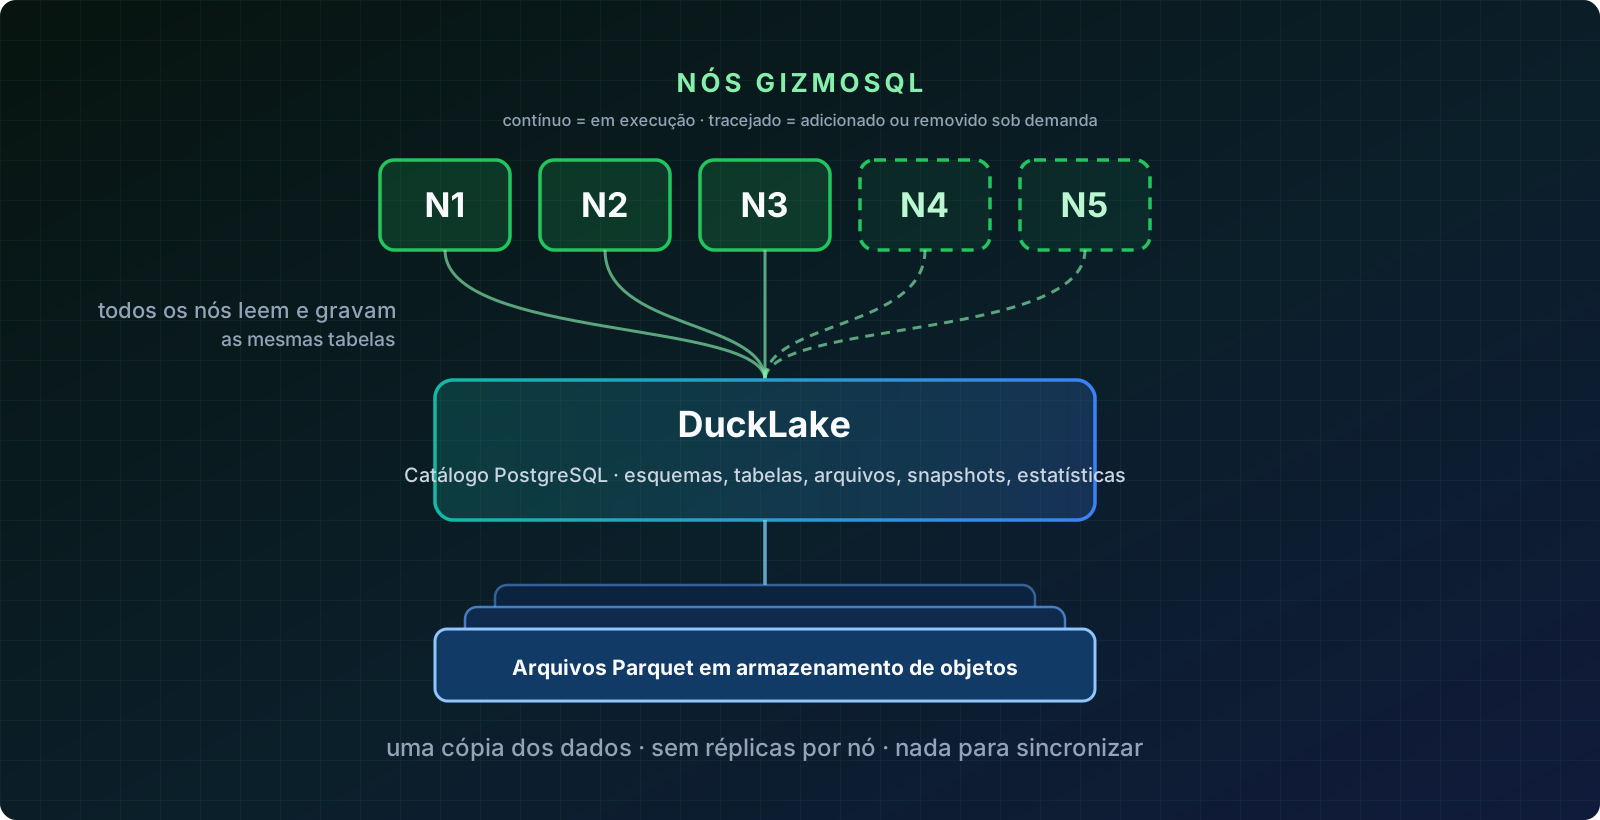
Um novo nó se conecta diretamente ao catálogo e ao armazenamento de objetos existentes. Ele não copia o lakehouse nem reconstrói seus metadados antes de atender consultas. Isso importa quando os nós são efêmeros: a GizmoData pode adicionar computação para absorver um pico e removê-la quando a demanda cair, sem mover ou duplicar os dados subjacentes. O escalonamento continua rápido e simples de operar, evitando o custo de armazenamento, o trabalho de sincronização e o risco de inconsistência de manter cópias separadas dos mesmos dados.
Na prática, cada nó executa o mesmo pequeno conjunto de instruções para acessar o lakehouse. Esta é a configuração do guia de integração do GizmoSQL com DuckLake, idêntica no primeiro ou no quinto nó:
INSTALL ducklake; LOAD ducklake;
INSTALL postgres; LOAD postgres;

-- The shared catalog
CREATE OR REPLACE SECRET postgres_secret (
  TYPE postgres,
  HOST 'localhost',
  PORT 5432,
  DATABASE 'ducklake_catalog',
  USER 'postgres',
  PASSWORD 'your_password'
);

-- The shared data
CREATE OR REPLACE SECRET ducklake_secret (
  TYPE DUCKLAKE,
  METADATA_PATH '',
  DATA_PATH 's3://my-bucket/lakehouse/',
  METADATA_PARAMETERS MAP {
    'TYPE': 'postgres',
    'SECRET': 'postgres_secret'
  }
);

ATTACH 'ducklake:ducklake_secret' AS my_lakehouse;
USE my_lakehouse;
A computação cresce conforme a demanda, enquanto o estado compartilhado dos dados permanece no mesmo lugar.
Os nós também podem gravar
Não se trata apenas de acesso compartilhado de leitura.
Vários nós GizmoSQL podem ler e gravar nas mesmas tabelas mantidas pelo DuckLake. O DuckLake oferece transações ACID com isolamento por snapshot e lida com gravações concorrentes como se espera de um sistema transacional: quando duas transações confirmam alterações que não têm conflito lógico (inserções simultâneas na mesma tabela, por exemplo), a posterior é repetida contra o catálogo sem regravar nenhum arquivo de dados. Quando há um conflito real, como duas transações excluindo linhas do mesmo arquivo de dados, uma delas é abortada e o cliente recebe o motivo. Os detalhes estão na documentação de resolução de conflitos do DuckLake.
Isso dá à GizmoData uma propriedade importante: adicionar um nó significa adicionar outro processo independente de computação que pode participar imediatamente do trabalho no mesmo lakehouse transacional.
Não é preciso criar uma cópia separada dos dados para cada nó, e não há nada para reconciliar depois. Todos os nós leem e gravam o mesmo conjunto de snapshots.
Por que o catálogo importa
O catálogo é mais do que uma lista de esquemas.
Ele contém informações estruturais suficientes para que cada nó opere sobre a mesma representação do lakehouse: quais tabelas existem, quais arquivos pertencem a elas, qual é o esquema atual e qual snapshot está visível no momento. Como esse estado reside em um único banco transacional, em vez da memória ou do disco local de cada nó, o nó não carrega estado que precise ser preservado. Ele pode ser criado ou destruído conforme necessário.
Isso simplifica o escalonamento automático. A GizmoData escala a camada de computação de forma independente, enquanto o DuckLake mantém o estado persistente e compartilhado que a sustenta.
DuckLake fornece o lakehouse transacional compartilhado.
GizmoSQL fornece a computação SQL elástica sobre ele.
Quer uma solução pronta para usar?
Tenha um DuckLake pronto para usar com computação DuckDB e escalonamento automático no GizmoData Cloud
O GizmoData Cloud provisiona o catálogo DuckLake, o armazenamento de objetos e o cluster GizmoSQL para você na AWS, no Google Cloud ou no Azure, e aumenta ou reduz a camada de computação sob demanda (réplicas mínimas/máximas, metas de CPU e memória ou agendamento). O serviço está disponível para o público: cadastre-se gratuitamente em app.gizmodata.com.
Da equipe GizmoData: essa é exatamente a arquitetura do escalonamento horizontal do GizmoSQL: um pool de nós gerenciados pelo Kubernetes, sessões balanceadas por round-robin e um único DuckLake compartilhado com catálogo PostgreSQL. Funciona da mesma forma no Core (Apache-2.0) e no Enterprise. Para experimentar, siga o guia de integração com DuckLake depois de instalar o GizmoSQL Core, ou fale conosco sobre operar um cluster elástico em produção.