Artigo de convidado: este artigo foi escrito por Kasper F. Pedersen, do grupo de pesquisa Daisy da Universidade de Aalborg, na Dinamarca, e é publicado aqui com a autorização do autor. O Seagull é descrito no artigo do IEEE MDM 2026 "Seagull: Data-Driven Maritime Traffic Analysis".
Os dados marítimos têm recebido muita atenção da comunidade de pesquisa nos últimos anos graças à disponibilidade de grandes conjuntos de dados abertos. No grupo de pesquisa Daisy, da Universidade de Aalborg, na Dinamarca, trabalhamos com teoria e prática no domínio marítimo. Na parte prática, criamos a plataforma Seagull para disponibilizar dados AIS por meio de várias camadas:
- Uma camada de histórico de posições das embarcações
- Uma camada de grade quadkey agregada com filtros
- Uma camada de grade de meio grau agregada com filtros
- Uma camada de histórico de trajetórias das embarcações
A plataforma é desenvolvida em colaboração com a Danish Geodata Agency, como parte da iniciativa Digital Research Centre Denmark (DIREC). O Seagull é útil para quem tem interesse no histórico de movimentação na água. Na data de redação deste artigo (setembro de 2026), o Seagull armazena mais de 18,7 bilhões de registros do Sistema de Identificação Automática (AIS), de mais de 126.400 navios.
Desafios
O grupo de pesquisa responsável pelo Seagull usa PostgreSQL há bastante tempo e está satisfeito com ele. Por isso, muitos projetos anteriores o utilizaram para gerenciar dados. O Seagull também começou com PostgreSQL, mas logo percebemos que eram necessárias muitas tabelas pré-agregadas para acompanhar o volume de dados disponível. Manter essas tabelas de agregação aumenta o trabalho nos pipelines de dados.
A solução
Para resolver os problemas de escalabilidade mantendo um pipeline de dados enxuto e simples, o grupo decidiu experimentar o DuckDB. Ficamos impressionados com o desempenho e o pouco espaço em disco que ele exige. Mas havia um grande problema: o DuckDB é um banco OLAP que roda dentro do processo, com múltiplas leituras e uma única gravação; portanto, só um processo pode gravar dados por vez. Nossa plataforma depende de vários componentes, como o Apache Airflow para os pipelines de dados, o MapLibre Martin para servir blocos vetoriais e uma aplicação web para apresentar os dados ao usuário final. Acessar os dados por um único processo não seria suficiente.
GizmoSQL para resolver o problema
Estava claro que precisávamos de algum tipo de camada intermediária para limitar o acesso ao arquivo do banco. Foi exatamente aí que o GizmoSQL entrou. O GizmoSQL nos permitiu usar o DuckDB como se fosse um banco de dados centralizado. Ele oferece acesso ao DuckDB pelo protocolo Arrow Flight SQL. Assim, apenas um processo precisava acessar o arquivo do banco, enquanto várias conexões podiam consultá-lo. A ingestão também continuou rápida graças ao trabalho da equipe GizmoData nos drivers ADBC. Era hora de construir a plataforma Seagull!
A plataforma Seagull
Tudo o que a aplicação web Seagull entrega é processado sob demanda. Não há pré-agregação, mas o Martin armazena em cache os blocos já servidos para reduzir o processamento. Os blocos são gerados com a funcionalidade MVT disponível no DuckDB. Isso elimina a necessidade de pré-calcular arquivos como PMTiles e MBTiles.
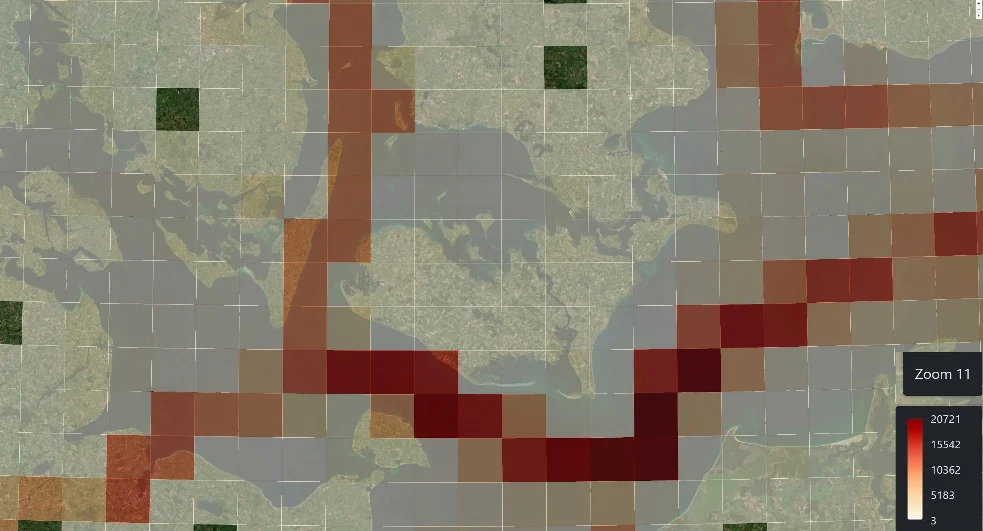
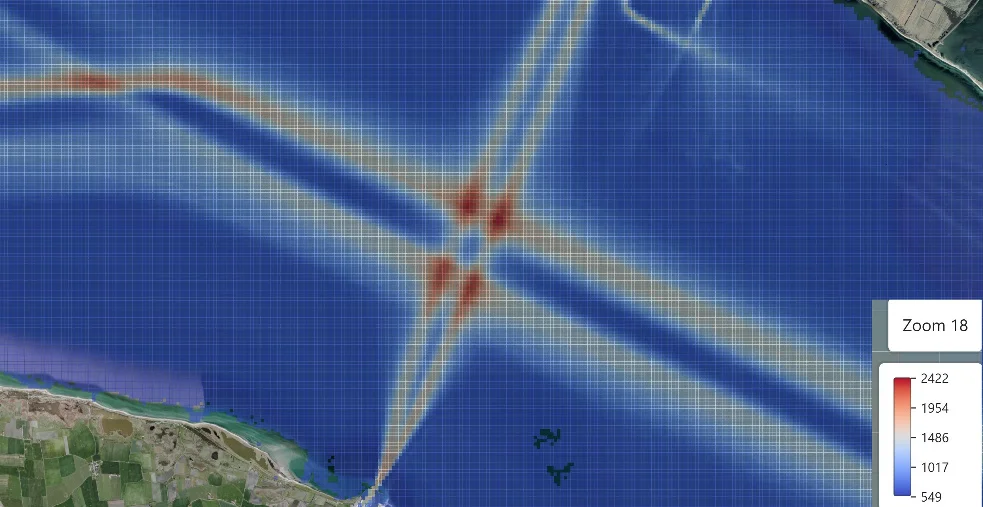
A Figura 1 mostra a grade quad no nível de zoom 11, com uma visão aérea geral da quantidade de embarcações que passam pelas células. Em comparação, a Figura 2 mostra uma visão mais detalhada no nível de zoom 18.
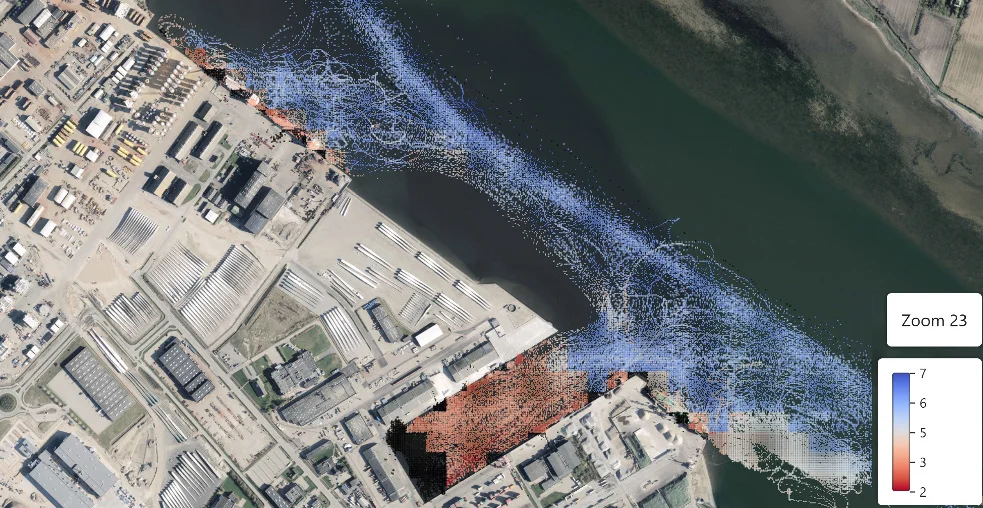
Enquanto a Figura 1 e a Figura 2 mostram a quantidade de embarcações, a Figura 3 destaca a folga abaixo da quilha (metros de água sob a quilha). A Figura 3 usa o nível de zoom mais detalhado, 23 (cerca de 2,1 m² por célula), útil para passagens estreitas ou áreas congestionadas, como portos. Todos os dados podem ser apresentados dos níveis de zoom 1 a 23 e são processados a cada solicitação.
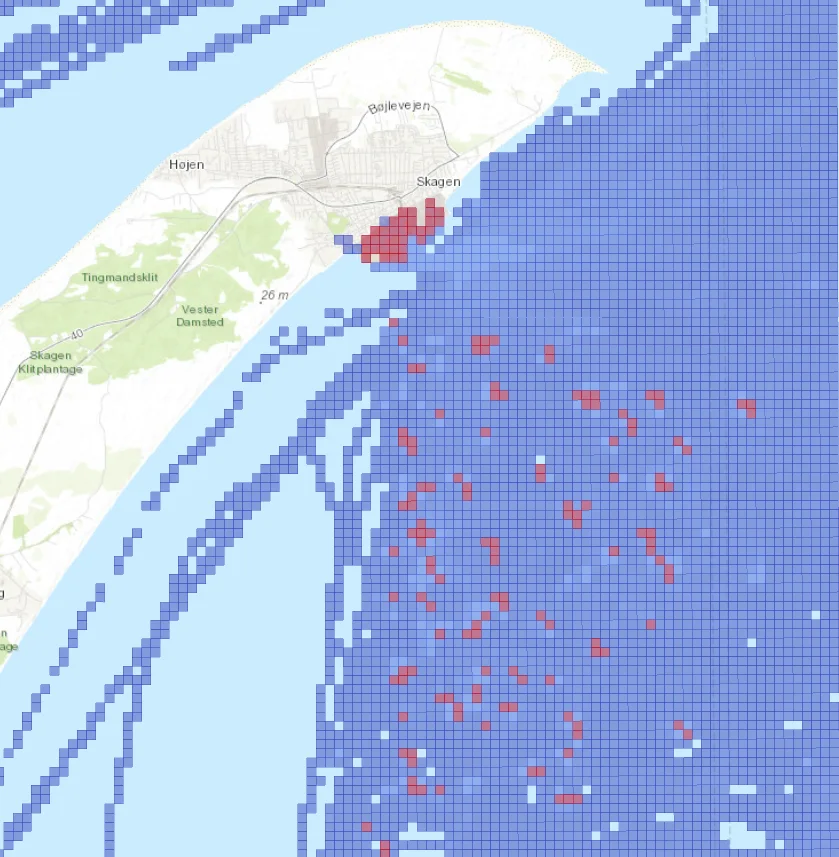
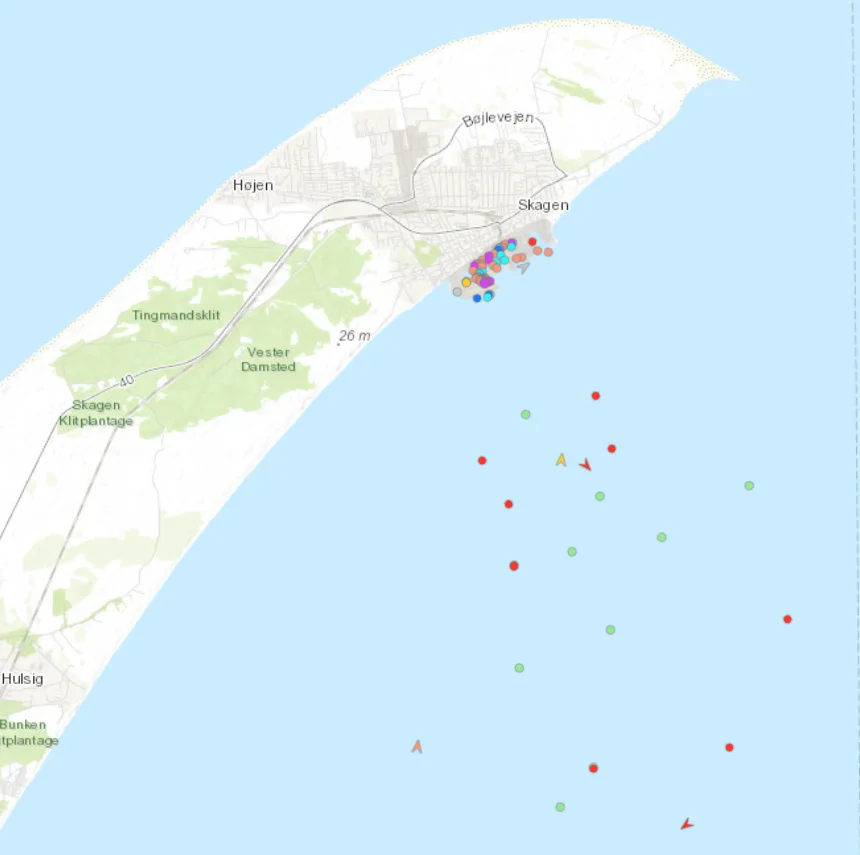
A Figura 4 e a Figura 5 ilustram a mesma área em formatos diferentes. A Figura 4 destaca onde as embarcações ficam paradas. A métrica corresponde aos segundos de embarcação únicos por dia em cada célula, acumulados em um período de 5 dias. A Figura 5 mostra um retrato das posições em 04/09/2026 às 8h36. Círculos representam embarcações paradas e setas representam as que estão em movimento; a inclinação da seta indica o rumo sobre o fundo. As cores correspondem ao tipo de embarcação.
Conclusão
A plataforma Seagull se beneficia da centralização do DuckDB oferecida pelo GizmoSQL. Isso nos permitiu projetar um sistema com um esquema de dados relativamente simples, que exige pouca manutenção e ainda entrega uma plataforma responsiva e de alto desempenho. Para mais detalhes de implementação do Seagull, leia nosso artigo.
Da equipe GizmoData: o Seagull é um ótimo exemplo do modelo para o qual o GizmoSQL foi criado: manter a simplicidade de um único arquivo do DuckDB e colocar um servidor Arrow Flight SQL à sua frente, para que pipelines, servidores de blocos e aplicações compartilhem um banco. Se você está construindo algo semelhante, instale o GizmoSQL Core gratuitamente ou fale conosco sobre usá-lo em produção.