Artigo de convidado: este artigo foi publicado originalmente em inglês no HackerNoon por Shawn Gordon e é republicado aqui, em tradução da GizmoData, com a autorização do autor.
Introdução
Há algum tempo, escrevi Afinal, o que é GizmoSQL?, sobre o projeto de Philip Moore que pegou o DuckDB, uma biblioteca que roda dentro do processo, e o transformou em um servidor de verdade, com sessões simultâneas, autenticação, TLS e um endpoint Arrow Flight SQL. Ele resolvia um problema real. O DuckDB é fantástico, mas vive dentro do seu processo e, quando várias pessoas ou aplicações precisam acessar os mesmos dados, você precisa de algo na frente dele.
Pois bem, o pessoal da GizmoData foi lá e o substituiu. Em 21 de outubro de 2026, eles anunciaram o Hardcharger, um servidor de código aberto totalmente novo para o DuckDB 2.0, escrito do zero em vez de portado do código do GizmoSQL. Ele é licenciado sob Apache 2.0, sem edições nem chaves de licença, uma mudança notável à qual voltarei mais adiante.
Vamos mergulhar
Por que o Hardcharger abandonou o Arrow Flight SQL em favor de um novo protocolo chamado Chargewire? Por que o Phil o criou?
O Arrow Flight SQL roda sobre gRPC, o que significa HTTP/2 de ponta a ponta, proxies e balanceadores de carga que entendam gRPC, código gerado em todos os clientes e nenhum cliente simples para navegador. A GizmoData esbarrou nisso ao operar a própria nuvem: cada recarga de um proxy compartilhado enviava um GOAWAY às conexões gRPC de longa duração, e as chamadas seguintes falhavam. Qualquer pessoa que já tentou colocar gRPC atrás de uma infraestrutura padrão vai reconhecer essa dor.
O Chargewire mantém a parte boa do Flight SQL, que é o Apache Arrow como formato colunar na rede, e joga fora o transporte. Ele executa SQL sobre HTTP/1.1 e TLS comuns. Resultados, parâmetros de consulta e cargas em massa são streams Arrow IPC, enquanto as mensagens de controle são pequenos documentos JSON. As notas dizem que a versão 1.0 é final e, daqui em diante, só mudará por acréscimos.
Esse design traz algumas consequências interessantes. Consultas curtas levam uma única ida e volta, então um único POST executa uma instrução e transmite as linhas de volta na mesma resposta. Consultas longas podem ser enviadas, receber um identificador, ser consultadas periodicamente e buscadas depois, e um download interrompido retoma do lote em que parou, de modo que nenhuma requisição precisa sobreviver ao tempo limite de um proxy. Resultados grandes podem ser lidos como várias partições, por conexões separadas, ao mesmo tempo. Tudo o que passa por HTTP passa pelo Chargewire, inclusive o curl e o fetch de um navegador.
Pensando bem, isso é bem engenhoso. Dá para executar uma consulta inteira com curl, sem driver nenhum. Para quem está conectando agentes de IA ou scripts rápidos, isso é muito mais fácil do que gerar stubs gRPC.
O protocolo tem uma descrição OpenAPI 3.1 que o próprio servidor publica em /chargewire/v1/openapi.json, além de uma suíte de conformidade caixa-preta com 282 testes. O Chargewire é Apache 2.0 e fica em um repositório próprio, separado do Hardcharger.
Segurança embutida
O segundo motivo para reconstruir em vez de evoluir é a segurança. O Flight SQL deixa o login, as sessões e a posse dos identificadores a cargo de cada servidor, então cada servidor precisa acertar isso por conta própria, enquanto o Chargewire traz tudo isso no protocolo.
Os tokens são bearer tokens, não cookies, então um navegador nunca envia uma credencial por conta própria e não há CSRF com que se preocupar. Cada identificador (sessões, instruções, resultados, uploads) fica vinculado à identidade que o criou e é verificado a cada uso, então adivinhar o identificador de outra pessoa não funciona. O login único (SSO) roda na própria porta e no próprio certificado do servidor, com o servidor atuando como cliente confidencial do provedor OIDC. Com TLS mútuo, um cliente pode se autenticar apenas com o seu certificado, e os tokens emitidos a partir de um login por certificado ficam vinculados a esse certificado, conforme a RFC 8705, então um token copiado é inútil sem a chave privada.
Dentro do servidor, o controle de acesso é verificado no próprio DuckDB, contra o plano real de cada instrução, depois do binding e de novo antes da otimização, então SQL aninhado, views e macros não conseguem contornar uma permissão. Se ele não consegue classificar a requisição, ela é recusada. Eles também recusam arquivos de credenciais e de sistema no host (chaves SSH, credenciais de nuvem, a própria chave TLS do servidor) na camada de sistema de arquivos do DuckDB, inclusive para o administrador.
Tudo incluído
Mencionei a licença no começo e quero cumprir essa promessa. No GizmoSQL, controle de acesso, instrumentação e SSO eram recursos Enterprise que exigiam uma chave de licença, mas no Hardcharger eles estão incluídos.
Isso significa controle de acesso baseado em papéis, com usuários, papéis e permissões até o nível de coluna, gerenciado em SQL com CREATE ROLE, GRANT e REVOKE. Políticas de linha, mascaramento de colunas, tenants, regras de acesso por catálogo e suporte ao Open Policy Agent. Um log de auditoria que evidencia adulterações. Instrumentação de sessões e instruções, perfis de consulta e um endpoint Prometheus /metrics. Uma fila de instruções, tempos limite, KILL SESSION e desligamento gracioso. Há também uma interface web compilada no binário, com editor de SQL, grade de resultados e navegador de esquemas que respeita o controle de acesso, ativada com --web-ui.
Passar de restrito a gratuito não é a direção que a maioria das empresas segue. O motivo declarado por eles é que toda equipe que roda um DuckDB compartilhado precisa dessas coisas, e é difícil discordar.
Colocando à prova
Há opções de instalação por pacote e por linha de comando para praticamente qualquer plataforma. A versão local não me deu o que eu precisava para resolver o que eu queria, mas a versão na nuvem parece perfeita.
Mas quero descrever o que eu queria testar, porque vi nisso uma oportunidade real de resolver um problema que tenho. Tenho cerca de meia dúzia de coletores de dados especializados no meu laptop, que carregam dados em arquivos DuckDB locais. Preciso compartilhá-los com outras pessoas, mas até agora não encontrei um jeito simples e barato de fazer isso.
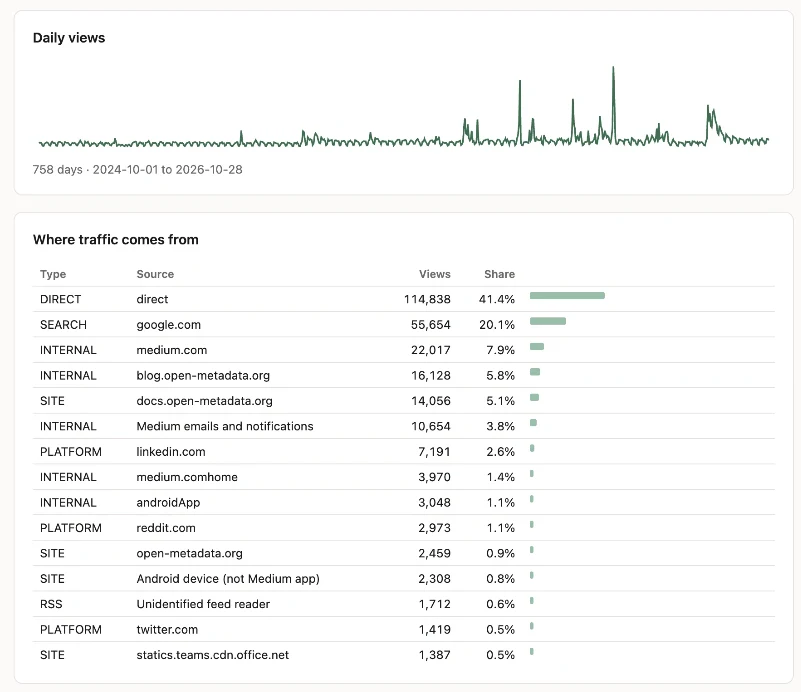
O que usei neste exemplo puxa minhas estatísticas do Medium. Eles não oferecem um bom jeito de obter esses números além de olhar para eles, e eu precisava integrá-los com outras métricas. A captura de tela abaixo é só uma parte do painel que rodo localmente para poder acompanhá-los, mas o Claude também tem skills de DuckDB que me permitem fazer o que preciso com relatórios e com a combinação de outras métricas.
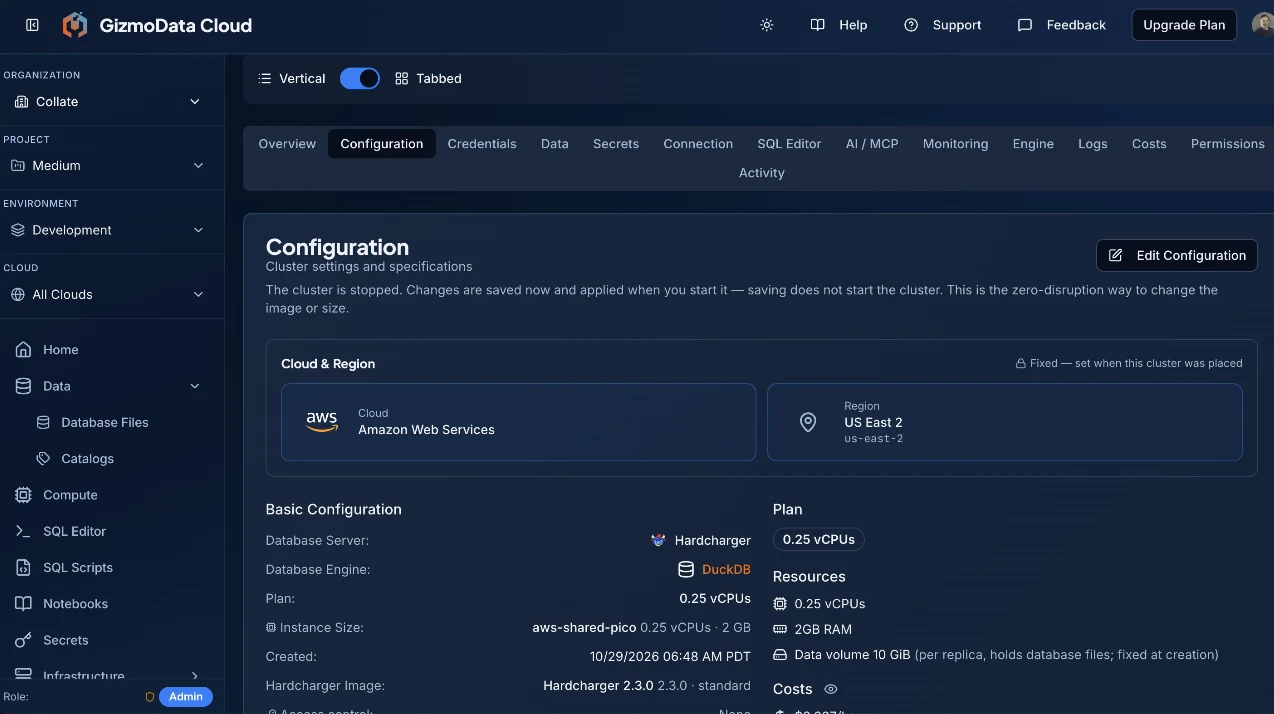
São etapas demais para detalhar aqui, mas, usando a interface web, foi muito simples carregar meu arquivo DuckDB do Medium e deixá-lo disponível na AWS (eles também têm regiões no Azure e no Google Cloud). Aqui está uma imagem do console web.
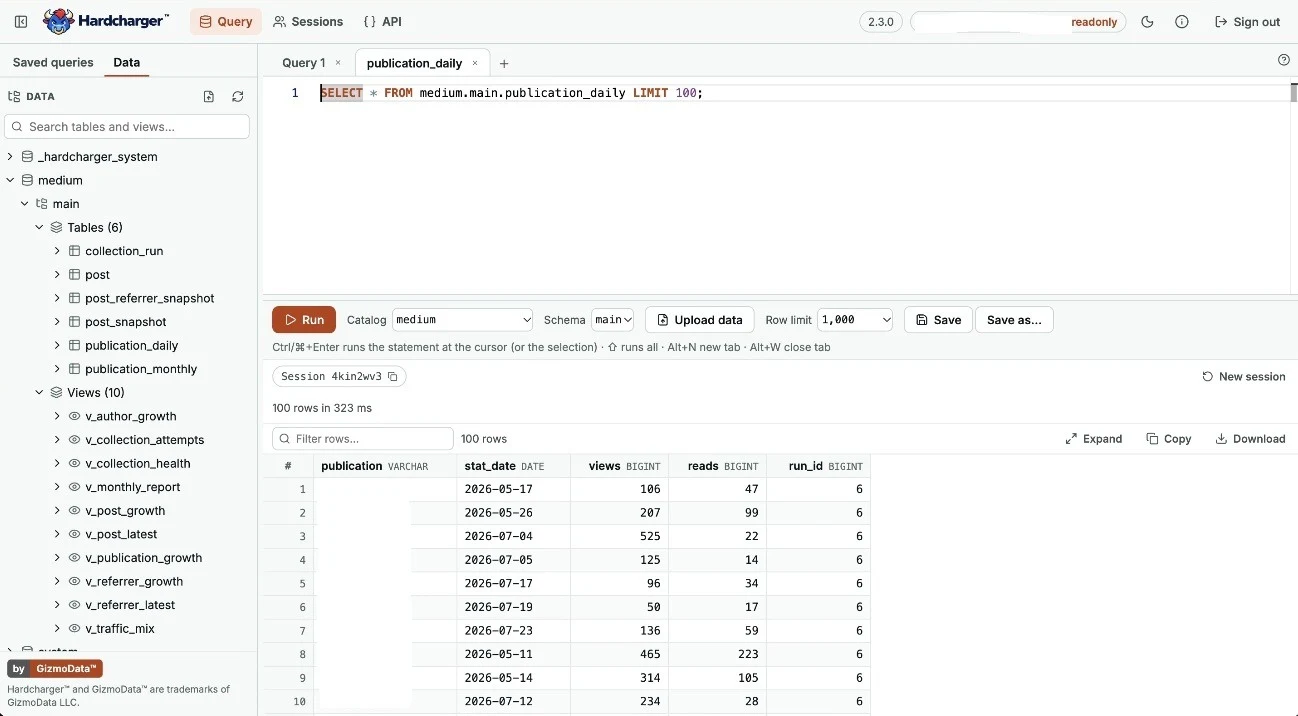
A partir daí, abri o SQL Editor para um teste rápido e visualizei os dados. Censurei a coluna Publication no resultado por motivos de privacidade.
Se você olhar a imagem anterior da interface web, vai notar uma opção de AI/MCP. Há uma opção de MCP disponível para o Hardcharger, e é ali que você encontra o que precisa para incluí-lo em algo como o Claude. Você pode definir seus tokens como somente leitura, admin ou o que for. Para relatórios, eu simplesmente os defini como somente leitura.
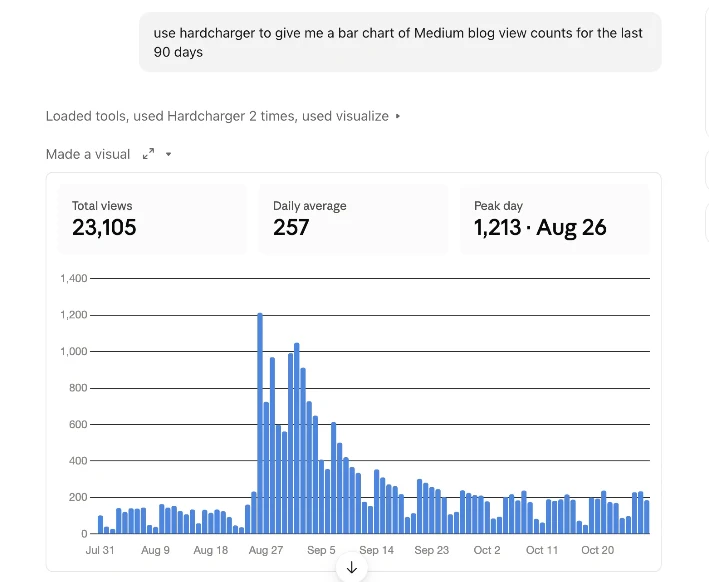
Nesta captura de tela, você pode ver que consegui executar uma consulta em linguagem natural no banco DuckDB e obter um gráfico. Era exatamente disso que eu precisava. Agora só preciso de um processo de coleta diária que grave os dados e de 'n' leitores.
Não tenho como enfatizar o suficiente como foi legal ver isso funcionando, e foi extremamente simples. Agora só preciso atualizar meu código Python de coleta de dados para gravar no servidor remoto. Os drivers cobrem ADBC para Go, Python, C/C++, R e Rust; JDBC como um único jar para Java 17 ou superior, sem gRPC, Netty ou protobuf; e um cliente JavaScript para Node, navegadores, Deno, Bun e Cloudflare Workers.
A documentação é muito boa e traz exemplos para tudo.
Resumo
O Hardcharger é quase perfeito para o que preciso agora, e eles estão trabalhando nos dois recursos que eu gostaria de ter, então espero vê-los em breve. O primeiro é fazer o cluster subir automaticamente quando chega uma requisição. Na verdade, não preciso dele rodando o tempo todo; o acesso é bem esporádico. O outro é uma forma de colocar meus aplicativos de coleta de dados no servidor deles.
Então, afinal, o que é o Hardcharger? É um servidor de código aberto que coloca o DuckDB 2.0 na rede, construído sobre um novo protocolo baseado em HTTP chamado Chargewire, que transmite Apache Arrow e funciona com qualquer proxy, balanceador de carga ou comando curl que você já tenha. É o sucessor do GizmoSQL, reconstruído do zero, com tudo o que antes ficava atrás de uma chave de licença Enterprise agora incluído. Se você queria um DuckDB remoto com controle de acesso de verdade e não queria brigar com gRPC na sua infraestrutura para isso, vale a sua tarde.
Confira meus outros artigos da série What the Heck is... (em inglês) nos links abaixo:
- What The Heck Is DuckDB?
- Afinal, o que é GizmoSQL?
- What the Heck Is Malloy?
- What the Heck is PRQL?
- What the Heck is GlareDB?
- What the Heck is SeaTunnel?
- What the Heck is LanceDB?
- What the heck is SDF?
- What the Heck is Paimon?
- What the Heck is Proton?
- What the Heck is PuppyGraph?
- What the Heck is GPTScript?
- What the Heck is WarpStream?
- What the Heck is Duckle?
- What the Heck is Renart?
- What the Heck is Jev?
Sobre o autor: Shawn Gordon se descreve como designer/desenvolvedor de software, developer advocate, escritor e músico. Ele escreve a série “What the Heck is...” no HackerNoon.
Este artigo foi publicado originalmente em inglês no HackerNoon por Shawn Gordon e é republicado aqui com autorização.