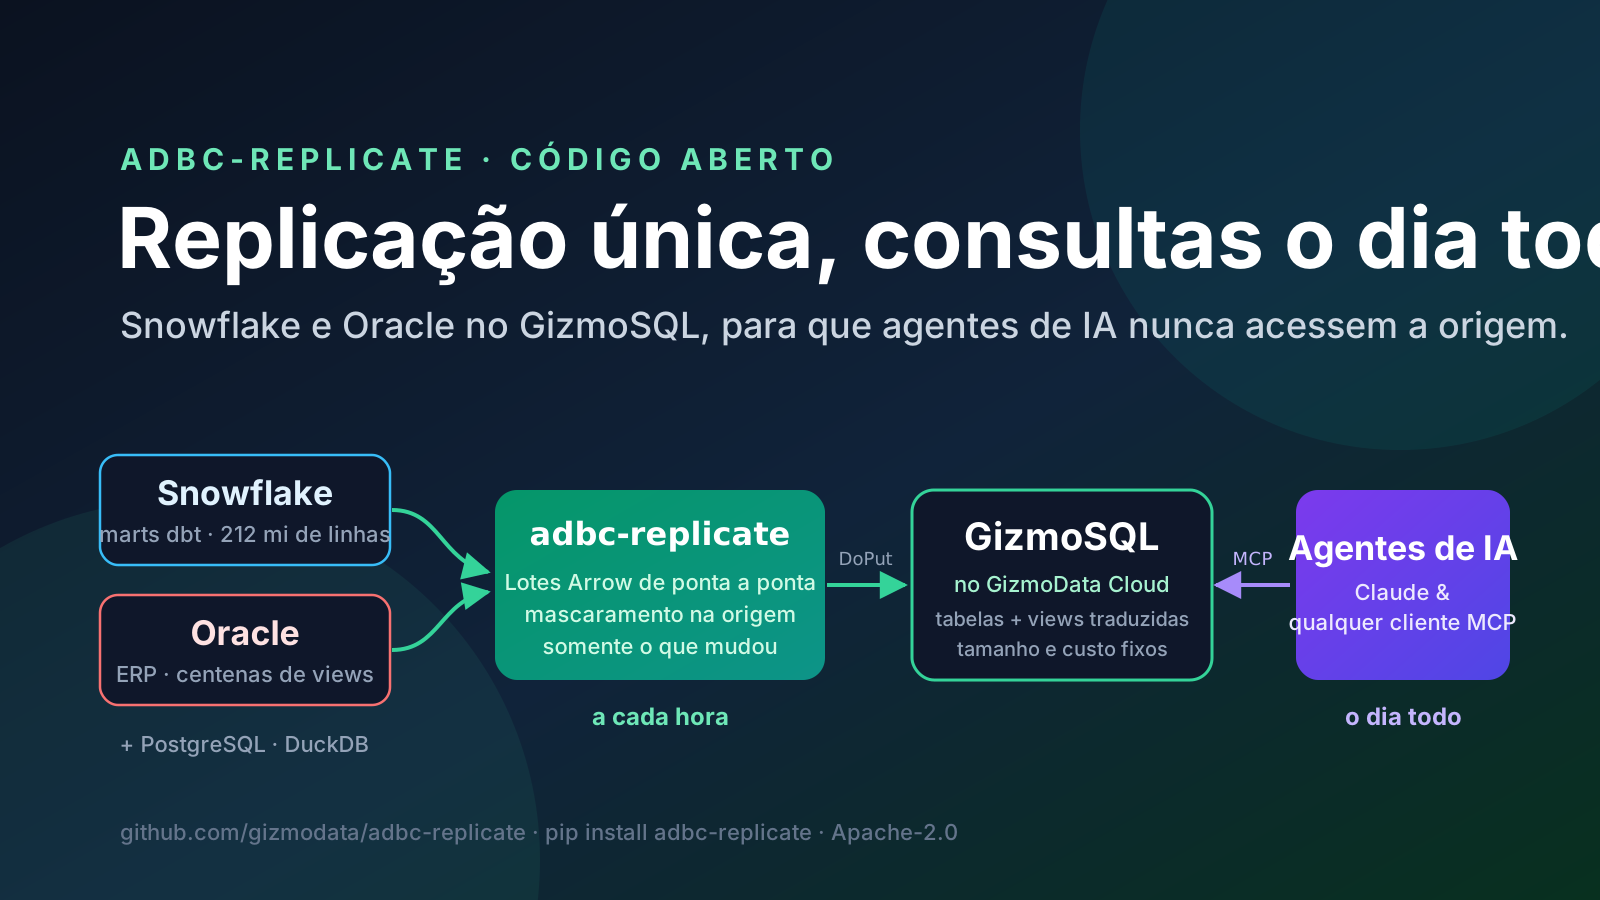
Agentes de IA fazem muitas consultas. Para responder a uma pergunta em linguagem natural, o Claude pode listar tabelas, descrever algumas, tentar uma consulta, corrigi-la e executar mais duas. Faça isso para uma empresa inteira, o dia todo, e você terá uma carga de trabalho para a qual nenhum data warehouse foi dimensionado em termos de preço, sobre um banco de dados que nunca foi projetado para receber esse volume.
Dois de nossos clientes resolveram isso da mesma forma, embora usem fontes bem diferentes. Um mantém os dados no Snowflake. O outro, um fabricante, administra a operação no ERP Oracle. Agora, os dois copiam a cada hora os dados de que seus agentes precisam para o GizmoSQL no GizmoData Cloud e direcionam os agentes para essa cópia pelo servidor MCP do GizmoSQL. A ferramenta que faz a cópia é o adbc-replicate, que acabamos de lançar como código aberto (Apache-2.0). Este artigo explica o que a ferramenta faz, como os dois clientes a utilizam e os números reais dos registros de execução.
Por que não deixar os agentes consultarem a fonte?
No Snowflake, o problema é a conta. O Snowflake cobra por segundo enquanto o warehouse está em execução, com um mínimo de 60 segundos a cada inicialização. Esse modelo funciona bem para um painel que atualiza às 8h. Já um agente que responde às perguntas conforme elas surgem não se encaixa: cada pergunta desperta o warehouse ou o mantém ativo, e o custo cresce conforme aumenta a curiosidade da equipe. É o oposto do que você quer para uma ferramenta que espera que todos usem.
No Oracle, o problema é o risco. O banco de dados Oracle do fabricante mantém a fábrica em operação: pedidos, estoque, ordens de produção e o razão contábil. Consultas SQL analíticas exploratórias escritas por um modelo de linguagem não deveriam ser executadas nessa máquina durante um turno. Além disso, o dialeto SQL do Oracle não é aquele em que a maioria das ferramentas — e dos modelos — escreve melhor.
A replicação resolve os dois problemas. A fonte recebe um único processo agendado por hora, e os agentes ganham um mecanismo DuckDB próprio: o GizmoSQL em um cluster cujo tamanho você escolhe, com o mesmo custo quer os agentes façam dez consultas por dia, quer façam dez mil.
O que o adbc-replicate faz
Você descreve o que quer replicar em um arquivo YAML, e o adbc-replicate cuida do restante. Por baixo dos panos, é um único fluxo Arrow do banco de dados de origem até o GizmoSQL (falaremos mais sobre isso na próxima seção).
- Fontes: Oracle (por meio do nosso driver ADBC para Oracle, sem precisar instalar o Oracle Client), Snowflake, PostgreSQL e DuckDB. Destinos: GizmoSQL e DuckDB.
- Seleção de objetos por padrão: escolha schemas, tabelas e views com curingas (
SALES_*) ou expressões regulares, exclusões e renomeação dos schemas de destino. Você também pode copiar as linhas de uma view como tabela. - As máscaras são aplicadas na própria fonte. As colunas podem ser excluídas ou mascaradas com
null, um hash com salt, um valor fixo ou qualquer expressão SQL. A máscara faz parte doSELECTexecutado no banco de dados de origem, então os valores originais nunca trafegam pela rede. Se uma regra de máscara não corresponder a nenhuma coluna, a execução é interrompida, pois um erro de digitação poderia expor uma coluna. - Snapshots consistentes: todas as tabelas podem ser lidas no mesmo instante: por um SCN do Oracle, um snapshot exportado do PostgreSQL ou um timestamp de time travel do Snowflake. As chaves estrangeiras permanecem coerentes.
- Cópia apenas do que mudou: uma verificação de metadados quando a fonte oferece esse recurso (
LAST_ALTEREDno Snowflake); caso contrário, uma contagem de linhas e uma impressão digital do conteúdo calculada na própria fonte. As mesclagens incrementais usam a chave primária e oORA_ROWSCNdo Oracle, ou uma coluna de marca d'água comoDBT_RUN_STARTED_ATdo dbt. - As views também são replicadas, convertidas para SQL do DuckDB, direcionadas às tabelas replicadas e criadas na ordem de suas dependências. Voltaremos a esse assunto mais adiante, porque essa é a parte difícil.
- Execução atômica e observável: cada tabela é substituída dentro de uma transação, para que os leitores nunca vejam uma tabela carregada pela metade. Cada execução é registrada em tabelas SQL junto aos dados, e um webhook do Slack (ou qualquer outro) informa o resultado de cada execução.
- Execução em qualquer ambiente: com
pip install adbc-replicate, uma imagem de contêiner ou um chart Helm que a executa como CronJob no Kubernetes.
O poder do ADBC: um fluxo Arrow da origem ao destino
A maioria das ferramentas de replicação usa APIs orientadas a linhas. Elas buscam linhas por ODBC ou JDBC, convertem cada valor para uma representação própria e, depois, fazem INSERT em lotes ou gravam arquivos CSV ou Parquet em um bucket e executam um COPY. Cada etapa consome CPU e memória, e o bucket de preparação é mais um recurso que precisa ser protegido e limpo.
ADBC (Arrow Database Connectivity) é a API de banco de dados do projeto Apache Arrow. No ADBC, o resultado de uma consulta é um fluxo Arrow. Isso muda a estrutura de todo o processo. Reduzida ao essencial, uma cópia é assim:
1import adbc_driver_gizmosql.dbapi as gizmosql
2import adbc_driver_postgresql.dbapi as postgresql
3
4with postgresql.connect(uri="postgresql://postgres:postgres@127.0.0.1:5439/postgres") as source, \
5     gizmosql.connect(uri="gizmosql://127.0.0.1:31349?transport=tcp",
6                      username="gizmosql", password="gizmosql") as target:
7    with source.cursor() as src, target.cursor() as dst:
8        src.execute(operation="SELECT id, amount, ordered_at FROM orders")
9        reader = src.fetch_record_batch()   # a lazy stream of Arrow record batches
10        rows = dst.adbc_ingest(table_name="orders", data=reader, mode="replace")
11    target.commit()
12    print(f"{rows:,} rows streamed")
Ao escrever este artigo, executamos exatamente esse código em uma tabela PostgreSQL com um milhão de linhas. A saída foi 1,000,000 rows streamed, e o processo Python atingiu um pico de cerca de 155 MB, em sua maior parte consumidos pelo interpretador e pelos drivers. O processo nunca mantém a tabela inteira na memória, porque fetch_record_batch() retorna um RecordBatchReader, um fluxo do qual o destino lê um lote de cada vez. No GizmoSQL, adbc_ingest é uma única operação Flight SQL DoPut: um fluxo gRPC de lotes Arrow que o servidor insere diretamente no DuckDB usando uma leitura Arrow. Os dados permanecem em formato colunar desde o driver de origem até o armazenamento do DuckDB, e o Python nunca toca em uma linha individual.
O adbc-replicate mantém esse pipeline e acrescenta o que uma cópia de verdade precisa, em etapas de streaming que mantêm no máximo um lote por vez:
- Renomeação: as colunas recebem os nomes de destino (em minúsculas por padrão), inclusive aquelas que você renomeou.
- Correções de tipos por fonte: os tipos de extensão Arrow específicos da fonte são convertidos em tipos Arrow simples. Quando um driver retorna um valor com perda de precisão, o valor é lido exatamente: o driver do PostgreSQL entrega
numericcomo texto (a tabela do nosso teste com um milhão de linhas foi gravada comoVARCHAR), então o adbc-replicate o converte de volta paraDECIMAL(p,s); já oNUMBERsem precisão definida do Oracle é lido comoDECIMAL(38,10), em vez de um double com perda de precisão. - Combinação de lotes: lotes pequenos da fonte são combinados até chegar a 65.536 linhas ou 12 MiB antes do envio, mantendo cheios os buffers de inserção do GizmoSQL.
- Substituições atômicas: a ingestão ocorre dentro de uma transação, então os leitores continuam vendo a tabela antiga até a confirmação da nova.
Os drivers cuidam do restante. Nosso driver Oracle é escrito em Go e decodifica diretamente para Arrow o protocolo de comunicação do Oracle, sem exigir a instalação do Oracle Client. O driver ADBC do Snowflake baixa em paralelo blocos de resultados do armazenamento em nuvem do Snowflake, e o adbc-replicate limita a fila de pré-busca para manter o uso de memória estável mesmo em resultados enormes. Todas as fontes seguem o mesmo caminho de código, então adicionar uma fonte significa incluir um driver e um módulo de origem com algumas centenas de linhas, em vez de criar outro pipeline. Nas medições do próprio projeto, uma tabela Oracle com 2 milhões de linhas foi copiada a cerca de 500.000 linhas por segundo em um laptop, com pico de aproximadamente 250 MB de memória no cliente. (Para saber mais sobre os drivers, consulte o conjunto de drivers ADBC do GizmoData e a ingestão em lote com Flight SQL.)
O cliente Snowflake: GizmoData Cloud at Customer
Nosso cliente Snowflake executa o GizmoData Cloud at Customer em sua própria conta de nuvem. O adbc-replicate também é executado lá, como um CronJob do chart Helm no cluster Kubernetes do cliente, a cada hora, às meias horas, logo após as execuções do dbt que terminam na hora cheia. Ele copia integralmente dois schemas do dbt, além das tabelas de preparação necessárias para algumas views: centenas de tabelas e views. Dados pessoais (números de documentos de identificação governamental, datas de nascimento e dados de contato pessoal dos funcionários) são mascarados como NULL dentro do Snowflake, antes de qualquer dado sair de lá.
A configuração é curta. Este é o formato, com os nomes alterados:
version: 1
name: snowflake-to-gizmosql

source:
  type: snowflake
  options:
    username: REPLICATOR
    adbc.snowflake.sql.account: ${SNOWFLAKE_ACCOUNT}
    adbc.snowflake.sql.warehouse: REPLICATOR_WH
    adbc.snowflake.sql.db: ANALYTICS
    adbc.snowflake.sql.auth_type: auth_jwt
    adbc.snowflake.sql.client_option.jwt_private_key_pkcs8_value: ${SNOWFLAKE_PRIVATE_KEY}

target:
  type: gizmosql
  uri: gizmosql://analytics.example.com:31337
  username: ${GIZMOSQL_USERNAME}
  password: ${GIZMOSQL_PASSWORD}

objects:
  - db_schemas: [MARTS, CORE]          # every table and view in both

columns:
  - tables: ["*"]
    mask:
      SSN: "null"                      # masked inside Snowflake
      DATE_OF_BIRTH: "null"
    fingerprint_ignore: [DBT_INVOCATION_ID, DBT_RUN_STARTED_AT]

refresh:
  mode: incremental                    # merge only the rows dbt stamped since the last run
  watermark_column: DBT_RUN_STARTED_AT
  detect_deletes: false

notifications:
  - url: ${SLACK_WEBHOOK_URL}
    when: [failure, view_errors, success]
O modo incremental é mais importante nas tabelas maiores. Um modelo incremental do dbt com dezenas de milhões de linhas pode receber alguns milhares por dia — e só essas linhas são transferidas: as que o dbt marcou desde a última execução, mescladas pela chave. Uma tabela recriada integralmente pelo dbt é ignorada quando sua impressão digital não mudou; como essa impressão ignora as colunas de metadados de execução do dbt, recriar um modelo com o mesmo conteúdo não transfere nada. Depois de cada mesclagem, a contagem de linhas precisa corresponder à do Snowflake. Se não corresponder, a tabela inteira será copiada.
O adbc-replicate surgiu do carregador escrito à mão que criamos primeiro para esse cliente. Agora, a implantação consiste em um arquivo YAML e nos valores do Helm.
O cliente Oracle: GizmoData Cloud
O fabricante usa o GizmoData Cloud, nosso serviço hospedado. O adbc-replicate é executado de hora em hora em um servidor na própria rede do cliente e envia os dados para o cluster. Cada execução lê o schema inteiro em um único SCN do Oracle, para que a tabela de peças e os pedidos que fazem referência a ela sempre representem o mesmo instante.
version: 1
name: erp-to-gizmosql

source:
  type: oracle                         # no Oracle Client needed
  uri: oracle://erp-db.example.com:1521/PROD
  username: ${ORACLE_USERNAME}
  password: ${ORACLE_PASSWORD}
  consistency: snapshot                # every table read at one SCN

target:
  type: gizmosql
  uri: gizmosql://erp.example.com:31337
  username: ${GIZMOSQL_USERNAME}
  password: ${GIZMOSQL_PASSWORD}

objects:
  - db_schemas: [ERP]
    exclude_tables: ["*_BAK", "/^TMP_/"]

views:
  source_time_zone: America/New_York   # what SYSDATE means on the source

parallelism: 4
Como ocorre com a maioria dos ERPs antigos, o sistema deles contém centenas de views: anos de lógica empresarial escrita em SQL do Oracle. São essas views que tornam a réplica útil para um agente. Quando um agente pergunta sobre pedidos atrasados, ele deve usar a definição de “atrasado” que a empresa já considera confiável, sem reinventá-la a partir das tabelas brutas.
Os números, extraídos dos registros de execução
Ao final de cada execução, um resumo é publicado em um canal do Slack. Estes números vêm diretamente dessas mensagens e abrangem o período desde a primeira cópia completa de cada cliente (14 de outubro para o cliente Oracle e 15 de outubro para o cliente Snowflake) até a manhã de 16 de outubro de 2026:
Cliente Snowflake
Snowflake → GizmoData Cloud at Customer
- Replicado
- Mais de 200 tabelas, mais de 100 views
- Primeira cópia completa
- 212,0 milhões de linhas em 31 min 19 s
- Agendamento
- A cada hora, após as execuções do dbt
- Uma hora tranquila
- Nada copiado, 2–4 min
- Uma hora típica
- 1–64 tabelas, até 2,5 milhões de linhas, 2–7 min
- Maior execução por hora
- 41 tabelas, 44,6 milhões de linhas em 18 min 22 s
- Execuções com falha
- Nenhuma (as duas primeiras sinalizaram duas views; veja abaixo)
Cliente Oracle
Oracle → GizmoData Cloud
- Replicado
- Mais de 150 tabelas, centenas de views
- Primeira cópia completa
- 16,1 milhões de linhas em 1 h 10 min (um escopo inicial mais amplo, com cerca de 500 tabelas)
- Agendamento
- A cada hora, em um único SCN do Oracle
- Uma hora tranquila
- Nada copiado, cerca de 4½ min
- Uma hora típica
- 1–5 tabelas, até 170.000 linhas, 4–5 min
- Maior execução por hora
- 5 tabelas, 169.122 linhas em 4 min 37 s
- Execuções com falha
- Nenhuma (as primeiras sinalizaram views não traduzidas; veja abaixo)
Em uma hora tranquila, nenhum dado das tabelas trafega pela rede. O adbc-replicate pergunta à fonte se cada tabela mudou (primeiro, os metadados LAST_ALTERED do Snowflake; depois, uma impressão digital calculada dentro do banco de dados; no Oracle, a impressão digital) e copia somente as tabelas que mudaram. Estas são as mensagens publicadas a cada hora:
Duas execuções reais de 16 de outubro de 2026, reproduzidas a partir do nosso canal do Slack (nomes alterados; IDs de execução, nomes de hosts e alguns totais omitidos).
Depois, os agentes entram em ação
No outro lado da cópia, os dois clientes usam o servidor MCP do GizmoSQL. O cliente Snowflake o executa como conector remoto em sua própria conta de nuvem, para que os funcionários o utilizem no Claude pela web, no computador e nos celulares. Eles entram com suas contas corporativas da Microsoft, e o servidor consulta o GizmoSQL com uma conta de serviço somente para leitura. A equipe do fabricante direciona o mesmo servidor MCP para seu cluster do GizmoData Cloud.
Por padrão, o servidor MCP permite apenas leitura, aplica limites de linhas e tempos-limite às consultas no servidor e não inclui credenciais na saída das ferramentas. As permissões do próprio GizmoSQL determinam o que um agente pode ver, e as colunas mascaradas nem sequer foram copiadas.
Para o cliente Snowflake, o resultado é um custo previsível. O Snowflake faz a replicação uma vez por hora, em poucos minutos, e as perguntas dos agentes nunca o acessam, independentemente de quantas pessoas perguntem. O cluster do GizmoSQL que responde a elas tem tamanho e preço fixos. Para o fabricante, o ERP continua mantendo a fábrica em operação, enquanto as pessoas que fazem perguntas obtêm a velocidade do DuckDB em uma cópia consistente com, no máximo, uma hora de defasagem.
Conversão de views: a parte difícil
Copiar tabelas é, em grande parte, trabalho de infraestrutura. É na conversão de views que uma ferramenta de replicação pode retornar respostas erradas sem deixar isso claro — e aprendemos isso com o schema Oracle real do fabricante. O adbc-replicate usa como base o sqlglot, um excelente conversor de SQL entre dialetos. Mas, quando não consegue expressar algo no dialeto de destino, um conversor pode produzir SQL que executa, mas tem outro significado. Encontramos alguns casos:
- As junções externas
(+)do Oracle podem virar junções internas: a view executa e retorna silenciosamente menos linhas. TO_CHAR(dt, 'YYYY-MM')pode perder o formato e se tornar uma conversão simples para texto.CAST(x AS DATE)mantém a hora no Oracle e a descarta no DuckDB.SYSDATEé a hora local do servidor de origem. Convertida para “agora” em UTC, todas as views que usam “hoje” ou calculam a idade de registros ficavam com diferença de quatro ou cinco horas.- NULL na concatenação de strings: o Oracle trata NULL como uma string vazia em
||, enquanto o DuckDB retorna NULL. Os números também são exibidos de outra forma (1.50aparece como1.5no Oracle).
Por isso, o adbc-replicate nunca deixa uma conversão falhar sem aviso. Uma construção que não pode ser convertida fielmente é reportada, nunca alterada em silêncio. Cada reescrita do Oracle (consultas hierárquicas CONNECT BY convertidas para WITH RECURSIVE, ROWNUM, INSTR com uma ocorrência, formatos de TO_CHAR e semântica de strings e datas do Oracle) é verificada valor por valor em um banco de dados Oracle real nos testes de integração. O que não puder ser tratado dessa forma pode ser resolvido pela configuração: funções PL/SQL reescritas em SQL do DuckDB, substituições feitas à mão ou a opção de “copiar as linhas desta view”.
Na primeira execução completa nesse schema, em 14 de outubro, o processo informou que não era possível converter fielmente mais de um quarto das views. Um dia e quatro versões depois, a execução por hora cria todas as views incluídas no escopo, sem falhas. As únicas duas falhas da primeira execução do cliente Snowflake acabaram sendo views que já falham no próprio Snowflake; agora, elas são excluídas.
Mais um aprendizado sobre mascaramento: mascarar uma coluna pode esvaziar uma view que faz junção por essa coluna, porque uma chave NULL não corresponde a nenhuma outra. Se uma view faz junção com uma tabela de consulta usando um ID confidencial, mascare o rótulo da tabela, não a chave, e compare a contagem de linhas da view com a da fonte depois de qualquer mudança na máscara.
Experimente em cinco minutos
Instale a ferramenta com os drivers necessários e peça a ela que crie uma configuração inicial:
pip install "adbc-replicate[snowflake,gizmosql]"   # or oracle, postgresql, duckdb, all

adbc-replicate init replicate.yaml          # a starter config to edit
adbc-replicate test-connection --config replicate.yaml
adbc-replicate plan --config replicate.yaml # what would be copied, masked and translated
adbc-replicate run --config replicate.yaml
plan se conecta apenas à fonte e mostra todas as tabelas, todas as colunas excluídas ou mascaradas e se cada view pode ser convertida, antes que qualquer dado seja gravado. Execute run uma segunda vez e as tabelas que não mudaram serão ignoradas:
⏭️  shop.customers: unchanged (fingerprint, 1,000 rows)
⏭️  shop.orders: unchanged (fingerprint, 100,000 rows)
📊 Tables: 0 copied (0 rows), 2 unchanged, 0 failed in 0.0s
🪟 Views: 0 created, 1 unchanged, 0 failed
O guia de início rápido do README mostra como executar todo o processo localmente com dois contêineres Docker (PostgreSQL para GizmoSQL) e documenta cada opção de configuração, o chart Helm e os detalhes específicos do Oracle e do Snowflake. A saída acima vem de uma execução nossa feita enquanto escrevíamos este artigo.
Uma ressalva sincera: os agentes veem os dados como estavam na última execução. Para as perguntas que as pessoas fazem a um assistente de IA (“como foram as vendas de serviços na semana passada?”, “quais peças estão abaixo do ponto de reposição?”), uma hora é suficiente, e a fonte continua sendo o sistema oficial de registro. Se você precisa de dados atualizados em menos de um minuto, execute a ferramenta com mais frequência ou mantenha essa carga de trabalho na fonte.
Dê aos seus agentes um mecanismo próprio
Replique para o GizmoData Cloud
Comece gratuitamente com US$ 25 em créditos de lançamento, aplicados automaticamente. Não é necessário cartão de crédito. Crie um cluster do GizmoSQL, direcione o adbc-replicate para ele e conecte o Claude pelo servidor MCP. Se preferir manter tudo na sua própria conta de nuvem, essa opção é o GizmoData Cloud at Customer.