
A MotherDuck publicou há pouco Bringing the Big Ducks, um benchmark da sua maior instância, a Giga, que ela descreve como "the better part of an instance with 192 cores and 1.5 TB of RAM" (a maior parte de uma instância com 192 núcleos e 1,5 TB de RAM). Nas 99 consultas do TPC-DS, ela registrou média geométrica de 0,69 segundo em 1 TB e 5,6 segundos em 10 TB, e comparou esses números com resultados publicados do Redshift, Snowflake, Databricks, BigQuery e Synapse. É um bom post, com um método claro, e nós gostamos de um desafio.
Então aceitamos. Uma empresa pequena, que se financia sozinha. Um produto com menos de duas semanas de vida: o Hardcharger, nosso servidor open source para DuckDB 2.0, lançado em 21 de outubro. Uma máquina no GizmoData Cloud, da mesma classe que a MotherDuck usou: uma AWS Graviton5 r9gd.48xlarge com 192 vCPUs, 1,5 TB de memória e NVMe local. As mesmas 99 consultas, executadas exatamente como a MotherDuck executou.
O Hardcharger terminou com média geométrica de 0,463 segundo em 1 TB e 3,39 segundos em 10 TB. Isso é 1,5 vez mais rápido que o Giga da MotherDuck em 1 TB e 1,65 vez mais rápido em 10 TB, e mais rápido que todos os sistemas do post da MotherDuck: Amazon, Snowflake, Databricks, Google, Microsoft e também o MySQL HeatWave da Oracle. As 99 consultas retornaram resultados nas duas escalas, e o mesmo trabalho custa menos no GizmoData Cloud do que no Giga.
Os resultados
Cada número é a média geométrica dos melhores tempos a quente das 99 consultas, em segundos (menor é mais rápido). É o método da MotherDuck: uma execução a frio que não conta, depois a melhor de três execuções a quente por consulta, cronometradas no cliente e incluindo a leitura dos resultados.
| 1 TB (SF1000) | 10 TB (SF10000) | |
|---|---|---|
| GizmoData Cloud, Hardcharger 2.4.1 | 0,463 s | 3,39 s |
| MotherDuck Giga | 0,690 s | 5,6 s |
| MotherDuck Mega | 2 s | – |
| MySQL HeatWave | – | 5 s |
| Amazon Redshift | 4,20 s | 8 s |
| Snowflake | 4,90 s | 13 s |
| Databricks | 5,95 s | – |
| Google BigQuery | 6,11 s | 20,2 s |
| Azure Synapse | 9,15 s | 22,9 s |
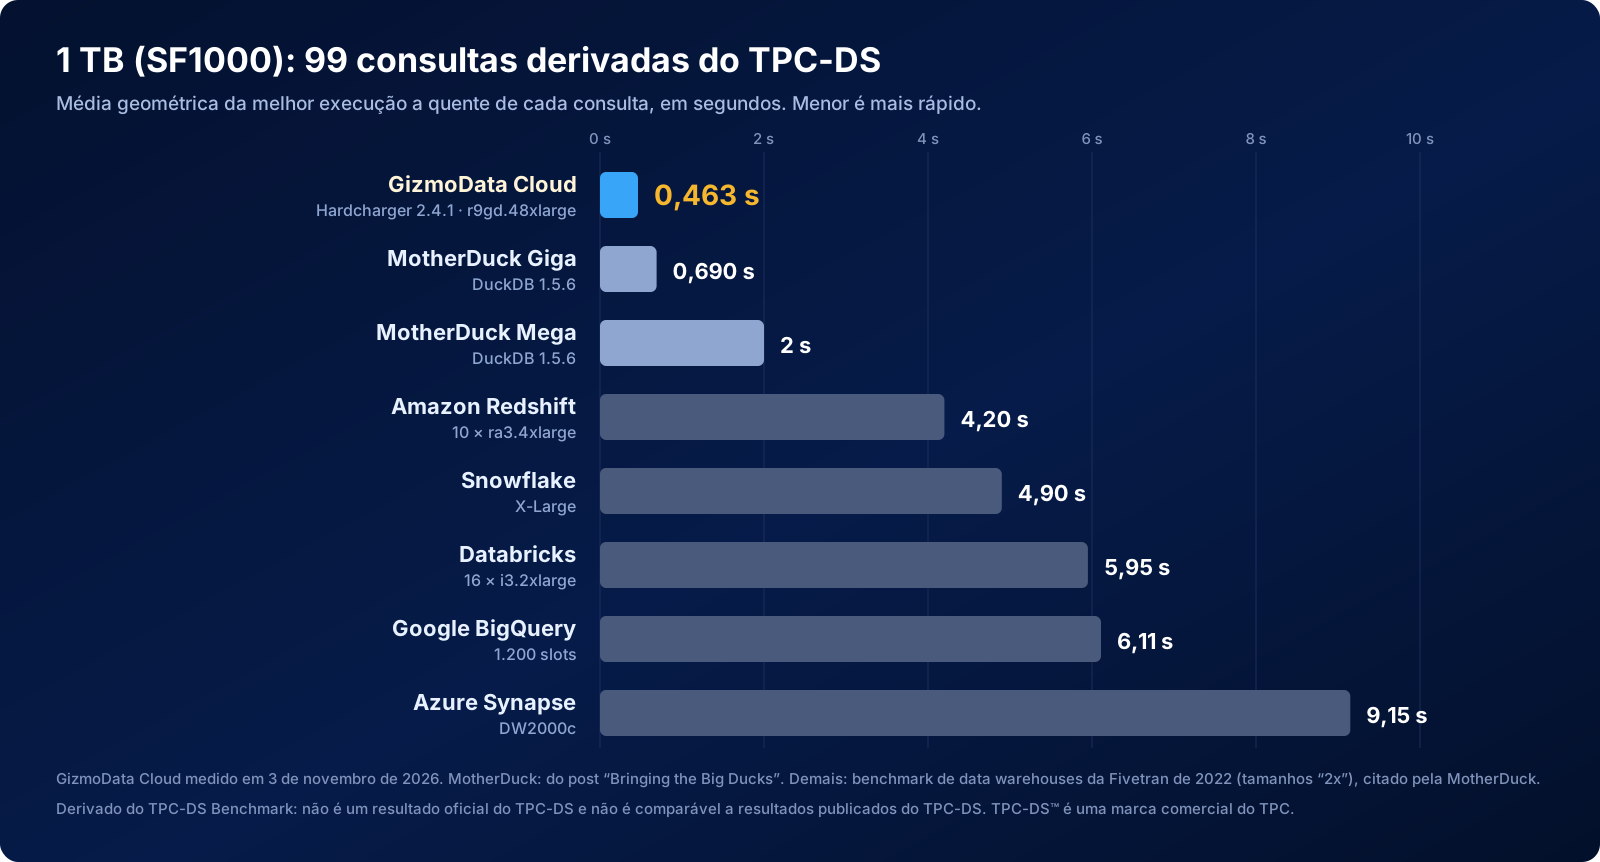
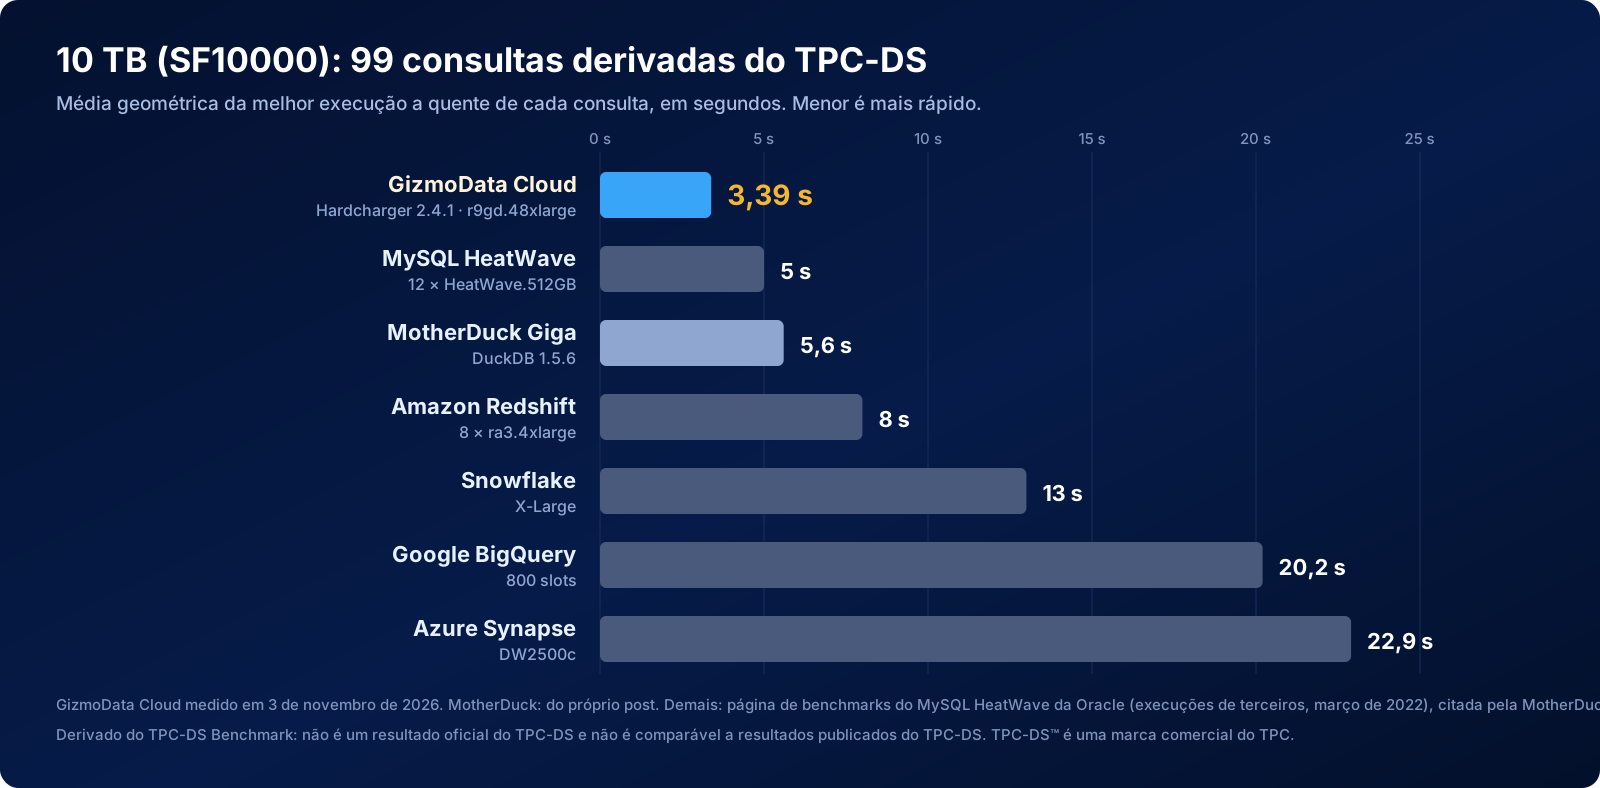
De onde vêm os outros números: os da MotherDuck são do próprio post. Como no post dela, os números de 1 TB dos outros sistemas vêm do benchmark de data warehouses da Fivetran de 2022, nos tamanhos que ele chama de "2x": Redshift com 10 nós ra3.4xlarge, um Snowflake X-Large, Databricks com 16 workers i3.2xlarge, 1.200 slots do BigQuery e Synapse DW2000c. (O post da MotherDuck chama o resultado do Snowflake de "2XL"; nos dados da Fivetran, o tamanho 2x do Snowflake é o X-Large.) Os números de 10 TB vêm da página de benchmarks do MySQL HeatWave da Oracle, que traz execuções feitas por terceiros em março de 2022: Redshift com 8 nós ra3.4xlarge, um Snowflake X-Large, 800 slots do BigQuery e Synapse DW2500c. A mesma página traz o resultado da própria Oracle para o HeatWave, 5 segundos com 12 nós HeatWave.512GB. Ao contrário dos outros, esse foi executado pela própria Oracle no seu próprio serviço, ajustado à mão: codificações de colunas e distribuição de dados personalizadas, uma dica em cada consulta que a força a rodar no HeatWave e dicas straight_join em algumas consultas para um plano melhor. Não é o conjunto de consultas sem modificações que a MotherDuck e nós executamos, e o Hardcharger é mais rápido que ele de qualquer forma. O post da MotherDuck aponta o Redshift (8 segundos) como o mais rápido dos outros e não menciona o HeatWave, então nós o incluímos.
Todos os mecanismos dessa lista muito provavelmente ficaram mais rápidos desde 2022, como a própria MotherDuck observa. A comparação equivalente é com a MotherDuck: as mesmas consultas, o mesmo método e a mesma classe de máquina.
Uma equipe pequena, um produto novo e concorrentes de peso
Veja quem está nesse gráfico. Amazon, Google, Microsoft e Oracle constroem as próprias nuvens. Snowflake e Databricks são dois dos maiores nomes em dados, com milhares de engenheiros somados. A MotherDuck é uma equipe com bons investidores e que respeitamos, rodando DuckDB no seu maior hardware. E na primeira linha está uma startup que se financia sozinha, com um produto que ela lançou em 21 de outubro.
Não é sorte, e não é mágica. É uma aposta que fizemos cedo: não construir um mecanismo novo, colocar o melhor na rede e sair do caminho dele. O DuckDB é o mecanismo analítico mais rápido que a maioria das equipes já usou. O Hardcharger o transforma em um servidor de verdade, com controle de acesso, login único (SSO), mTLS, logs de auditoria e um protocolo rápido nativo em Arrow, tudo incluído, e o GizmoData Cloud o executa no hardware mais novo que cada nuvem vende, com o preço à vista antes de você clicar em Create. Quando o DuckDB fica mais rápido, você fica mais rápido no mesmo dia. Quando a AWS lança um chip mais rápido, ele aparece como um novo tamanho. Ninguém precisa trocar de plataforma.
É por isso que uma equipe do nosso tamanho consegue se alinhar com esses nomes e sair na frente. Você não precisa de um data warehouse que cobra por crédito para executar 99 consultas pesadas sobre 10 TB em poucos segundos cada. Você precisa de uma boa máquina e do mecanismo certo nela.
Por que é mais rápido
Adoraríamos ficar com todo o crédito, mas a maior diferença provavelmente é a versão do mecanismo. A MotherDuck usou o DuckDB 1.5.6. O Hardcharger 2.4.1 usa o DuckDB 2.0.0, lançado na semana anterior ao post da MotherDuck, e a própria MotherDuck reconheceu isso: "I'm also not showing DuckDB in its best light either" (também não estou mostrando o DuckDB no seu melhor). Na nossa corrida TPC-H entre três nuvens, a versão alfa do DuckDB 2.0 reduziu de 22% a 31% o tempo de execução em NVMe local, sem nenhuma outra mudança. Boa parte do crédito é da equipe do DuckDB, e colocar o DuckDB 2.0 nas suas mãos como um servidor de produção é exatamente a razão de ser do Hardcharger. Não executamos o DuckDB 1.5.6 nesta máquina, então não sabemos dizer exatamente quanto da diferença vem do mecanismo e quanto vem do resto.
O resto é a configuração. Os dados ficam em um banco DuckDB nos 11 TB de NVMe da própria máquina, não em armazenamento de rede. O chip é o mais novo da AWS, o Graviton5. E definimos quatro configurações do mecanismo:
SET GLOBAL threads = 191;
SET GLOBAL memory_limit = '1150GiB';
SET GLOBAL preserve_insertion_order = false;
SET GLOBAL enable_external_file_cache = false;
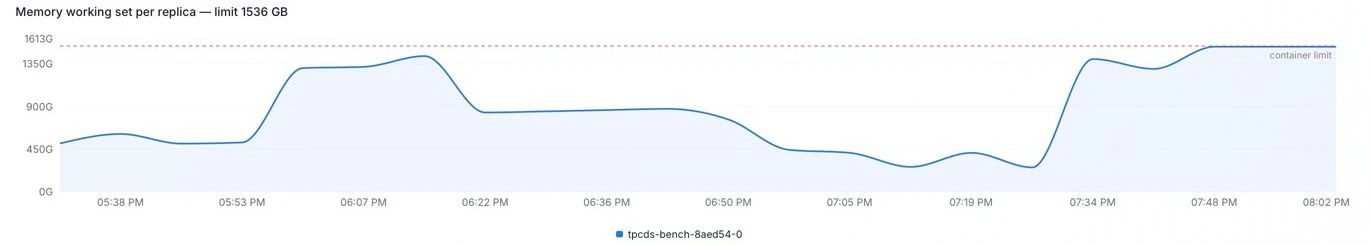
O número de threads foi o que mais pesou. O Hardcharger começou com 256 threads em um cluster com direito a 191 núcleos, então o Kubernetes passou a limitar sua CPU; igualar o número de threads ao de núcleos deixou a execução de 1 TB cerca de 4% mais rápida. Vamos tornar isso o padrão. Desligamos o cache externo de arquivos do DuckDB por causa da carga, não das consultas: depois que o cache encheu, nossa primeira carga de 10 TB ficou lentíssima.
Não precisamos adivinhar nada disso: o GizmoData Cloud nos mostrou. Todo cluster tem uma aba Monitoring com os núcleos de CPU em uso, o throttling de CPU, a memória em relação ao limite do contêiner, a E/S de rede e as reinicializações, e os clusters Hardcharger acrescentam a visão do próprio mecanismo: instruções, latência, sessões, fila e memória do DuckDB. Esta é nossa primeira execução de 1 TB, com 256 threads:
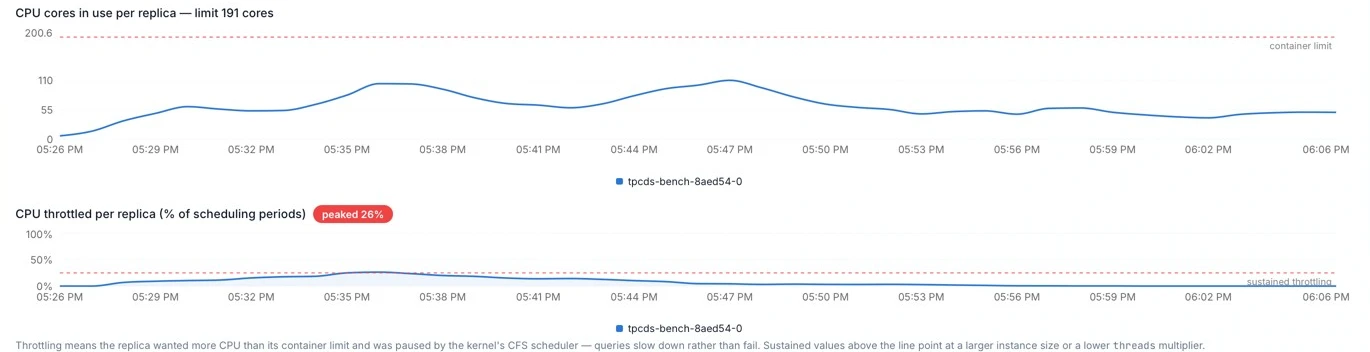
É uma visão que um data warehouse gerenciado não oferece. A MotherDuck mostra o histórico de consultas, os tempos e se um Duckling transbordou para o disco; o Snowflake mostra a carga de consultas do warehouse, o transbordamento e os créditos. A documentação de nenhum dos dois descreve uma forma de ver os núcleos de CPU, o throttling ou a memória da máquina em relação ao limite, então um problema como este pareceria apenas um benchmark mais lento.
Quanto custa
Este cluster custou US$ 30,80 por hora no GizmoData Cloud, sob demanda. A MotherDuck lista o Giga a US$ 24,00 por hora nos EUA, então a hora da MotherDuck é mais barata. A nossa faz mais trabalho em uma hora, porém. Multiplicando cada média geométrica pelo preço por hora, o mesmo trabalho custa cerca de 14% menos no GizmoData Cloud em 1 TB e cerca de 22% menos em 10 TB.
Os planos mensais também são diferentes. O Giga só está disponível no plano Business da MotherDuck, que custa US$ 250 por mês além do uso. No GizmoData Cloud, a mensalidade do plano volta integralmente como crédito de computação. Pense em uma equipe que usa esta máquina 20 horas por mês: na MotherDuck, são US$ 250 mais US$ 480 de tempo de Giga, US$ 730 no total. No plano Business do GizmoData Cloud, são US$ 616 de computação, com a mensalidade de US$ 499 abatida desse valor.
| GizmoData Cloud | MotherDuck Giga | |
|---|---|---|
| Preço por hora | US$ 30,80 | US$ 24,00 |
| Plano mensal | Mensalidade devolvida como crédito de computação | Plano Business, US$ 250 por mês, sem crédito |
| Mesmo trabalho, 1 TB | 14% menos | – |
| Mesmo trabalho, 10 TB | 22% menos | – |
| 20 horas em um mês | US$ 616 | US$ 730 |
Em 10 TB, as melhores execuções a quente das 99 consultas somam 1.517 segundos, ou US$ 12,98 de computação no GizmoData Cloud. Carregar os 10 TB do S3 para o NVMe do cluster levou mais 14 minutos, cerca de US$ 7,32.
Em 1 TB, dá para colocar todos os sistemas em pé de igualdade. O benchmark da Fivetran de 2022 calculou o custo como o tempo médio geométrico multiplicado pelo preço por hora, e usamos a mesma conta para todos: o custo de uma consulta média. Em 1 TB, uma consulta no GizmoData Cloud custa 0,40 centavo de dólar, o menor dos oito e cerca de um décimo dos 3,80 a 6,10 centavos dos data warehouses. Em 10 TB, a única comparação de preço equivalente é com a MotherDuck, em que os dois preços são preços de tabela sob demanda: o mesmo trabalho custa cerca de 22% menos no GizmoData Cloud.
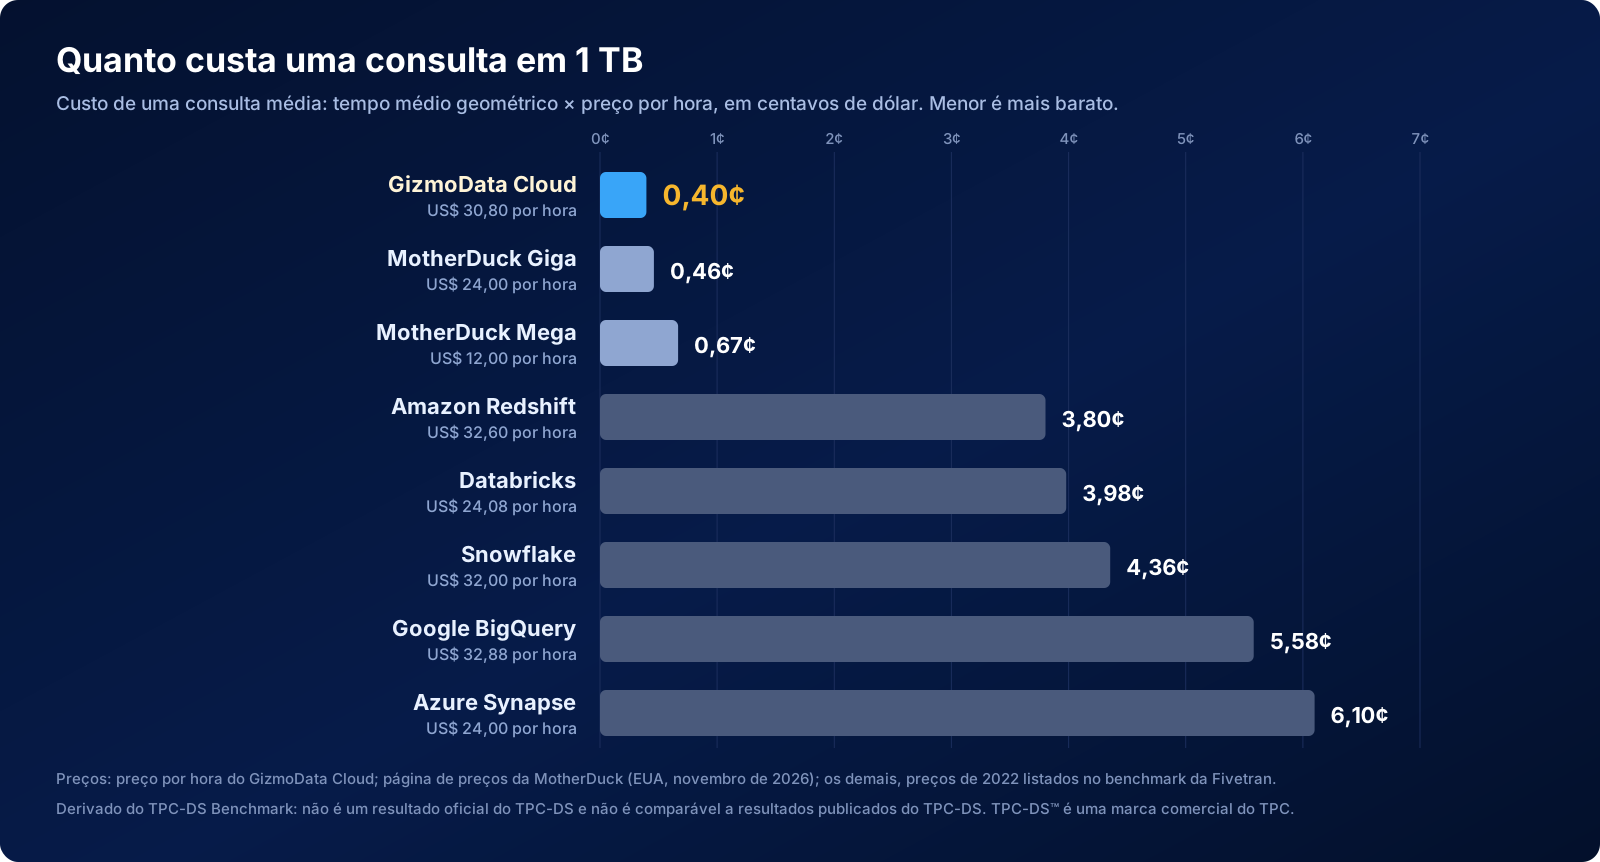
Deixamos os outros fora de um gráfico de preços em 10 TB de propósito. A página da Oracle, fonte dos números de 10 TB deles, calcula o Redshift e o Synapse com preços de instância reservada por um ano e o BigQuery com um compromisso anual de preço fixo, e conta só a computação, com o armazenamento à parte, então esses custos não são comparáveis a um preço por hora sob demanda como o nosso. Os preços de 1 TB são os preços de tabela por hora que a Fivetran publicou em 2022; os preços de nuvem mudaram desde então, então use-os como referência, não como cotação.
Execute o DuckDB 2.0 no hardware mais novo, na sua própria região. Comece gratuitamente com US$ 25 em crédito de lançamento, aplicado automaticamente.
Comece gratuitamente no GizmoData Cloud →Consulta por consulta
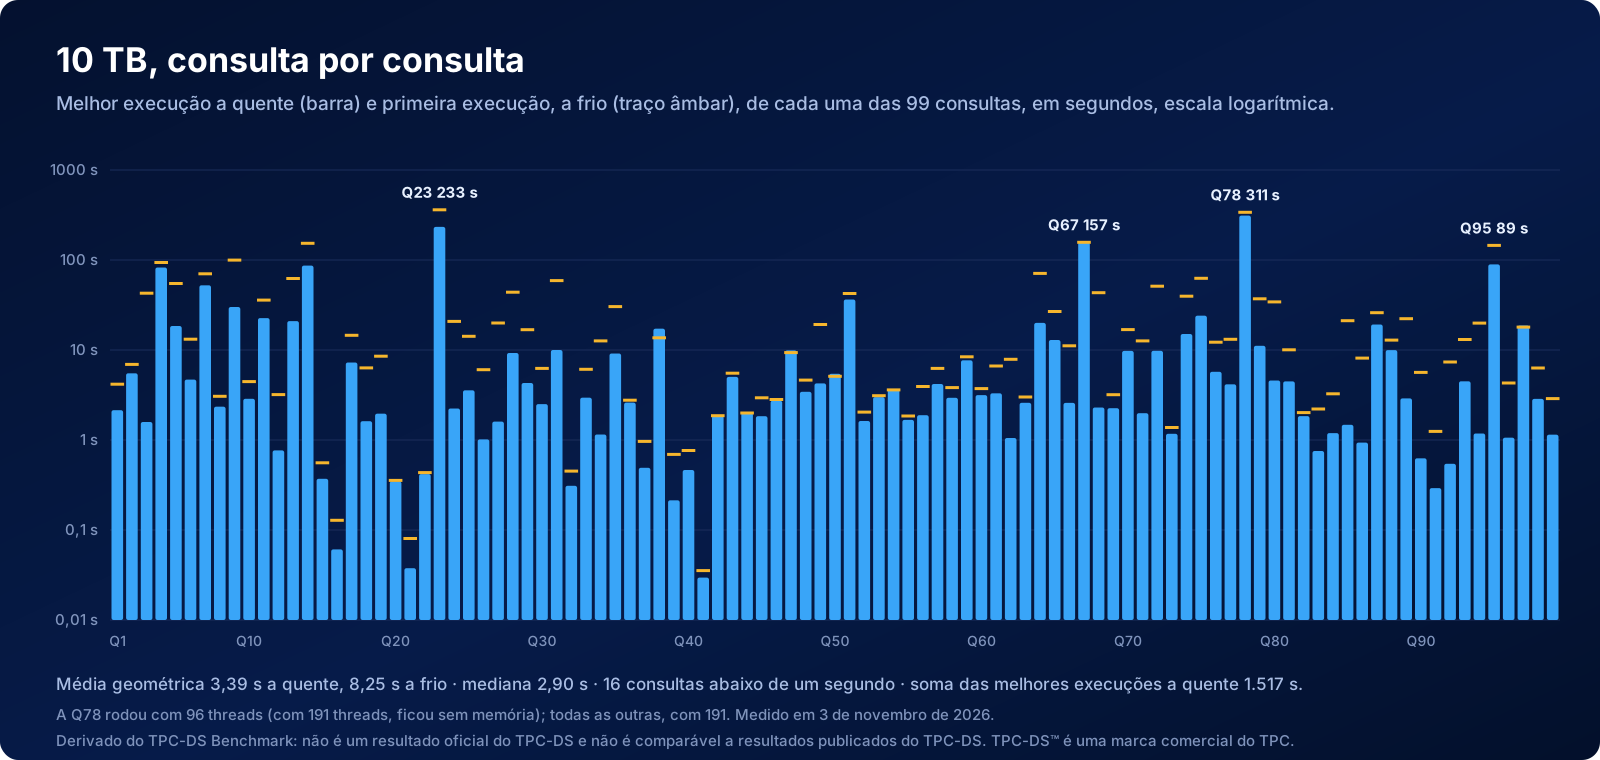
Em 10 TB, a consulta mediana levou 2,9 segundos, e 16 das 99 terminaram em menos de um segundo. Um punhado de consultas pesadas fica com a maior parte do tempo: Q78 (311 segundos), Q23 (233), Q67 (157), Q95 (89), Q14 (87) e Q4 (83). Em 1 TB, a mediana foi de 0,43 segundo, 77 consultas terminaram em menos de um segundo e a mais lenta foi a Q67, com 21,5 segundos.
As ressalvas
- A Q78 em 10 TB rodou com 96 threads. Com 191 threads, ela ficou sem memória dentro do DuckDB (o banco de 10 TB tem cerca de 2,7 TB, então não cabe em 1,5 TB de RAM, e as consultas transbordam para o NVMe). Executada sozinha com 96 threads e as demais configurações iguais, ela levou 339 segundos a frio, depois 343, 323 e 311 segundos, e contamos os 311. A média geométrica das outras 98 consultas, todas com 191 threads, é de 3,23 segundos.
- As execuções a frio são mais lentas. A MotherDuck contou só as execuções a quente, e nós também. Nossa primeira execução, a frio, em 10 TB teve média geométrica de 8,25 segundos, porque os dados foram lidos do NVMe e não da memória. Em 1 TB, foram 0,51 segundo.
- Nosso cliente rodou ao lado do servidor. Ele rodou no mesmo cluster Kubernetes, em outro nó, por HTTP simples. O da MotherDuck rodou em uma máquina EC2 em US East 1. A maioria das consultas retorna 100 linhas ou menos, então a rede acrescenta pouco, mas algumas retornam resultados grandes (a Q64 em 10 TB retorna cerca de 395.000 linhas), e em 1 TB, onde a consulta mediana leva 0,43 segundo, alguns milissegundos de ida e volta por consulta pesam um pouco mais.
- Nossa cópia dos dados precisa ser carregada. O banco DuckDB no NVMe dura só enquanto o cluster existe, então é refeito a cada início: cerca de 4 minutos para 1 TB e 14 minutos para 10 TB. Um banco da MotherDuck permanece entre as sessões. Se você preferir não carregar nada, os mesmos dados estão em um catálogo DuckLake público que qualquer cluster do GizmoData Cloud em AWS US East 2 pode montar sem etapa de carga, embora as consultas no armazenamento de objetos sejam mais lentas que no NVMe local.
- Os dados de 1 TB não são idênticos byte a byte. Geramos 1 TB com o gerador do DuckDB 2.0, e a MotherDuck com o do DuckDB (1.5.6 na época). Os dois usam o gerador de dados TPC-DS do DuckDB, mas a saída das duas versões difere em alguns pontos. Em 10 TB, nós e a MotherDuck usamos os arquivos TPC-DS v2.13 publicados pela Amazon.
- Uma sessão. Cada fator de escala é uma sessão de benchmark em uma noite (de 2 para 3 de novembro de 2026), então alguns pontos percentuais de qualquer diferença são ruído.
Como executamos
- Hardware: uma AWS
r9gd.48xlarge(Graviton5, 192 vCPUs, 1,5 TB de memória, 11 TB de NVMe local em RAID 0), sob demanda, em US East 2, como cluster do GizmoData Cloud. - Mecanismo: Hardcharger 2.4.1 com DuckDB 2.0.0, com as quatro configurações acima. Os arquivos do banco usam o formato de armazenamento do DuckDB 2.0; em 1 TB também executamos com o formato do DuckDB 1.5, que marcou 0,461 segundo, o mesmo dentro do ruído.
- Dados: Parquet com zstd no S3 da mesma região, carregado em um banco DuckDB no NVMe por um script SQL de inicialização quando o cluster sobe. 1 TB veio do gerador TPC-DS do DuckDB 2.0, e 10 TB dos arquivos TPC-DS v2.13 da Amazon.
- Consultas: as 99 consultas da extensão
tpcdsdo DuckDB (tpcds_queries()), sem modificações, o mesmo conjunto que a MotherDuck executou. - Execuções: por consulta, uma execução a frio (que não conta) e depois três a quente; a nota é a melhor execução a quente, cronometrada no cliente desde o envio da consulta até a leitura do resultado Arrow inteiro. O resumo é a média geométrica das 99 notas.
- Preço: o preço por hora do cluster no GizmoData Cloud, US$ 30,80. Os preços da MotherDuck são da sua página de preços em 3 de novembro de 2026, região dos EUA.
Execute você mesmo
Tudo o que usamos está na região AWS US East 2 do GizmoData Cloud. No portal, crie um cluster com uma imagem do Hardcharger, o tamanho r9gd.48xlarge e NVMe local, e escolha o script de inicialização público tpcds_sf10000_nvme_load (ou tpcds_sf1000_nvme_load para 1 TB, que também executa as 99 consultas uma vez para aquecer). O tamanho de 1 TB também cabe em uma máquina menor. A r9gd.48xlarge tem 192 vCPUs, mais que os 128 do plano Business, então fale com a gente para aumentar o limite da sua organização. Quando o script terminar, conecte-se e execute:
SET GLOBAL threads = 191;
SET GLOBAL memory_limit = '1150GiB';
SET GLOBAL preserve_insertion_order = false;

USE tpcds;
PRAGMA tpcds(1);   -- query 1 of the 99; tpcds_queries() lists them all
Para pular a carga, monte o catálogo DuckLake público gizmodata-tpcds-aws-us-east-2, que tem todos os fatores de escala, de sf1 a sf10000.
Resumindo
Se sua equipe paga um data warehouse por crédito, DBU ou byte lido para consultas como essas, a alternativa é esta: uma máquina, DuckDB 2.0, cada consulta respondida em poucos segundos em 10 TB, e uma passada completa pelas 99 consultas por cerca de US$ 13 de computação. O preço por hora aparece na tela antes de você clicar em Create. E esta é só a segunda semana. O DuckDB continua ficando mais rápido, as nuvens continuam lançando chips mais rápidos, e o Hardcharger está só começando.
Achamos que os patos maiores só vão ficar mais rápidos. Comece gratuitamente no GizmoData Cloud e veja por conta própria, ou fale com a gente sobre migrar uma carga de trabalho.
Patos maiores, mais rápidos
Experimente o Hardcharger no GizmoData Cloud
Comece gratuitamente com US$ 25 em crédito de lançamento, aplicado automaticamente. Não é necessário cadastrar cartão de crédito. DuckDB 2.0 nas máquinas mais novas da nuvem, com todos os recursos do Hardcharger incluídos e uma mensalidade que volta para você como computação.
Estes resultados são derivados do TPC-DS Benchmark e não são comparáveis a resultados publicados do TPC-DS Benchmark, pois não seguem a especificação do TPC-DS. TPC-DS™ é uma marca comercial do Transaction Processing Performance Council (TPC). Hardcharger™ e GizmoData™ são marcas comerciais da GizmoData LLC. DuckDB é uma marca comercial da DuckDB Foundation. MotherDuck, Amazon Redshift, Snowflake, Databricks, Google BigQuery, Azure Synapse e MySQL HeatWave são marcas comerciais de seus respectivos proprietários. Os números dos outros sistemas são os publicados por suas fontes; não os executamos.